OpenAI · 训练
OpenAI 发布大规模深度强化学习 Dota 2 研究
OpenAI 公开了一项大规模深度强化学习在 Dota 2 中的应用研究。这项工作展示了 AI 如何通过海量自我对弈和分布式训练,在复杂实时策略游戏中达到顶尖水平。研究不仅涉及算法和工程创新,还探讨了强化学习在长期规划、团队协作等挑战上的突破,为游戏 AI 和通用决策智能提供了重要参考。
- 域名
openai.com- 评分
- 5 · 重大发布
- 发布
- 2026-05-24
导读
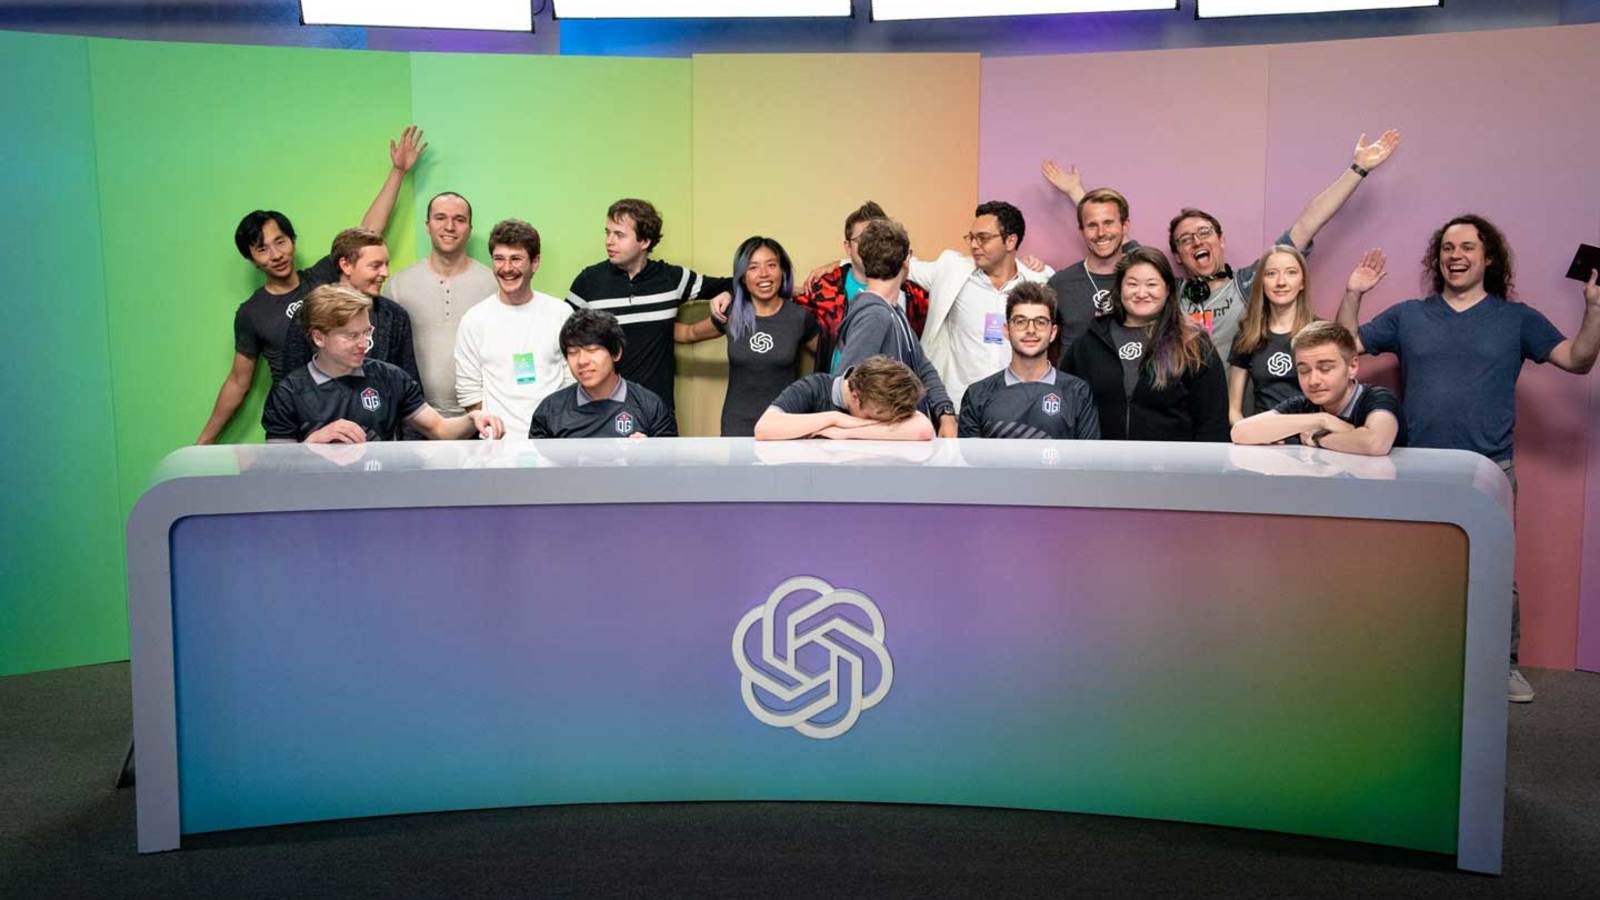
OpenAI Five 是首个在职业电竞项目中击败世界冠军的 AI 系统。论文记录了从 2017 到 2019 两年间的训练过程:2019 年 4 月 13 日,OpenAI Five 在线下赛中以 2:0 战胜 Dota 2 国际邀请赛冠军 OG 战队。Dota 2 对 AI 提出长时序、部分可观测、连续高维动作空间等挑战,单局动辄数万决策步,五个智能体须协同推塔、控线、抢资源。
系统采用近端策略优化加规模化自我对弈作为训练范式,每两秒消化约 200 万帧经验。OpenAI 为此搭建了一套分布式训练基础设施,并开发了 surgery 工具支持持续训练,使得在模型结构、动作空间、英雄池调整后无需推倒重来。整套训练持续约十个月,等效游戏经验相当于人类玩家四万五千年的对局时间。
研究的意义在于证明 self-play 强化学习可以在远超 Atari 与围棋复杂度的任务上达到超人水平。论文对长时序信用分配、团队协同、对手分布迁移等问题的工程化解法,被后续机器人灵巧操作(如解魔方)与多智能体场景沿用,也让"扩大经验规模"成为 RL 系统设计的一条显性主线。