Google AI · 其他
Google AI 发布 AlphaGo 机器学习围棋项目
Google AI 发布了 AlphaGo 机器学习围棋项目,展示了人工智能在围棋领域的突破性进展。该项目基于深度强化学习,使 AlphaGo 能够通过自我对弈不断提升棋力,最终击败人类顶尖棋手。这一成果不仅推动了围棋 AI 的发展,也为机器学习在复杂策略游戏中的应用提供了重要参考。
- 域名
blog.google- 评分
- 5 · 重大发布
- 发布
- 2026-01-07
导读
这篇博客发布于 2016 年 1 月 27 日,是 DeepMind 与 Google 联合宣告 AlphaGo 阶段性成果的官方札记。文章从围棋本身写起:起源于 2500 多年前的中国,被孔子写入文献,是中国古代士人四艺之一,全球玩家超过 4000 万,规则简单到几句话能讲完,却拥有比宇宙原子数还多、比国际象棋多 googol 倍的合法局面数。这种复杂度让基于完整搜索树的传统 AI 方法在围棋面前束手无策,直到 AlphaGo 出现以前,计算机围棋程序的水平只接近业余棋手。
AlphaGo 的做法是把高级蒙特卡洛树搜索与深度神经网络绑在一起。两条网络承担不同任务:policy network 负责选择下一步落子,value network 负责预测胜负。两条网络都有 12 层、上百万个连接,把棋盘描述作为输入。训练过程分两段,先用 3000 万步人类高手的棋谱做监督学习,让模型预测人类下一手的命中率达到 57%,把此前 44% 的纪录拉高一截;随后让网络之间自我对弈数千局,用强化学习去逼近「赢下整盘」这一更高目标,模仿人类一手已经不够用。整个过程依托 Google Cloud Platform 提供算力。
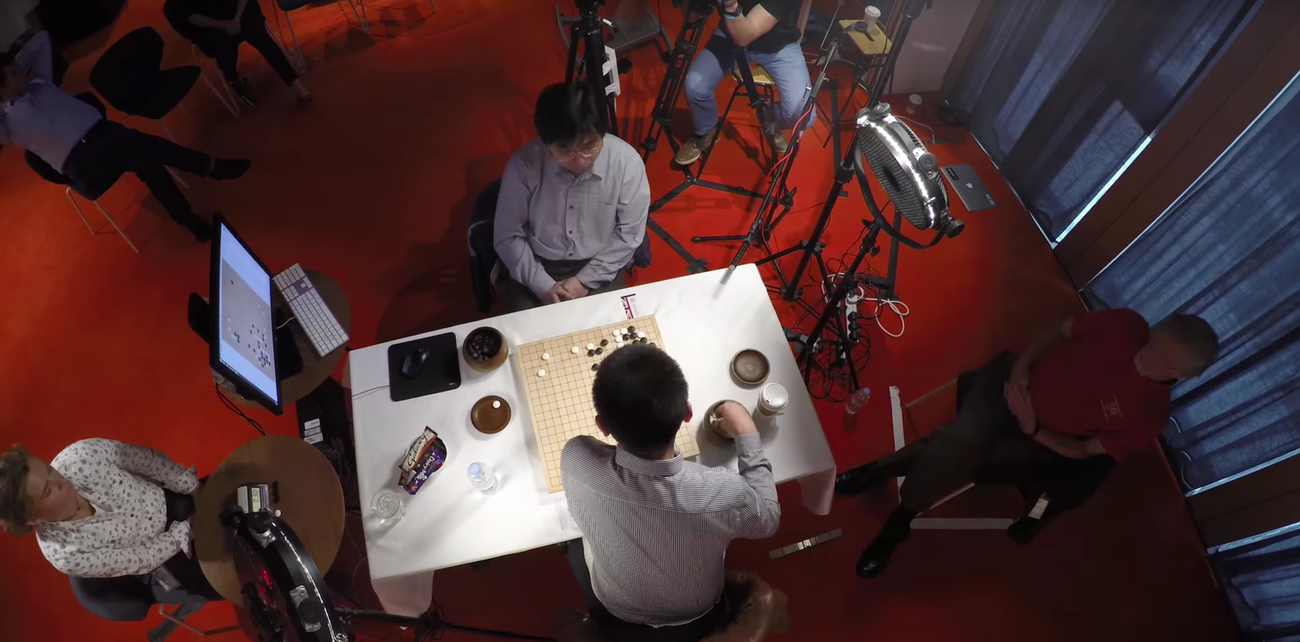
AlphaGo 先在与其他顶级围棋程序的 500 局对决中只输了一盘,随后于上一年 10 月在伦敦闭门赛 5 比 0 击败欧洲冠军、12 岁起从棋的职业棋手樊麾,成为历史上首个在正式比赛中击败职业棋手的围棋程序,相关论文同步发表在《Nature》第 529 卷 7587 期。文章末尾把目光投向接下来 3 月在首尔与李世石的五番棋挑战,并强调 AlphaGo 并未依靠预设规则堆出的专家系统,它用通用机器学习方法自行学会了赢棋。Google 希望这套技术之后能从棋盘走向气候建模、复杂疾病分析等更现实的难题。