NVIDIA · 大模型
NVIDIA 发布 Blackwell Ultra 以更低成本提升 Agentic AI 性能
NVIDIA 推出 Blackwell Ultra,一款面向 agentic AI 工作负载的计算平台。它在提升推理与训练性能的同时降低了部署成本,使企业能够运行复杂的多智能体系统。Blackwell Ultra 是 NVIDIA 在 AI 基础设施领域的又一次迭代,为大规模 agent 应用提供了更经济的算力选择。
- 域名
blogs.nvidia.com- 评分
- 5 · 重大发布
- 发布
- 2026-03-05
导读
NVIDIA 在 2026 年 2 月 16 日发布的这篇博客,把 SemiAnalysis InferenceX 的最新性能数据与 Blackwell Ultra 平台的发布连在一起讨论。背景是 OpenRouter 的 State of Inference 报告:与软件编程相关的 AI 查询份额从一年前的 11% 上升到约 50%,agentic 应用与编码助手正在成为推理流量的主体。这类工作负载对低延迟与长上下文的要求都很高,因为多步工作流里每一毫秒都会累计,而对整个代码库的推理又需要大量上下文窗口。
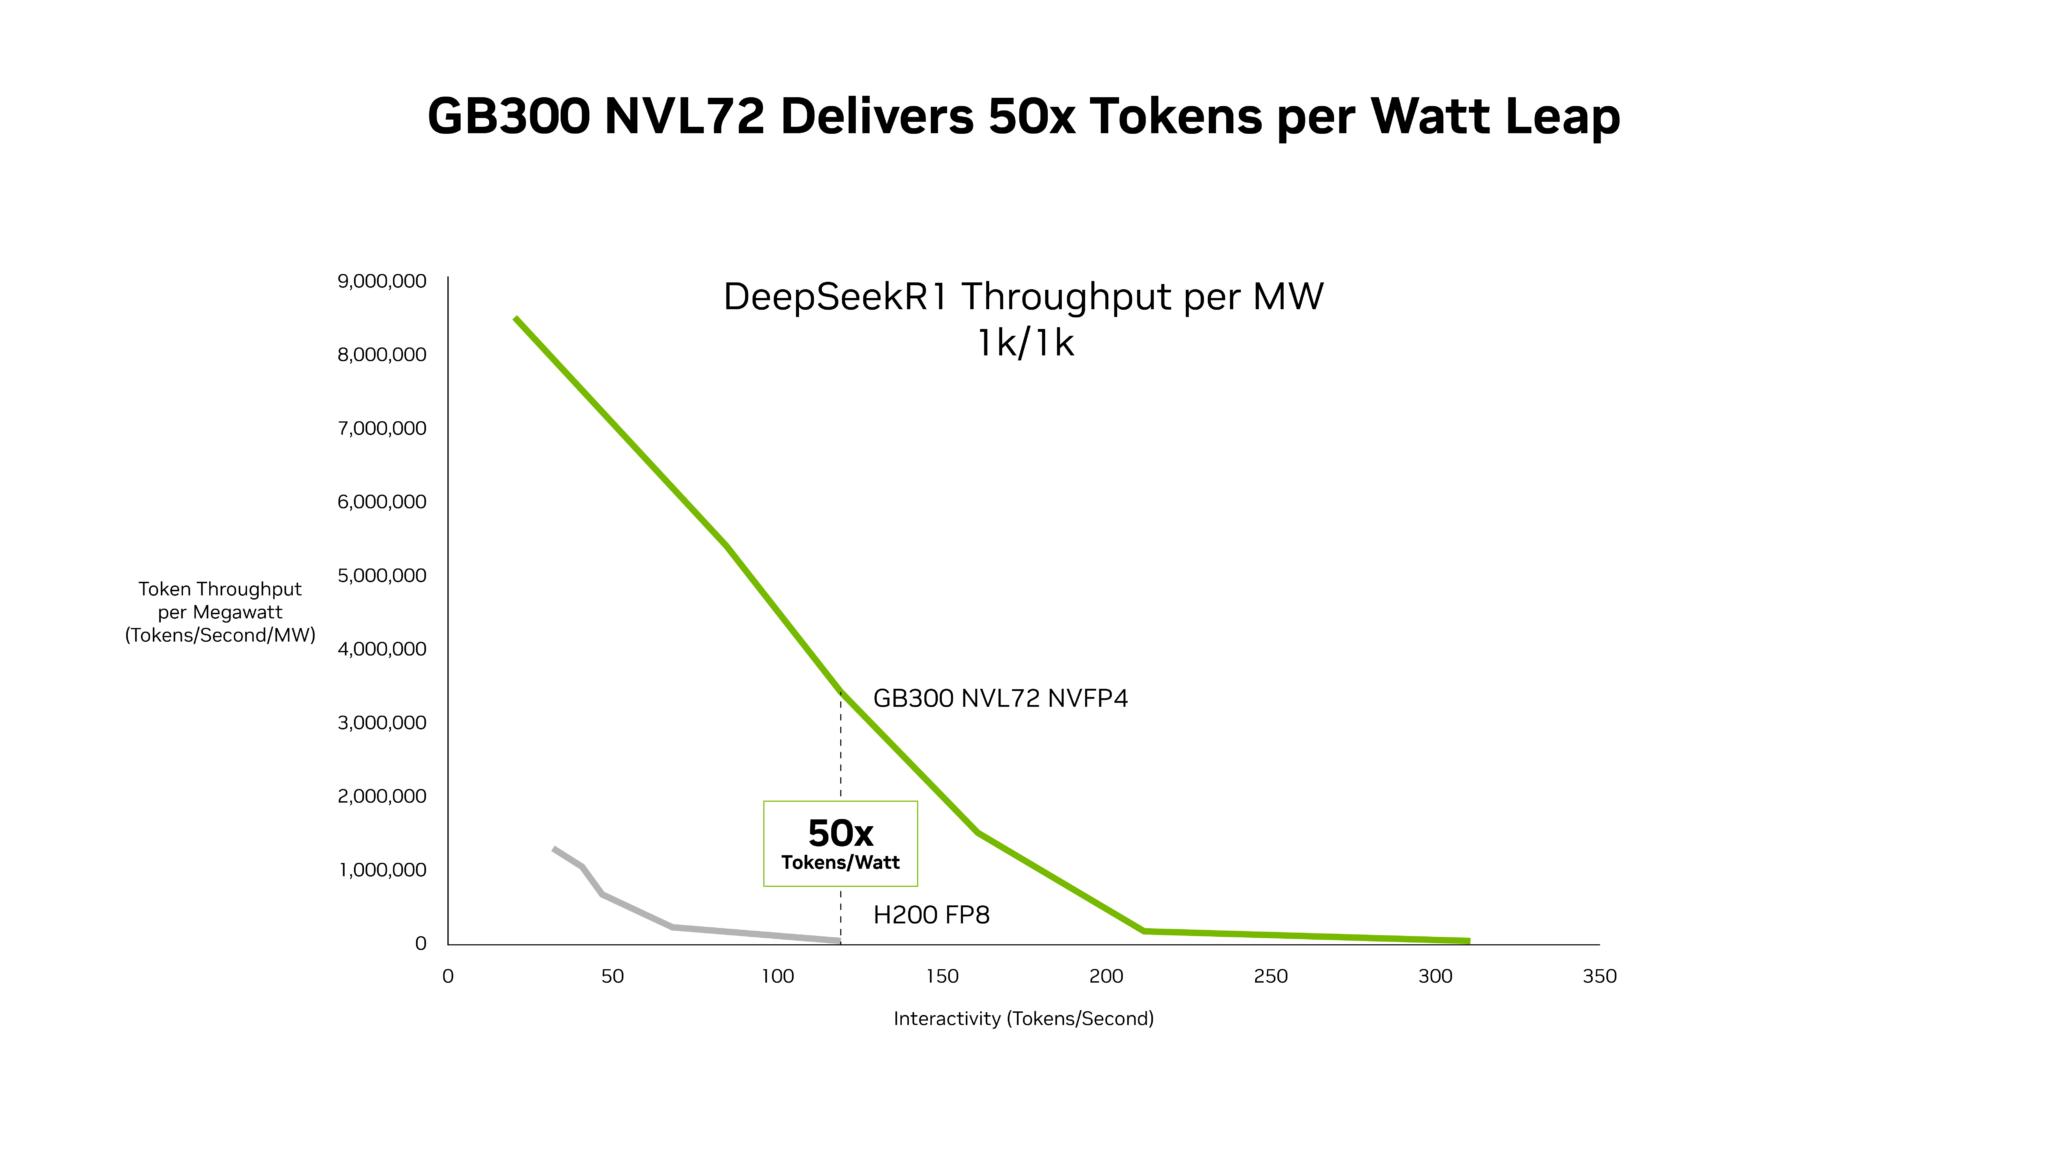
性能数据来自 GB300 NVL72 系统,搭载 Blackwell Ultra GPU。SemiAnalysis 的实测显示,相对 Hopper 平台,GB300 NVL72 在低延迟工作负载下实现了最高 50 倍的每兆瓦吞吐提升,换算为每百万 token 成本下降 35 倍;在 128k token 输入、8k token 输出的长上下文场景里,相对 GB200 NVL72 也能再压低 1.5 倍单 token 成本。这一提升的来源既包含硬件,也来自软硬件协同:TensorRT-LLM 在过去四个月内通过新一代 GPU 内核、NVLink 对称内存、可编程依赖启动等优化,把 GB200 在低延迟下的性能再提高至多 5 倍;Dynamo、Mooncake、SGLang 等 MoE 推理栈共同协作。Blackwell Ultra 在 NVFP4 精度下还提供 1.5 倍计算性能与 2 倍的 attention 处理速度,专门照顾长上下文推理。
对采用方而言,Microsoft Azure、CoreWeave、OCI 已经在生产环境部署 GB300 NVL72,用于 agentic coding 与编码助手类工作。CoreWeave 工程高级副总裁 Chen Goldberg 在文中表示,长上下文性能与 token 效率正在变成推理的关键变量,GB300 直接面向这一挑战。文章末尾把视线投向下一代 Vera Rubin NVL72:相对 Blackwell,它把 MoE 推理的每兆瓦吞吐再提高 10 倍,训练大型 MoE 模型所需的 GPU 数量缩到四分之一,预示 token 经济的曲线还会继续下行。