NVIDIA · 大模型
NVIDIA 发布 Cuda X 架构,支持 Grace Hopper 与 Blackwell 平台
NVIDIA 正式发布 Cuda X 架构,新架构针对 Grace Hopper 超级芯片与 Blackwell 架构 GPU 做了优化,在 AI 训练与推理场景中可提供更高吞吐量。Cuda X 的编程模型也进行了升级,降低了开发者编写高性能加速代码的门槛,同时增强了稀疏计算与长序列模型的处理能力。
- 域名
blogs.nvidia.com- 评分
- 5 · 重大发布
- 发布
- 2025-12-23
导读
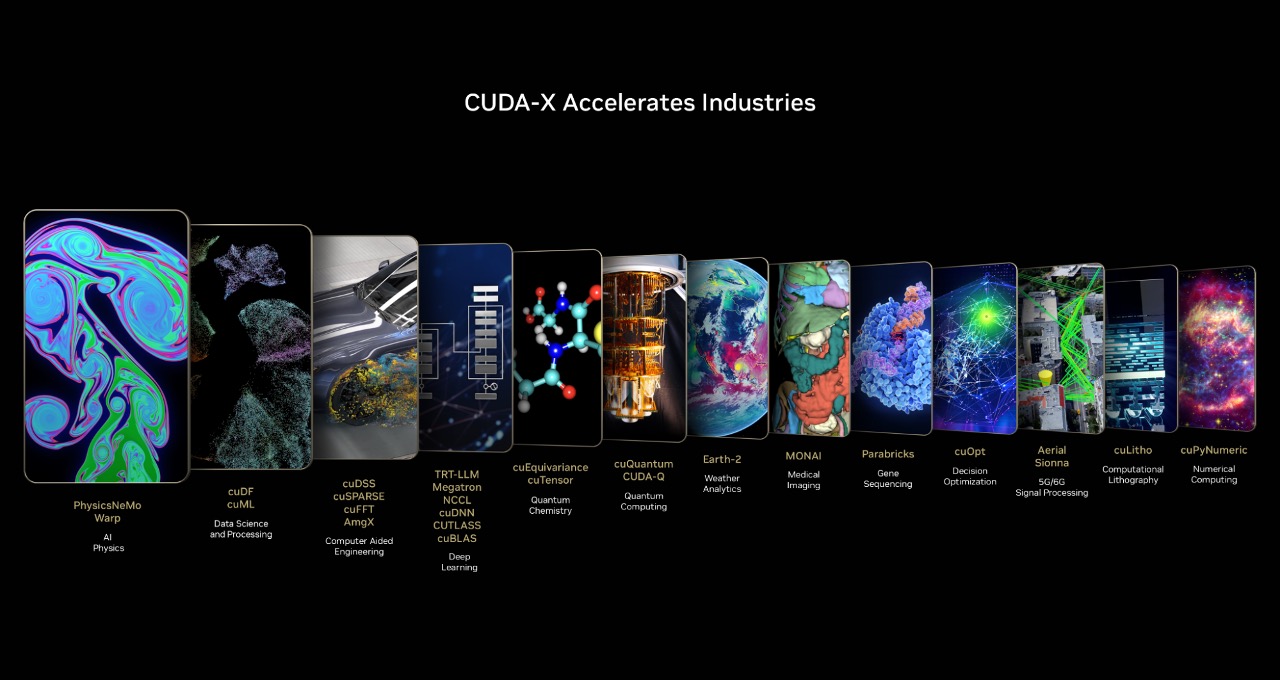
NVIDIA 这篇博客把 CUDA-X 库与 GH200 Grace Hopper、GB200 Grace Blackwell 超级芯片放在一起讨论,主题是工程与科学计算的加速。核心发现来自 cuDSS 这类稀疏直接求解器:把 GPU 与 Grace CPU 之间的内存做成相干共享,让数据无需频繁搬运,最重的求解步骤在同一颗 GPU 上可以再提速最高 4 倍。Ansys HFSS 已将 cuDSS 集成到电磁仿真求解器,矩阵求解阶段加速最高 11 倍;Altair OptiStruct 则借助同一套库加速有限元分析。
超级芯片架构的价值同样体现在内存敏感型应用。GB200 与 GH200 通过 NVLink-C2C 在 CPU 与 GPU 之间提供相干互联,使得 out-of-core 求解器可以无缝读写 CPU 内存,把单 GPU 能处理的工程问题规模显著放大。这一设计直接回应飞机发动机一类复杂部件设计中遇到的瓶颈:单一 GPU 显存无法容纳所需分辨率的仿真数据,而超级芯片把 Grace CPU 内存编织进同一空间后,工程师可以处理远超传统 GPU 内存上限的算例。
量子计算模拟是文章给出的另一条主线。Tensor network 与 state vector 两种主流方法都受限于矩阵或向量在内存中的规模,GB200 与 GH200 让大块 CPU 内存能够被 GPU 直接使用,从而支持几百到上千 qubit 的关键算法验证。文中给出的对照基准是:GH200 在量子模拟基准上相对 H100 配 x86 的系统再快 3 倍。CUDA-X 在此扮演的角色,是把这套硬件优势翻译成科研工程团队可以直接调用的库 API。