OpenAI · 图像模型
OpenAI 发布 DALL·E 3
OpenAI 正式推出 DALL·E 3,这是其最新一代文生图模型。相比前代,DALL·E 3 在图像细节、语义理解与风格多样性上均有显著提升,能够更精准地将自然语言描述转化为高质量图像。该模型已集成至 ChatGPT 平台,用户可通过对话方式迭代生成与编辑图像,降低了创意设计的门槛。
- 域名
openai.com- 评分
- 5 · 重大发布
- 发布
- 2026-04-22
导读
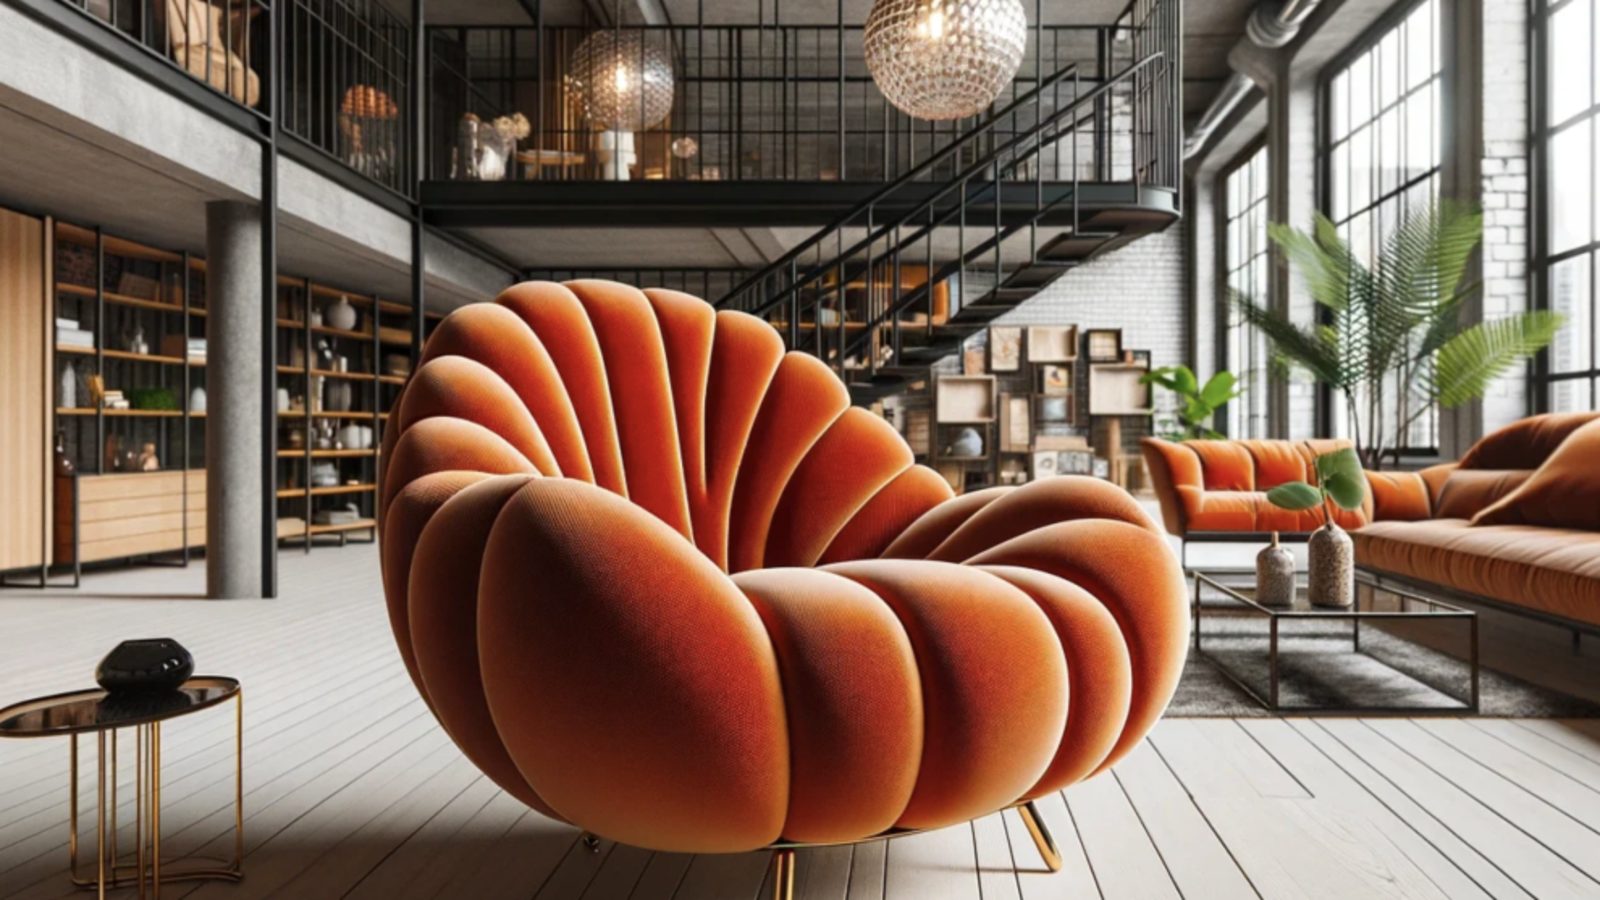
DALL·E 3 是 OpenAI 推出的文生图模型,定位是解决前代以及多数文本到图像系统的一项顽疾:模型常常忽略提示词中的关键描述,逼迫使用者依靠 prompt engineering 反复调教措辞。OpenAI 在介绍页指出,DALL·E 3 在严格遵循文本输入这一点上有跨代提升,画面要素与原始描述之间的对齐度大幅提高。模型原生构建在 ChatGPT 之上,让用户可以在对话里把 ChatGPT 当作头脑风暴与 prompt 精修工具:给出一句话或一段描述,ChatGPT 会自动生成针对 DALL·E 3 的详细 prompt,对效果不满意时再用几个词追加调整即可。
在安全与版权两条线上,DALL·E 3 引入多重缓解措施。模型默认拒绝按姓名生成公众人物图像,并在 red team 协助下加强了关于公众人物、视觉上的过度/不足代表性、宣传与误导信息等风险领域的表现。模型同时被设计为拒绝模仿在世艺术家风格的请求,创作者可以为自己的图像申请退出未来图像生成模型的训练。生成图像归用户所有,转载、销售或商业化无需 OpenAI 许可,这条版权政策延续自 DALL·E 2。
OpenAI 还在内部研究 provenance classifier,这是一种用于识别图像是否由 DALL·E 3 生成的工具,目标是让团队更好理解生成图像的使用方式。DALL·E 3 在发布时同步开放给所有 ChatGPT 用户与 API 开发者,背后的核心研究团队包括 Gabriel Goh、James Betker、Li Jing、Aditya Ramesh 等人,论文以 PDF 形式公开。