第 1 章到第 9 章把 13 项 BCG 试验在所有主流 meta 分析方法上各跑了一遍,本章把这些结果汇总,回答两个问题:方法之间结论的一致与分歧告诉了我们什么?统计意义上的合并估计如何翻译成临床决策的证据等级?
全书方法终极对比
把九种方法的合并 RR 与 95% CI 放进一张全景图。
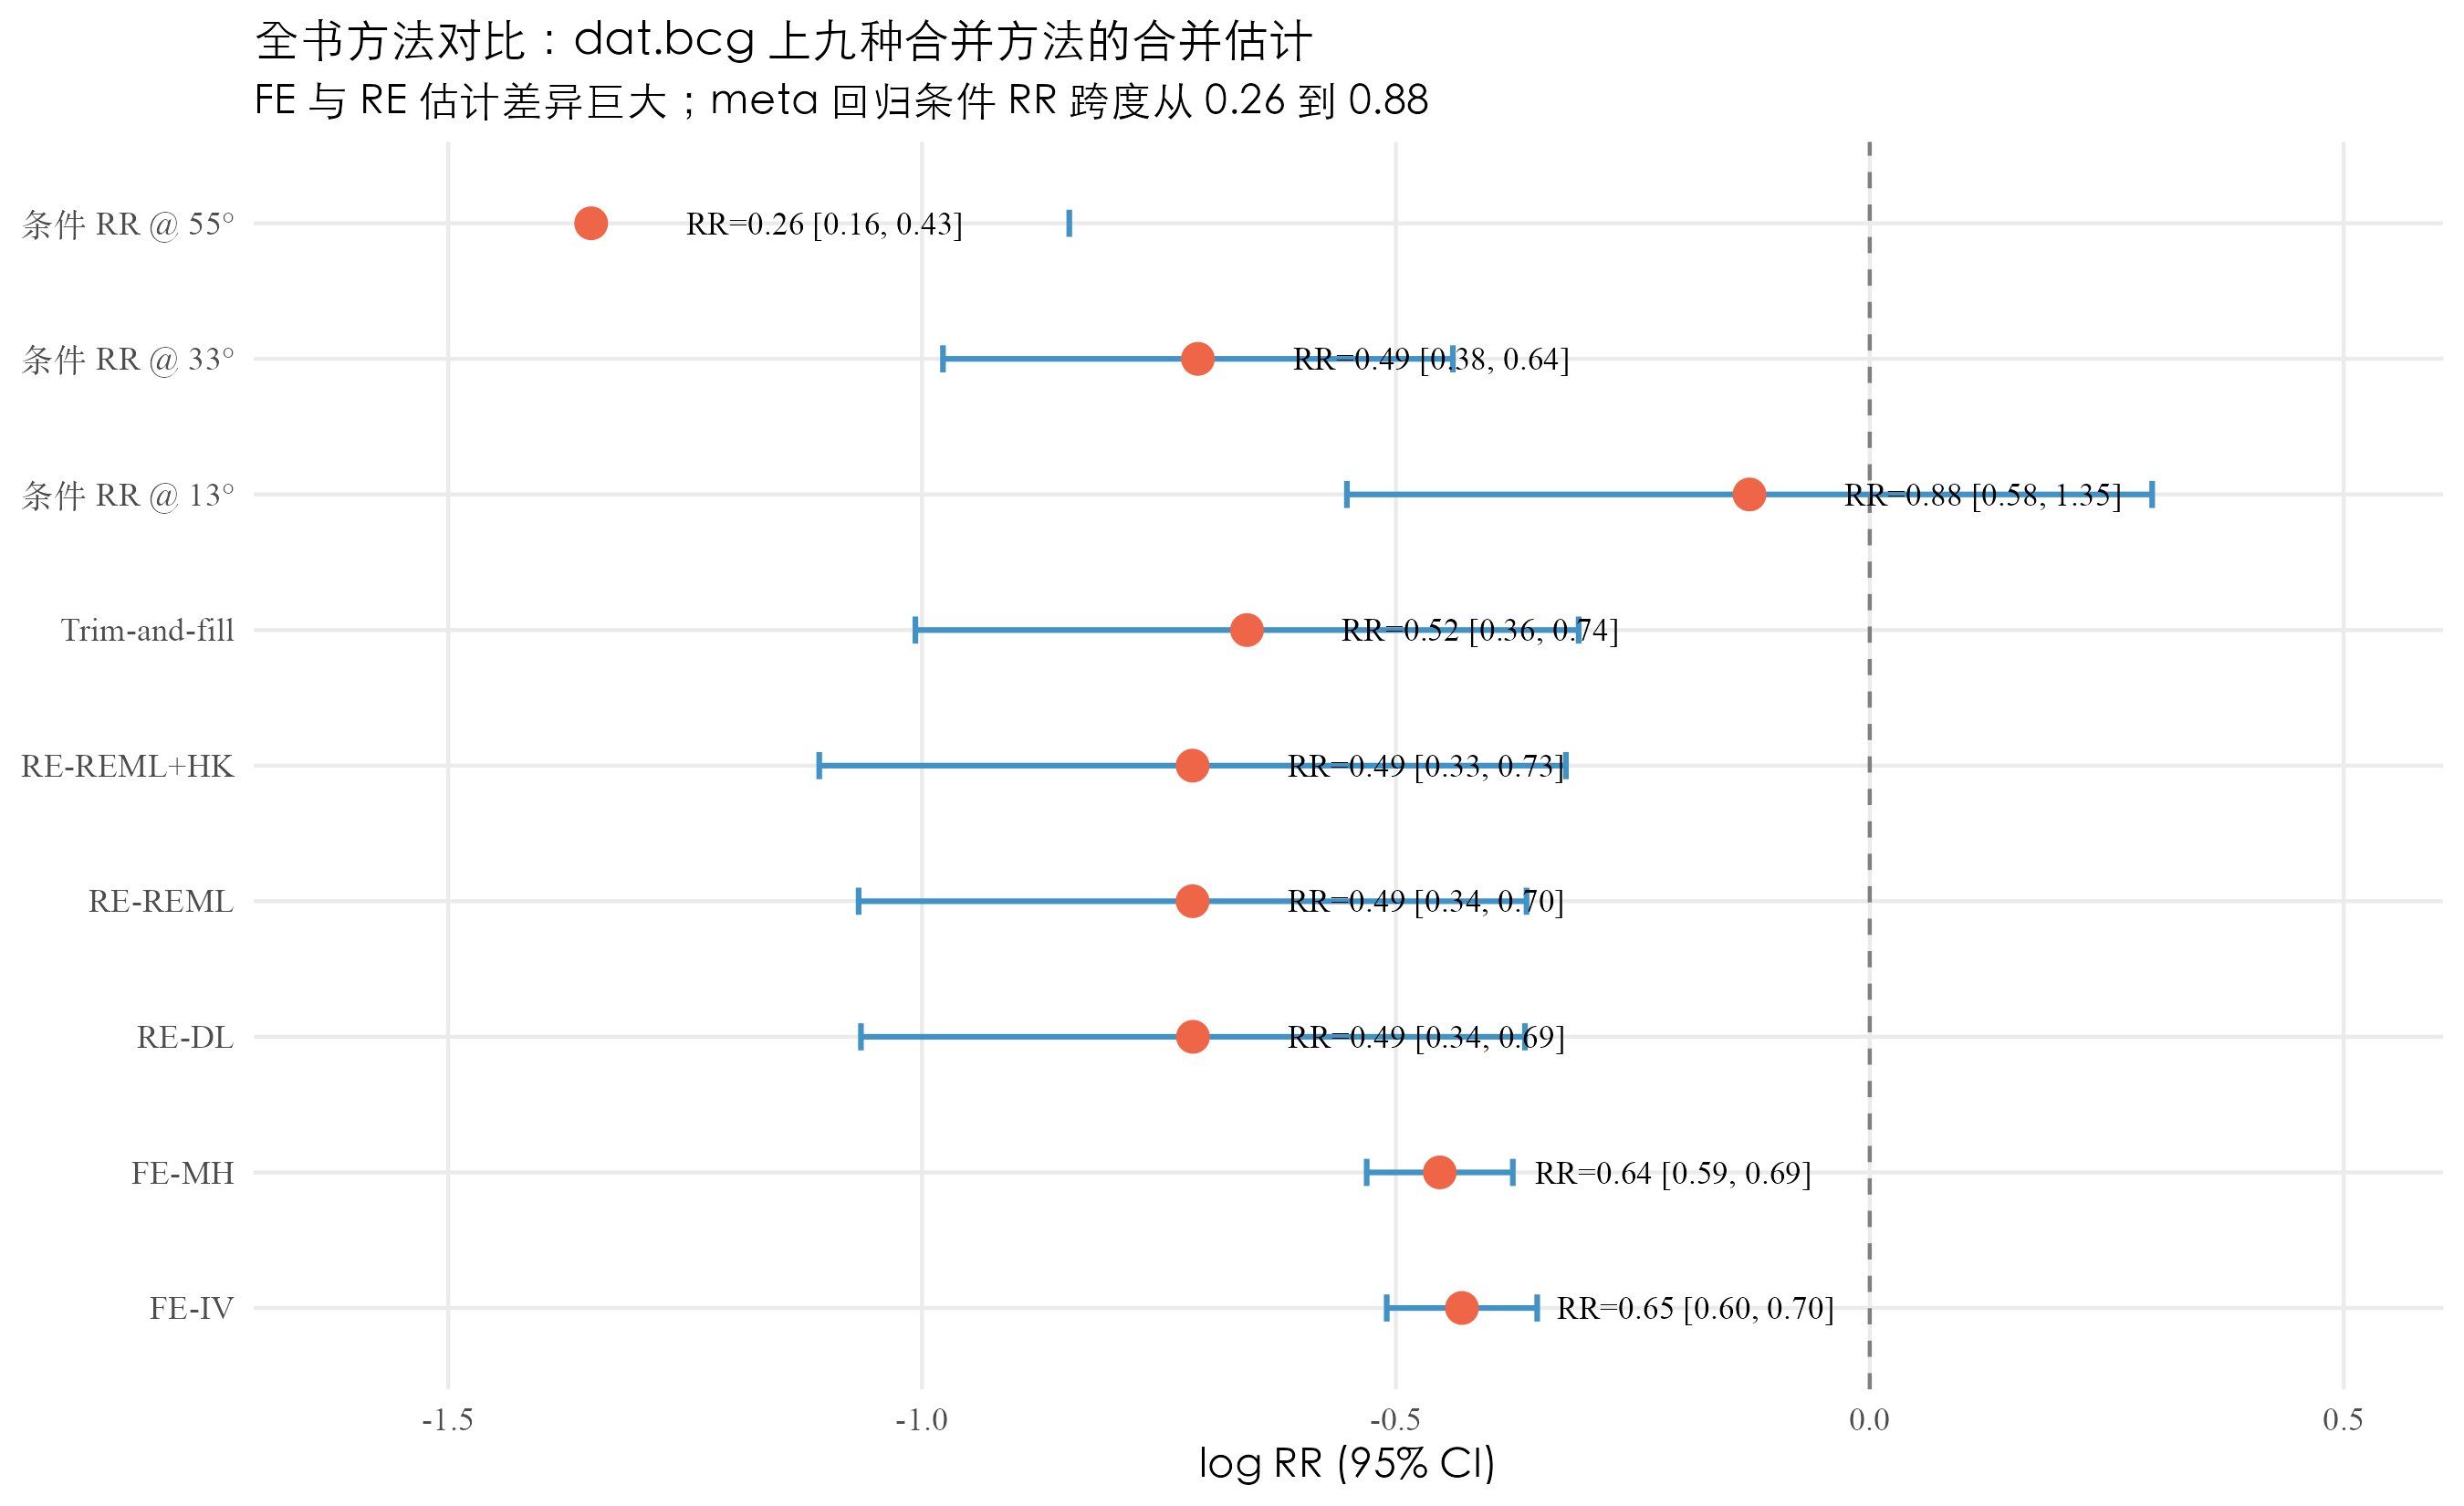
结论的一致与分歧
读这张对比图能看到三层信息。第一层,所有方法都给出 BCG 有保护作用的结论:合并 RR 全部小于 1,CI 的上界(除去 13° 条件 RR 跨过 1 之外)也都小于 1。方向上 meta 分析的结论稳健。
第二层,FE 与 RE 估计在数值上相差甚远。FE-IV 给出 ,看起来 BCG 把风险降低 35%;RE-REML+HK 给出 ,看起来 BCG 把风险降低 51%。差异源自第 4 章和第 5 章讲过的机制:FE 模型让大样本研究主导(TPT Madras 占 41% 权重),把合并均值拉向 ;RE 模型把权重摊平,让中小样本研究的强保护信号有更大发言权。 的现实下,RE 估计是更负责任的报告选择。
第三层,meta 回归的条件 RR 跨度极大:赤道附近 (CI 跨过 1),中纬度 0.49,高纬度 0.26。这意味着所谓"全球平均 RR "是个不可对应到任何具体人群的合并均值。临床决策应当基于"在我所在地区的条件 RR",不是"全球平均 RR"。本章讨论 GRADE 时会回到这一点。
表 10·1 dat.bcg 全书方法终极对比
| 方法 | logRR | RR | 95% CI | 适用场景 |
|---|---|---|---|---|
| 朴素合并 | 0.61 | — | 不推荐,仅作对比基线 | |
| FE-IV | 0.65 | (0.60, 0.70) | 异质性低()时 | |
| FE-MH | 0.64 | (0.59, 0.69) | 同 FE-IV,稀疏事件更稳健 | |
| RE-DL | 0.49 | (0.35, 0.70) | 历史经典选择 | |
| RE-REML | 0.49 | (0.34, 0.70) | 现代默认选择 | |
| RE-REML+HK | 0.49 | (0.33, 0.73) | Cochrane 推荐主分析 | |
| Trim-and-fill | 0.52 | (0.37, 0.74) | 发表偏倚校正 | |
| 条件 RR @ 13° | 0.88 | (0.58, 1.35) | 赤道地区临床推广 | |
| 条件 RR @ 33° | 0.49 | (0.38, 0.64) | 中纬度临床推广 | |
| 条件 RR @ 55° | 0.26 | (0.16, 0.43) | 高纬度临床推广 |
该报告哪一个?
实务上 meta 分析论文必须选定一个"主结果"在摘要里报告,配合敏感性分析作支撑。本数据的主结果选择遵循三条标准:异质性 显著,必须用随机效应;研究数 落在小样本区间,REML 比 DL 偏倚小且 HK 调整对小样本更稳健;异质性能被纬度解释 75.6%,meta 回归的条件 RR 比单一合并均值更有临床意义。综合下来,主结果应当是 RE-REML+HK 给出的全球均值 (95% CI 0.33–0.73),配合 meta 回归报告在不同纬度下的条件 RR。这是 Cochrane Handbook 与 PRISMA 报告规范的标准格式。
GRADE 证据等级框架
统计估计回答的是"数据告诉了我们什么"。临床决策还要回答"我们应该多大程度上相信这个结论"。Grading of Recommendations Assessment, Development and Evaluation 框架,简称 GRADE,是把 meta 分析的统计估计翻译成临床证据等级的事实标准。
GRADE 把证据等级分为四档:高()、中()、低()、极低()。RCT meta 分析起点为高。从高开始,按五个降级因素(偏倚风险、不一致性、间接性、不精确性、发表偏倚)逐项评估,每命中一项可降一级。也存在三个升级因素(大效应、剂量反应、混杂会减弱观测效应),但通常只用于观察研究。
五个降级因素在 dat.bcg 上的评估
偏倚风险(Risk of Bias):13 项研究中 7 项标准随机化,2 项交替分配,4 项系统分配。后两类是准随机方法,按 Cochrane RoB 2 工具的"随机化过程"域评估属于"有些担忧"或"高风险"。整体而言 BCG 数据的偏倚风险中等偏高,应当降一级。
不一致性(Inconsistency):,,预测区间 跨过 1。异质性极强,应当降一级。第 7 章已经用纬度解释掉 75.6%,剩余 仍然不可忽略。如果按"分层后再评级"的做法,可以分别报告高/中/低纬度的证据等级,每一层内的异质性可能小很多。
间接性(Indirectness):13 项研究的人群以白人为主(早期欧美研究)+ 南亚(TPT Madras)+ 北美土著(Aronson、Stein-Aronson)。BCG 株系也不完全统一(部分研究用法国 Pasteur 株,部分用丹麦 Copenhagen 株)。结局都是结核病发病,但定义略有差异(部分仅肺结核,部分含肺外结核)。整体间接性中等,是否降级取决于读者关心的具体临床问题。
不精确性(Imprecision):合并 RR 的 95% CI ,区间排除了 (无效),也排除了 (弱保护)。结论"BCG 有显著保护作用"在统计意义上精确。不降级。
发表偏倚(Publication Bias):第 8 章给出 Egger 、Begg 、trim-and-fill 仅填补 1 项。但 让所有检验功效不足。保守起见可以认为发表偏倚证据不强,不降级,但报告时应当注明检验功效有限。
综合评级
从 RCT 的"高"起点,命中两条降级因素(偏倚风险一级、不一致性一级),最终证据等级为低()。临床决策上,BCG 对结核的保护效应在全球平均尺度上"低等级证据支持",但在分层后的高纬度亚组(),证据等级可以提升到中等。
表 10·2 dat.bcg 的 GRADE 评级
| 因素 | 降级 | 依据 |
|---|---|---|
| 起点 | 高 | 13 项 RCT meta 分析 |
| 偏倚风险 | 6 项准随机分配,按 RoB 2 偏倚风险中等偏高 | |
| 不一致性 | ,PI 跨零线 | |
| 间接性 | 0 | 人群与株系有差异但与目标问题相关 |
| 不精确性 | 0 | 95% CI 排除无效与弱保护 |
| 发表偏倚 | 0 | 检验不显著但 功效有限 |
| 最终等级 | 低() |
GRADE 评级最常见的误用是把统计显著当成"高证据等级"。BCG 数据合并 RR 的 95% CI 排除了 1,统计上是"显著有效",但 GRADE 评级仍然只有"低"。统计显著只对应不精确性这一项不降级,偏倚风险与不一致性两项已经把等级压到低。临床读者看到 就直接相信结论的做法是不分级的危险简化。GRADE 的价值在于把"统计显著"与"临床可信"分成两件事独立评估。
时代局限与证据更新
dat.bcg 的 13 项研究全部完成于 1948–1980 年。70 多年过去,结核病学、疫苗学、流行病学方法学都发生了巨大变化。本数据集作为教学样本极其经典,但作为"今天该不该打 BCG"的政策依据,已经过时。现代 BCG 证据来自三个新方向:
第一,对原始 RCT 的长期随访延展。Hart & Sutherland 在 BMJ 1977 之后又有多次随访更新,最长追踪到接种 60 年后。结论是 BCG 的保护效应随接种后时间逐渐减弱,但在前 10–15 年仍然显著。
第二,IPD(个体患者数据)meta 分析重新分析原始数据。Mangtani 2014(BMJ)对部分 BCG 试验做了 IPD-MA,能调整年龄、随访时间等个体协变量,得到比聚合数据 meta 分析更精细的估计。
第三,BCG 与新型结核疫苗的对比。M72/AS01E 等新疫苗在 2018–2024 年间陆续报告 II/III 期试验结果。Meta 分析的更新版本会把 BCG 与新疫苗的对比纳入证据体系,回答"BCG 是否仍是首选"的政策问题。
这本书用 dat.bcg 作为教学数据集是为了让 meta 分析方法的演练有一份完整、干净、临床故事性强的数据。读者掌握了本书的方法之后,可以把同一套工具应用到任何当代的系统综述上。
终结对比表
表 10·3 dat.bcg 全书方法终极对比表
| 方法 | logRR | RR (95% CI) | 说明 | |
|---|---|---|---|---|
| 朴素合并 | 0.61 | — | 不调整研究层级,反例基线 | |
| FE-IV | 0.65 (0.60, 0.70) | 0 | 假设违反() | |
| FE-MH | 0.64 (0.59, 0.69) | 0 | 同 FE-IV,稀疏稳健 | |
| RE-DL | 0.49 (0.35, 0.70) | 0.309 | 矩估计 | |
| RE-REML | 0.49 (0.34, 0.70) | 0.313 | 似然估计 | |
| RE-REML+HK | 0.49 (0.33, 0.73) | 0.313 | 主分析(推荐) | |
| Trim-and-fill | 0.52 (0.37, 0.74) | — | 填补 1 项,结论稳健 | |
| LOO 范围 | — | 0.45–0.53 | — | 全部不跨 1,结论稳健 |
| Meta 回归(ablat) | — | 13°: 0.88; 33°: 0.49; 55°: 0.26 | 0.076 | ,临床推广首选 |
| GRADE 等级 | 低() |
全书到这里收束。从第 1 章 13 项试验答案矛盾的图景,走到第 10 章 GRADE "低"等级的临床证据评级,主线是清晰的:朴素合并失败 FE 模型按精度发言但 假设违反 RE 模型承认研究本来就不一样 异质性诊断量化研究间方差 纬度解释了 75.6% 的差异 发表偏倚检验未拒绝原假设 敏感性分析支持稳健性 GRADE 综合评级为低。
读者掌握了这一套工具之后,可以把它应用到任何当代的系统综述上。换一份数据、换一个临床问题,方法学骨架不变。这正是 meta 分析作为一种"对证据的统计整理"的核心价值。