第 7 章用纬度解释了 75.6% 的研究间异质性,但 meta 分析的可信度还有一道关,纳入分析的 13 项研究本身可能就是有偏的子集。如果阴性结果或小样本无显著结果的研究系统性地不被发表,meta 分析的"原料"就被预先过滤过,合并估计会偏向显著方向。这种偏倚叫发表偏倚,英文称 publication bias,是 meta 分析最难完全控制的偏倚类型。
发表偏倚的产生机制
发表偏倚的根源是学术发表的筛选过程。期刊编辑、审稿人、作者本人都倾向于发表"有发现"的研究:阴性结果的研究投稿成功率明显低于阳性结果,作者本身也更可能把阴性结果归档而不投稿(这种现象叫 file drawer problem)。结果是 meta 分析能检索到的研究池里,阴性结果系统性地少于真实存在的数量。
当研究是否发表与研究结果(效应方向、统计显著性)相关时,文献库里的研究集合对真实研究总体不再是随机样本。系统综述检索到的子集就成为一个有偏样本,meta 分析的合并估计因此向"显著"或"阳性"方向偏移。识别与校正发表偏倚的核心工具是漏斗图及其相关检验。
漏斗图
漏斗图把每项研究画成一个点,横轴是效应估计,纵轴是研究的精度(通常用标准误 或 表示,纵轴反向使大研究在上、小研究在下)。在没有发表偏倚的理想情况下,所有研究的点应当围绕真实效应对称分布,形状像一个倒置的漏斗:精度高的大研究散布窄,集中在漏斗顶端;精度低的小研究散布宽,铺开在漏斗底部。
设真实效应为 。每项研究的估计 在 周围按 分布。精度 越高,分布越窄。在 两侧 的边界就是 95% 散布带,画在精度 vs 效应坐标系上形成两条向漏斗顶端汇聚的斜线。所有研究应落在这两条斜线包围的漏斗内。
发表偏倚的视觉特征是漏斗一侧(通常是阴性结果一侧)小研究系统性缺失。BCG 数据的漏斗图给出第一道诊断。
re <- rma(yi, vi, data = es, method = "REML", test = "knha")
funnel(re,
       xlab    = "log Risk Ratio",
       atransf = exp,
       at      = log(c(0.05, 0.25, 1, 4)),
       refline = re$beta,
       label   = "out")
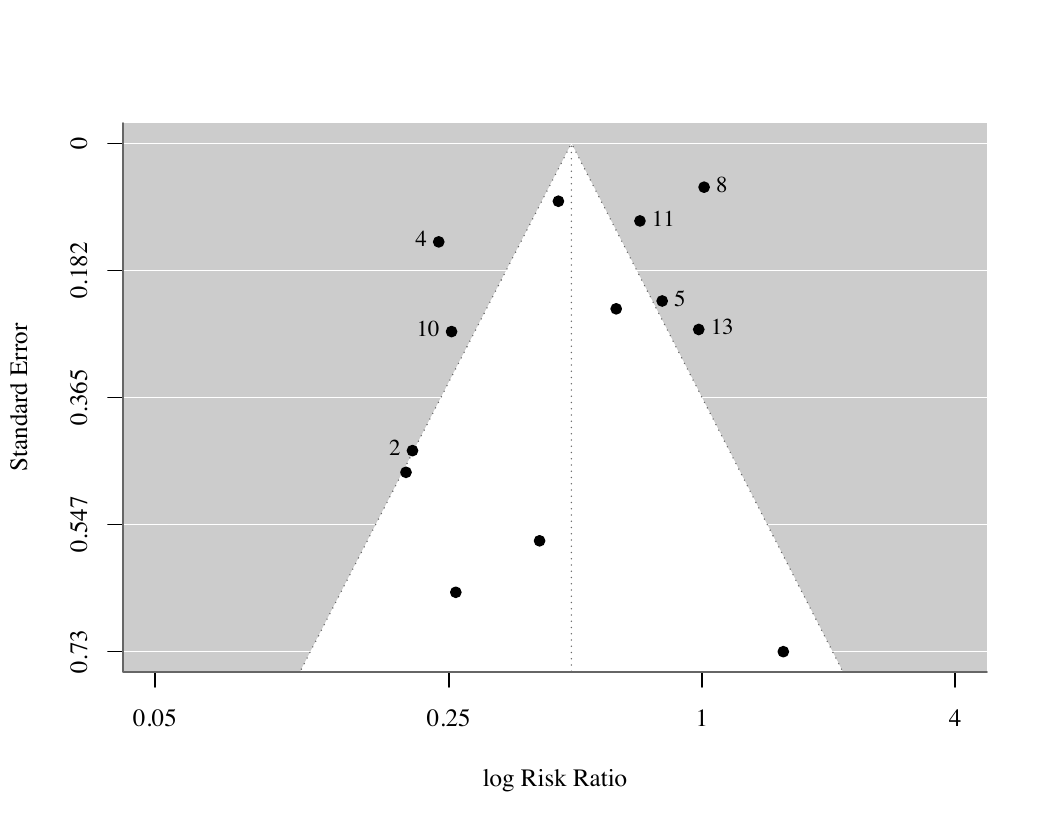
Contour-enhanced 漏斗图
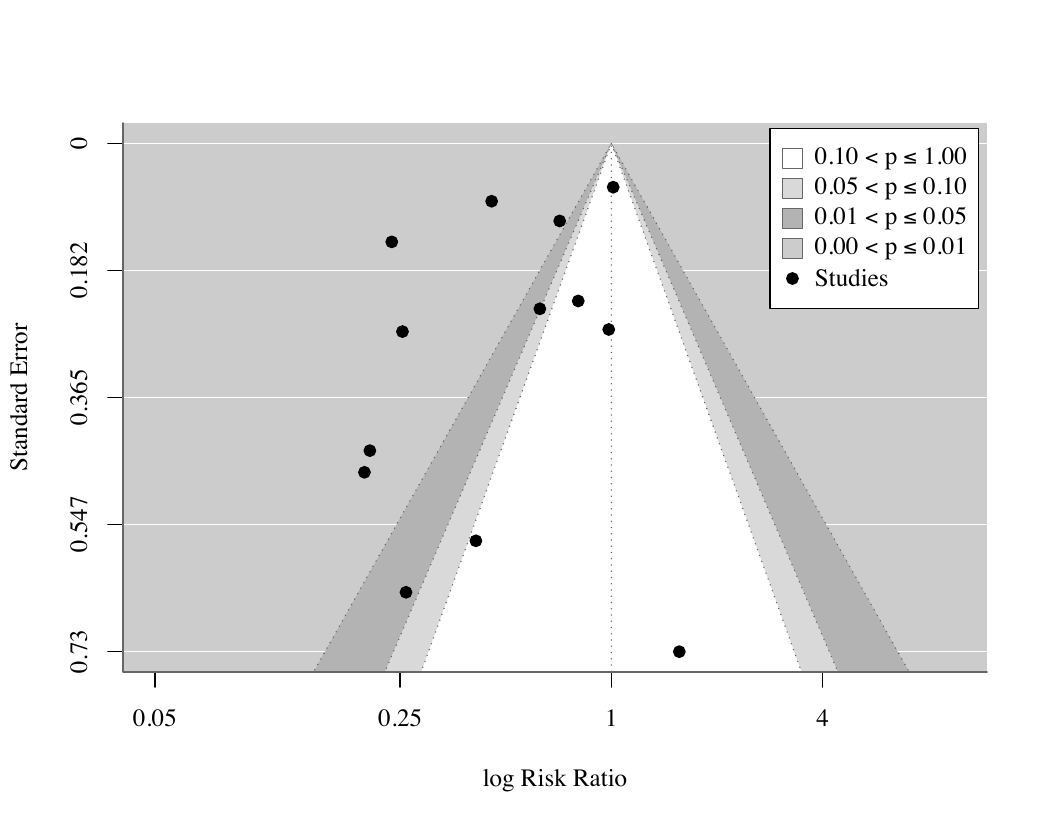
标准漏斗图只看分布形状,无法区分"漏斗一侧缺失是因为发表偏倚还是因为该侧本就没有研究"。Peters 2008 提出 contour-enhanced 漏斗图:在图上用阴影标注不同显著性区域(、、),便于判断缺失的研究是否落在"显著区"还是"非显著区"。
funnel(re,
       level    = c(90, 95, 99),
       shade    = c("white", "gray85", "gray70"),
       refline  = 0,
       atransf  = exp,
       legend   = TRUE)
Egger 回归检验
视觉判断有主观性,需要客观的统计检验。Egger 1997 把"漏斗图对称性"翻译成一个回归检验:把每项研究的 standardized effect()对精度()做线性回归,截距应当为零(如果分布对称)。截距显著偏离零就提示不对称。
对每项研究计算 与 ,拟合 。原假设 (漏斗对称); 显著不为零提示发表偏倚。检验统计量为 的 统计量,自由度 。
egger <- regtest(re, model = "lm")
print(egger)
BCG 数据上 Egger 检验给出 ,,。在 水平下不能拒绝漏斗对称的原假设。"limit estimate as " 给出极小研究的预期效应估计 ()。如果存在严重发表偏倚,这个 limit estimate 会显著小于合并估计;这里 limit 比合并 小但 CI 跨过零,证据不足以指控发表偏倚。
Egger 检验在小研究数下功效低。 时 Egger 的功效大约只有 30%–40%,意味着即使存在中度发表偏倚也可能漏报。Cochrane Handbook 推荐 才做 Egger 检验,本数据刚好在阈值线上,结论"无显著证据"应解读为"证据不足",不能解读为"无偏倚"。
Begg 秩相关检验
Begg & Mazumdar 1994 提出另一种思路:用秩相关代替线性回归。对每项研究的标准化效应与方差排序,计算 Kendall's 。 显著不为零提示效应大小与精度相关,间接提示不对称。
对每项研究的标准化效应 (其中 是 Begg 修正方差)与方差 计算 Kendall's 。原假设 ; 显著不为零提示发表偏倚。
Begg 检验比 Egger 检验对极端值更稳健,但功效更低。Cochrane Handbook 推荐两个检验都报,相互验证。
begg <- ranktest(re)
print(begg)
BCG 数据上 Begg 检验给出 Kendall's ,。这个 值远高于显著性阈值,与 Egger 检验的结论方向一致:没有发表偏倚的统计证据。Begg 与 Egger 双重检验都不显著,给临床读者的信号是"BCG meta 分析没有可识别的强发表偏倚"。但 这个样本规模本身就让两种检验功效不足,结论的严谨表述是"证据不足以指控偏倚",不是"证明没有偏倚"。
Trim-and-fill 校正
Egger 与 Begg 是诊断检验,不直接给出"如果存在偏倚,校正后的合并估计是多少"的答案。Duval & Tweedie 2000 提出了 trim-and-fill 算法:假设漏斗图缺失的研究是"真实但未发表"的研究,按对称镜像把它们填补回去,重新合并。
算法分两步。trim 步:从合并估计两侧识别"明显异常"的研究(贡献最多不对称的研究),临时移除这些研究重新计算合并估计。fill 步:以新合并估计为对称中心,把 trim 步移除的研究镜像填回到对侧。最终合并估计是包含所有原始研究与镜像填补研究的加权平均。metafor 通过 trimfill 函数实现。
tf <- trimfill(re)
print(tf)
Trim-and-fill 估计 BCG 数据右侧缺失 1 项研究()。填补一项后合并 ,,95% CI 。与未校正的合并 相比,保护效应略弱,但临床意义上几乎一致。
这个结果的解读必须谨慎。trim-and-fill 假设漏斗图所有不对称都来自发表偏倚,把异质性、方法学差异等其他不对称源都计入"缺失研究"。BCG 数据的 说明异质性极强,trim-and-fill 估计的"1 项缺失"很可能是真实异质性的镜像偏差,而非真实的发表偏倚。
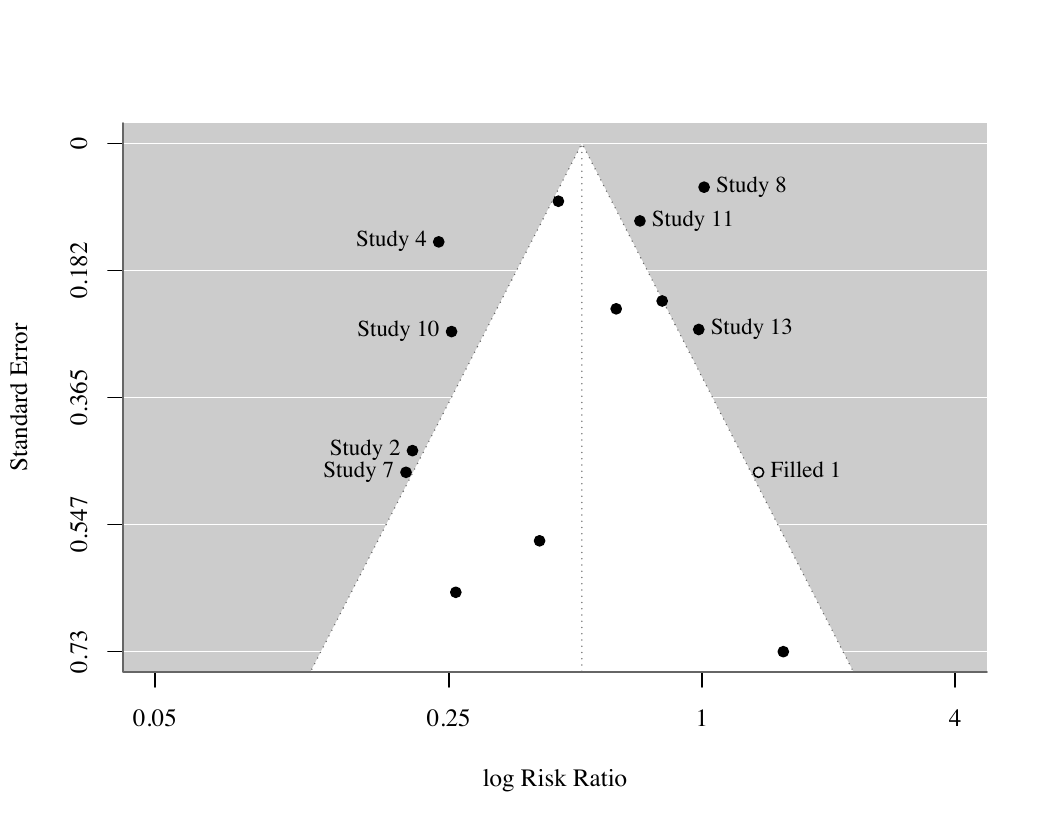
漏斗图不对称的解读是 meta 分析最容易过度推断的环节。不对称的可能来源至少有四类:发表偏倚(阴性结果不发表);真实异质性(小样本研究恰好在某个特殊亚组里,与大样本研究估的不是同一效应);方法学差异(小样本研究质量低、随机化不严,效应估计偏倚);偶然( 小时随机散布看起来不对称)。把所有不对称都归因于发表偏倚是 trim-and-fill 的内在假设,但临床现实里这四类来源经常并存。诊断方法是配合 contour-enhanced 漏斗图、子集分析、对小样本研究做单独的方法学评估,逐一排除其他来源后再下"发表偏倚"的结论。
发表偏倚不显著但仍要警惕的场景
BCG 数据上 Egger、Begg 都不显著,trim-and-fill 仅填补 1 项,从统计指标看"没有强发表偏倚"。但这个结论有两个限定。第一, 让所有检验功效不足,"未拒绝原假设"不是"接受原假设"。第二,BCG 数据是 1948–1980 年间的早期 RCT,那个年代发表偏倚的强度可能不像现代医学文献那样有系统性研究——很多 1950 年代的 BCG 阴性结果可能根本没有进入文献库(即使作者愿意投稿,期刊体系也未建立完整)。所谓"漏斗对称"只能说"在已知文献库内对称"。
回到本数据。 本书把 BCG 当作教学数据,结论"无强发表偏倚证据"足够支撑后续章节的合并分析继续进行。如果是真做政策决策的系统综述,应当配合灰色文献检索(会议摘要、技术报告、试验注册库 ClinicalTrials.gov)补全研究池,再重新评估漏斗对称性。
第 8 章到这里收束。Egger 与 Begg 检验在 BCG 数据上都不显著,trim-and-fill 仅填补 1 项研究,校正后合并 从 变到 ,临床意义上几乎一致。但 的检验功效有限,结论的严谨表述是"证据不足以指控偏倚",不是"证明没有偏倚"。
第 9 章接着查另一个稳健性问题:如果去掉 13 项研究里的某一项,主结论是否还成立?这是敏感性分析。