第 4 章给出 FE-IV 模型的合并 RR=0.65,但 I2=92% 表明 13 项研究并不在估同一个真实效应。本章松开"同一个真实效应"这条假设,把研究间的真实差异用一个新的方差参数 τ2 估计出来。BCG 数据是异质性显著的典型案例,随机效应模型给出的合并结果与 FE 差异巨大,是 meta 分析教学的标准范例。
从固定效应到随机效应
固定效应模型假设 y^i=θ+εi,所有研究共享同一个真实效应 θ。随机效应模型把这个假设松开:每项研究自己有一个真实效应 θi,13 个 θi 不再要求相等,而是从一个总体分布里抽出来的。
y^i=θi+εi,θi∼N(μ,τ2),εi∼N(0,vi).其中 y^i 是第 i 项研究的 log RR 估计,θi 是第 i 项研究的真实效应(每项研究自己一个),μ 是平均真实效应(meta 分析合并的目标)。εi 是抽样误差,方差 vi;θi 自身的分布方差是 τ2,叫研究间方差。τ2=0 时模型退化为固定效应。
把 τ2 翻译成生活语言。假设 13 项 BCG 试验各自的真实效应分别是 θ1,θ2,…,θ13。固定效应模型说这 13 个数都相等(共有一个 θ);随机效应模型说这 13 个数不相等,但围绕一个总体均值 μ 分布,分布的宽度就是 τ。BCG 数据里,伦敦 Hart & Sutherland 1977 的真实效应可能是 log RR=−1.4,赤道附近 TPT Madras 1980 的真实效应可能是 0,二者本来就不一样。τ2 把这种本来就有的差异量化出来,让合并 CI 老老实实变宽。
随机效应模型的权重
随机效应模型的权重也按方差倒数计算,但方差包含两部分:研究内的抽样方差 vi 和研究间的真实方差 τ2。
RE 模型下每项研究的权重为
wiRE=vi+τ21.其中 vi 是第 i 项研究自身的抽样方差(同 FE),τ2 是研究间真实效应的方差。合并估计 μ^=∑iwiREy^i/∑iwiRE,方差 Var(μ^)=1/∑iwiRE。
把 τ2 加进权重的分母会带来两个直接后果。其中一个:所有研究的权重都比 FE 模型小,因为分母变大了,导致合并 CI 比 FE 宽。另一个:原本权重悬殊的研究权重被"摊平"。FE 模型下 TPT Madras 一项就占 41%,到 RE 模型下这个比例会显著缩水,因为 τ2 把它的相对优势削弱了。
DerSimonian-Laird 估计量
τ2 不是直接观测的,必须从数据里估计。DerSimonian & Laird 1986 提出了最早也是最常用的 τ2 矩估计量。
τ^DL2=max{0, ∑iwi−∑iwi2/∑iwiQ−(k−1)}.其中 Q 是异质性 Q 统计量(第 4 章给出)、k 是研究数、wi=1/vi 是 FE 模型下的逆方差权重。分子 Q−(k−1) 是观察 Q 超出"在 FE 假设下应有期望 k−1"的部分,分母把这个超额量还原到 log RR 平方尺度。如果 Q≤k−1(异质性弱于纯抽样波动),τ2 截断为零。
在 BCG 数据上手算一遍。先把第 4 章给出的 13 项研究 IV 权重 wi=1/vi 全部累加:∑wi=609.70。再算 ∑wi2=94,820.58,所以 ∑wi2/∑wi=94,820.58/609.70=155.52。DL 公式分母 ∑wi−∑wi2/∑wi=609.70−155.52=454.18。Q 已经在第 4 章算出 Q=152.23,自由度 k−1=12,分子 Q−12=140.23。代入:
τ^DL2=454.18140.23=0.3088.
分子 140.23 是观察到的研究间散布超出抽样波动的部分,分母 454.18 是把这个超额量还原到 log RR 平方尺度的换算因子。
library(metafor)
d  <- read.csv("data/bcg.csv")
es <- escalc(measure = "RR", ai = tpos, bi = tneg,
             ci = cpos, di = cneg, data = d)

# 手算 DL τ² 的中间量
w       <- 1 / es$vi
sum_w   <- sum(w)              # 609.70
sum_w2  <- sum(w^2)            # 94820.58
denom   <- sum_w - sum_w2 / sum_w   # 454.18
Q       <- rma(yi, vi, data = es, method = "EE")$QE   # 152.23
tau2_DL <- (Q - 12) / denom
cat("tau^2 (DL, 手算) =", round(tau2_DL, 4), "\n")

# DerSimonian-Laird τ² 估计(与手算应当一致)
re_dl <- rma(yi, vi, data = es, method = "DL")
print(re_dl)
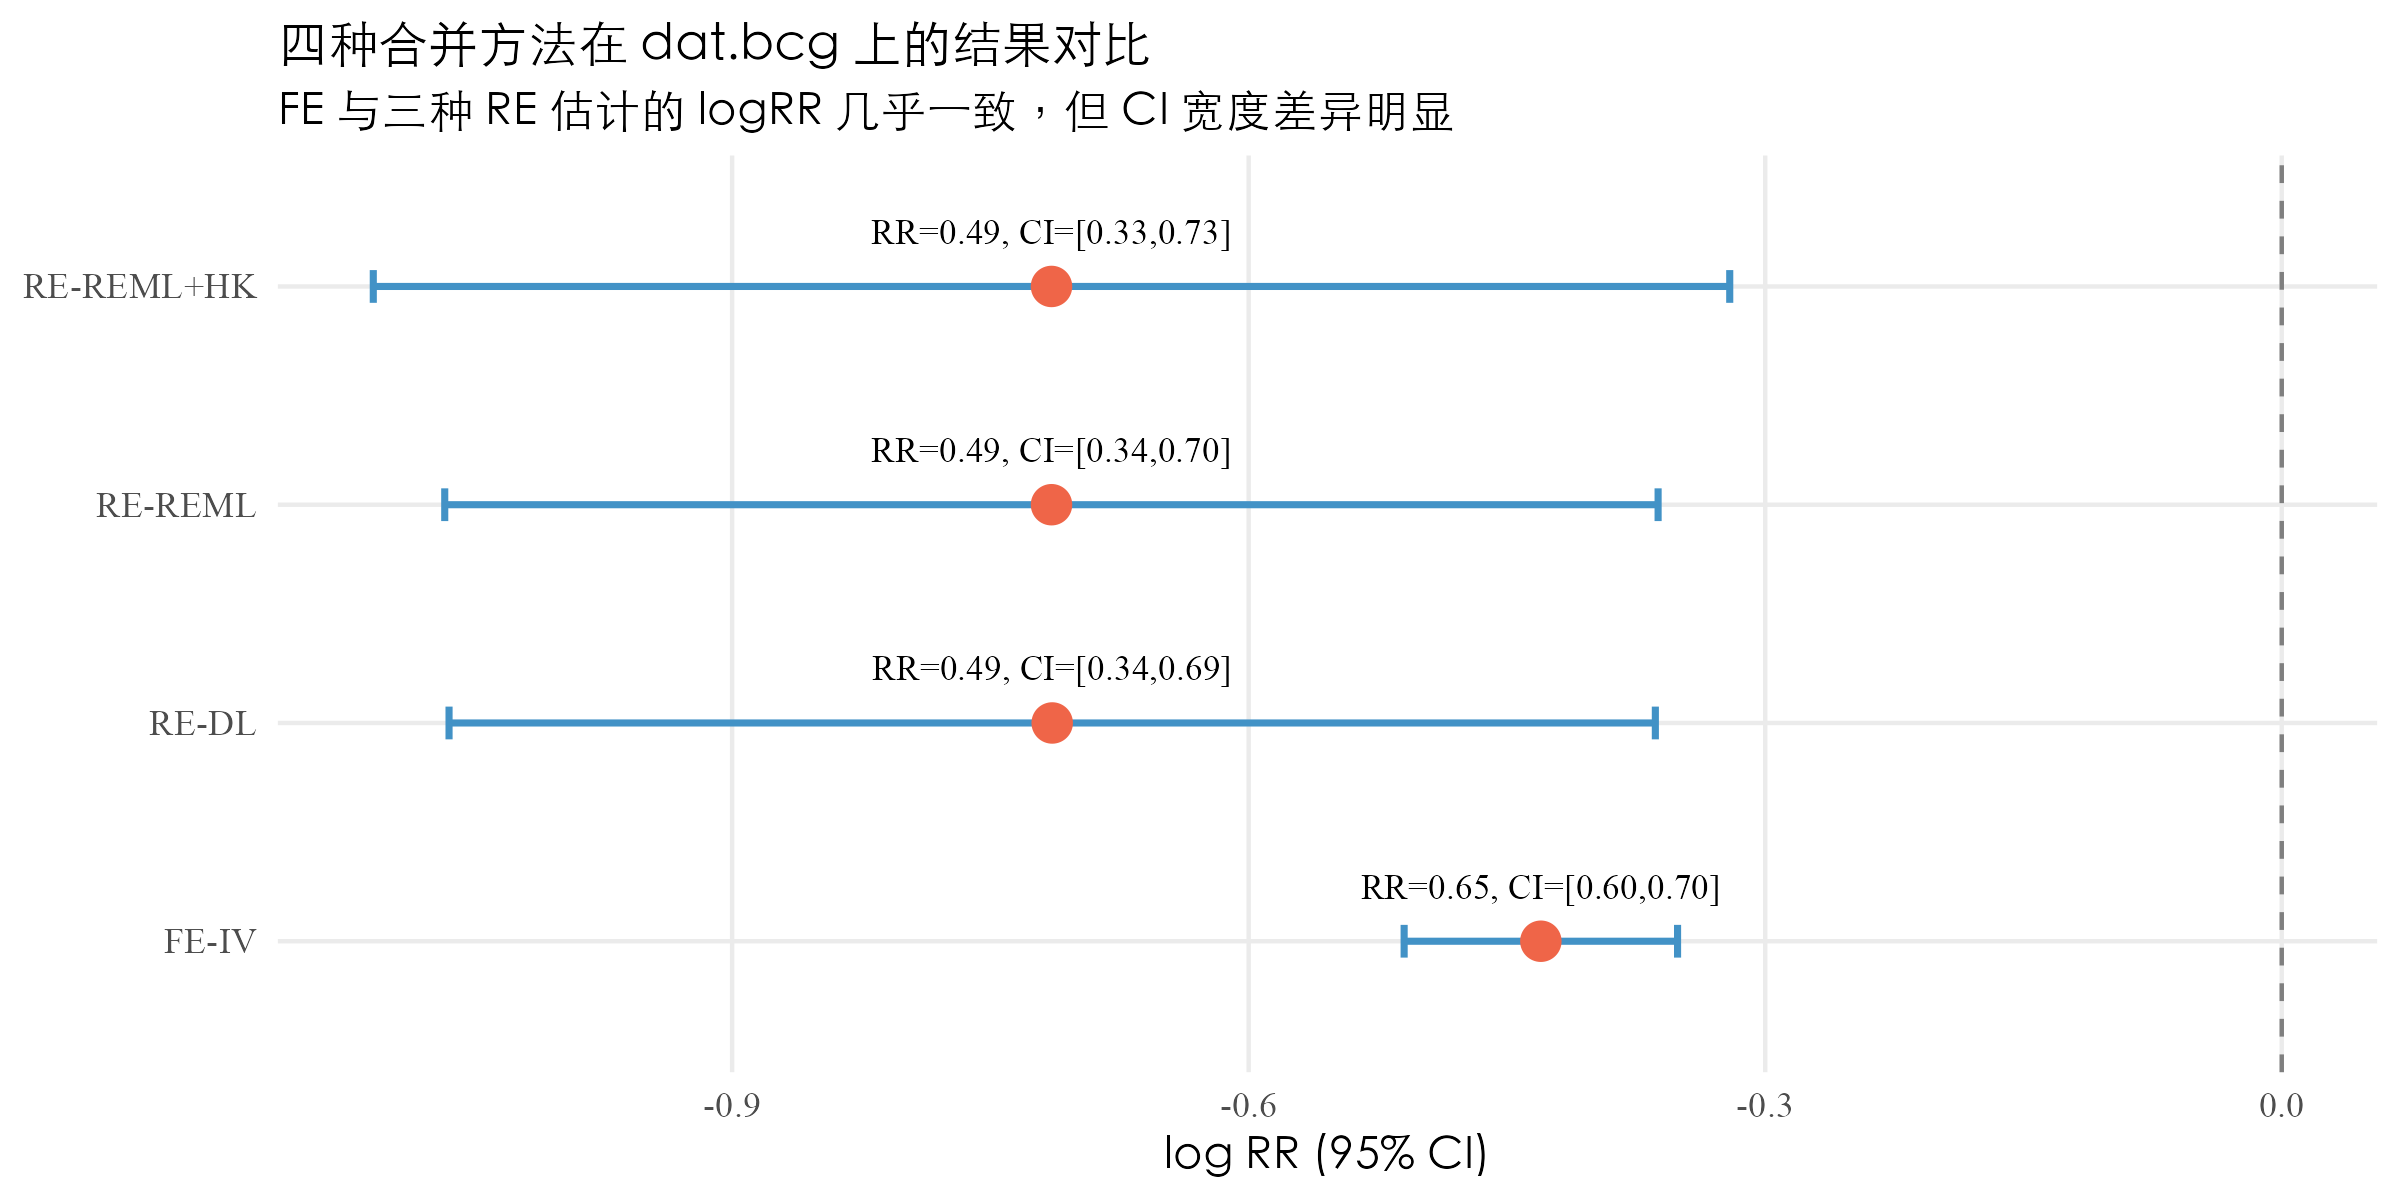
RE-DL 给出 τ^DL2=0.3088,τ^=0.556。合并 logRR=−0.7141,标准误 0.1787,95% CI [−1.0644, −0.3638],对应 RR=0.49,95% CI [0.35, 0.70]。
与 FE-IV 的 RR=0.65 相比,RE-DL 的合并 RR 偏小(保护效应更强),CI 宽度从 FE 的 [0.60, 0.70] 变成 [0.35, 0.70]。这种 CI 大幅变宽是合理的:随机效应承认研究之间存在真实差异,CI 必须把这种差异纳入不确定性。
DL 是矩估计——它要求 Q 的期望值在 FE 模型下等于 k−1,超出 k−1 的部分就归因于研究间方差。这个推导不需要假设 θi 服从正态,是一种"分布无关"的估计。代价是 DL 在小研究数(k<20)和高异质性下偏低:它会低估 τ2,进而高估权重精度,让 CI 偏窄。
REML 估计
REML(Restricted Maximum Likelihood,限制性最大似然)是基于正态假设的最大似然估计,理论上效率更高,在小研究数下偏倚比 DL 小。Cochrane Handbook 与 metafor 包都把 REML 作为默认 τ2 估计量。
在假设 θi∼N(μ,τ2) 与 y^i∣θi∼N(θi,vi) 下,REML 通过对"抹去 μ 后的边际似然"求极值得到 τ2 估计。形式上没有解析解,由迭代算法求解,metafor 默认使用 Fisher scoring 算法。
REML 的优势在小样本下尤为明显。DL 的矩估计在 k 小的时候 Q 本身的方差就不可忽略,DL 估计波动很大。REML 用整个似然函数的形状信息,对 τ2 的估计更稳。代价是 REML 假设 θi 服从正态,DL 不假设。实务上正态假设的违反在 k 较大时影响有限。
re_reml <- rma(yi, vi, data = es, method = "REML")
print(re_reml)
REML 给出 τ^REML2=0.3132,与 DL 的 0.3088 几乎一致。合并 logRR=−0.7145,95% CI [−1.0669, −0.3622],RR=0.489,95% CI [0.34, 0.70]。BCG 数据上 DL 与 REML 结果几乎重合,说明 k=13 已经足够让两种估计趋同。在更小的 k(如 k=5)下,二者会拉开。
Hartung-Knapp 调整
DL 与 REML 都用大样本正态近似算合并 CI——把 μ^ 的方差当作正态分布的方差,乘以 1.96 算 95% CI 半宽。这个近似在 k 大时合理,k 少时偏窄。Hartung & Knapp 2001 提出用 t 分布替代正态、自由度 k−1,让 CI 更稳健。
HK 调整修改两个东西。其一,把合并估计的标准误从 1/∑iwiRE 替换为
SEHK=(k−1)∑iwiRE∑iwiRE(y^i−μ^)2,其中 wiRE 是 RE 权重,μ^ 是 RE 合并均值。其二,置信区间用 tk−1 分布的临界值替代 1.96:
CI95%=μ^±tk−1,0.975⋅SEHK.metafor 通过参数 test = "knha" 启用 HK 调整。
HK 为什么更稳? 两件事都是把 CI 拉宽。第一件事是用每项研究偏离合并均值的实际散布替换理论方差,让 CI 反映"实际看到的散布"而不是"理论应该有的散布"。第二件事是把 z0.975=1.96 换成 tk−1,0.975。当 k=13,t12,0.975=2.179,比 1.96 大约 11%;k=5 时 t4,0.975=2.776,比 1.96 大约 42%。研究数越少,HK 调整把 CI 拉得越宽,避免小样本下的过度自信。
re_hk <- rma(yi, vi, data = es, method = "REML", test = "knha")
print(re_hk)
HK 调整后合并 logRR=−0.7145(点估计与 REML 完全相同),标准误 0.1808(略高于 REML 的 0.1798),95% CI [−1.1084, −0.3206],RR=0.489,95% CI [0.33, 0.73]。p 值用 t 分布算,p=0.0019(仍显著)。
Cochrane Handbook 自 2019 年起推荐随机效应模型默认使用 REML + HK 组合,尤其在 k<20 时。本书后续的随机效应主结果均采用这组配置。
预测区间 PI
随机效应模型有一个比 CI 更直接对应临床决策的指标——预测区间(prediction interval,简称 PI)。CI 描述合并均值的不确定性,PI 描述未来一项新研究的真实效应可能在哪里。在异质性显著时 PI 比 CI 重要得多。
PI95%=μ^±tk−2,0.975⋅τ^2+SE(μ^)2.其中 μ^ 是 RE 合并均值,τ^2 是研究间方差估计,SE(μ^) 是合并均值的标准误。PI 比 CI 宽,因为根号里把 τ^2(未来研究自身的真实异质性)和 SE(μ^)2(合并估计的不确定性)两部分加在一起。自由度 k−2 而非 HK CI 的 k−1:PI 公式根号里多估了一个 τ2 参数,按 IntHout-Higgins-Tovey 2016 的推导多扣一个自由度。metafor 的 predict 函数对带 test = "knha" 的对象会自动用对应自由度计算 CI 与 PI。
PI 与 CI 的差别在临床上至关重要。CI 告诉你的是"全球 BCG 的平均效应";PI 告诉你的是"在某一个具体地区开展 BCG 项目,预期效应的范围"。如果 PI 跨过零线,意味着未来一项研究完全可能给出无效甚至反向的结果,临床推广就要谨慎。
pi_hk <- predict(re_hk)
cat("合并 RR =", round(exp(pi_hk$pred), 3),
    "  95% CI =", round(exp(pi_hk$ci.lb), 3), "to",
                  round(exp(pi_hk$ci.ub), 3), "\n")
cat("95% PI  = [", round(exp(pi_hk$pi.lb), 3), ",",
                   round(exp(pi_hk$pi.ub), 3), "]\n")
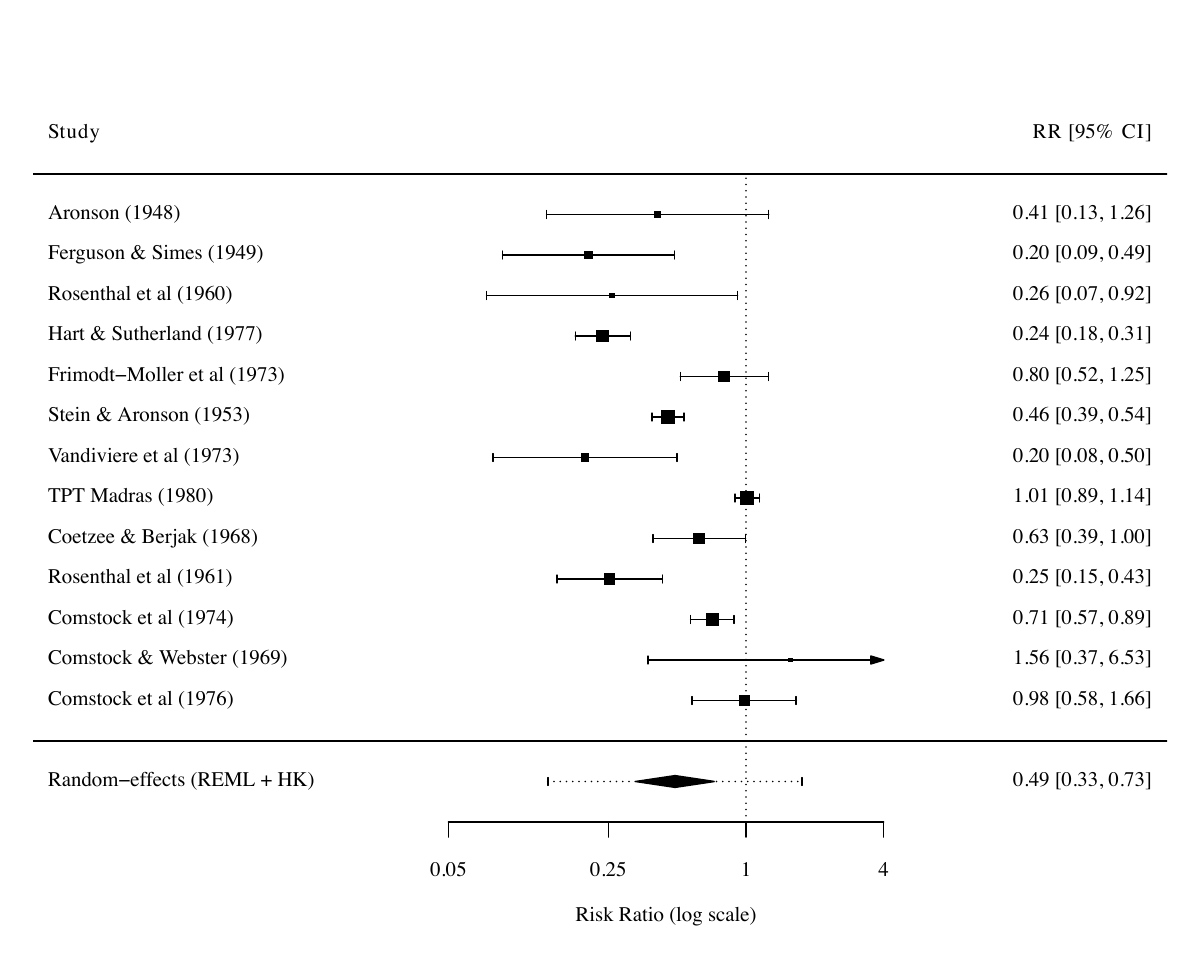
REML + HK 给出合并 RR=0.489,95% CI [0.33, 0.73],95% PI [0.136, 1.763]。CI 不跨过 1,"全球平均 BCG 有保护效应"这个结论在 5% 错误率下成立。但 PI 跨过 1,意味着未来在某个新地区开展的 BCG 试验可能给出从 RR=0.14(强保护,把风险压到原来的 14%)到 RR=1.76(反向,比对照组风险高 76%)的任何结果。这就是 BCG 数据真正的临床信息:BCG 平均有效,但在不同地区效果可能截然不同。第 7 章的纬度 meta 回归会回答这种"具体地区效应"如何用协变量解释。
Forest plot 带预测区间
随机效应 forest plot 通常在合并菱形下方加一根额外的横线代表 PI,方便临床读者直接读出"未来研究的可能效应范围"。metafor 通过参数 addpred = TRUE 自动添加这一行。
13 项 BCG 试验随机效应(REML + HK)模型 forest plot。底部菱形为合并 RR = 0.49(95% CI 0.33–0.73),其下方水平横线为 95% 预测区间 [0.136, 1.76],跨过 1,提示未来研究的不确定性远大于合并 CI 暗示的程度。
雷区把 PI 当 CI 解读 / 异质性极高时只报合并均值随机效应模型有两个常被混淆的雷区。第一是把 PI 当 CI 解读。论文里读到"95% interval = [0.13, 1.76]",不知道是 CI 还是 PI 就草率引用,会得到完全相反的结论。CI 描述合并均值的不确定性,PI 描述未来研究的不确定性。报告时必须明确标注。第二是在异质性极高时报告 RE 合并均值。当 I2>85%,不同研究的真实效应很可能本质上不同,合并的 μ 可能对应不到任何实际场景。BCG 数据 I2=92%,单一合并 RR=0.49 只是统计意义上的全球平均,不能直接解读为"在我所在的地区 BCG 把风险降低 51%"。正确做法是配合第 7 章的亚组与 meta 回归,解释异质性来源。
第 5 章到这里收束。三种 RE 估计(DL、REML、REML+HK)给出几乎相同的点估计 RR=0.49,CI 宽度从 DL 的 [0.35,0.70] 一路扩到 REML+HK 的 [0.33,0.73]。比 FE-IV 的 [0.60,0.70] 显著更宽是合理的:RE 模型承认研究本来就不一样,CI 必须把这种差异纳入不确定性。
但合并 RR=0.49 与 PI [0.14,1.76] 跨度极大的反差说明,异质性本身需要被正面量化。第 6 章就用 Q、I2、τ2 这一组指标系统刻画异质性,PI 不再重复定义,按本章定义直接引用。第 6 章末把所有方法(FE 与 RE)的合并结果汇入一张更新的对比表。