第 4 至第 8 章给出了 BCG 数据的合并估计、异质性诊断、协变量解释、发表偏倚检验。本章是审稿人的"最后一关":如果删掉某一项研究,主结论是否还成立?证据累积到什么时候已经足以下结论?哪项研究在统计上最有影响力?这三个问题对应的工具是 leave-one-out 分析、累积 meta 分析、影响诊断。
Leave-one-out 分析
Leave-one-out 是最直接的稳健性检验:每次去掉一项研究,用剩余 项重新合并,看合并 RR 与 CI 变化多少。如果某一项研究的去除让结论方向翻转或显著性消失,就说明合并结论被这项研究主导,证据脆弱。
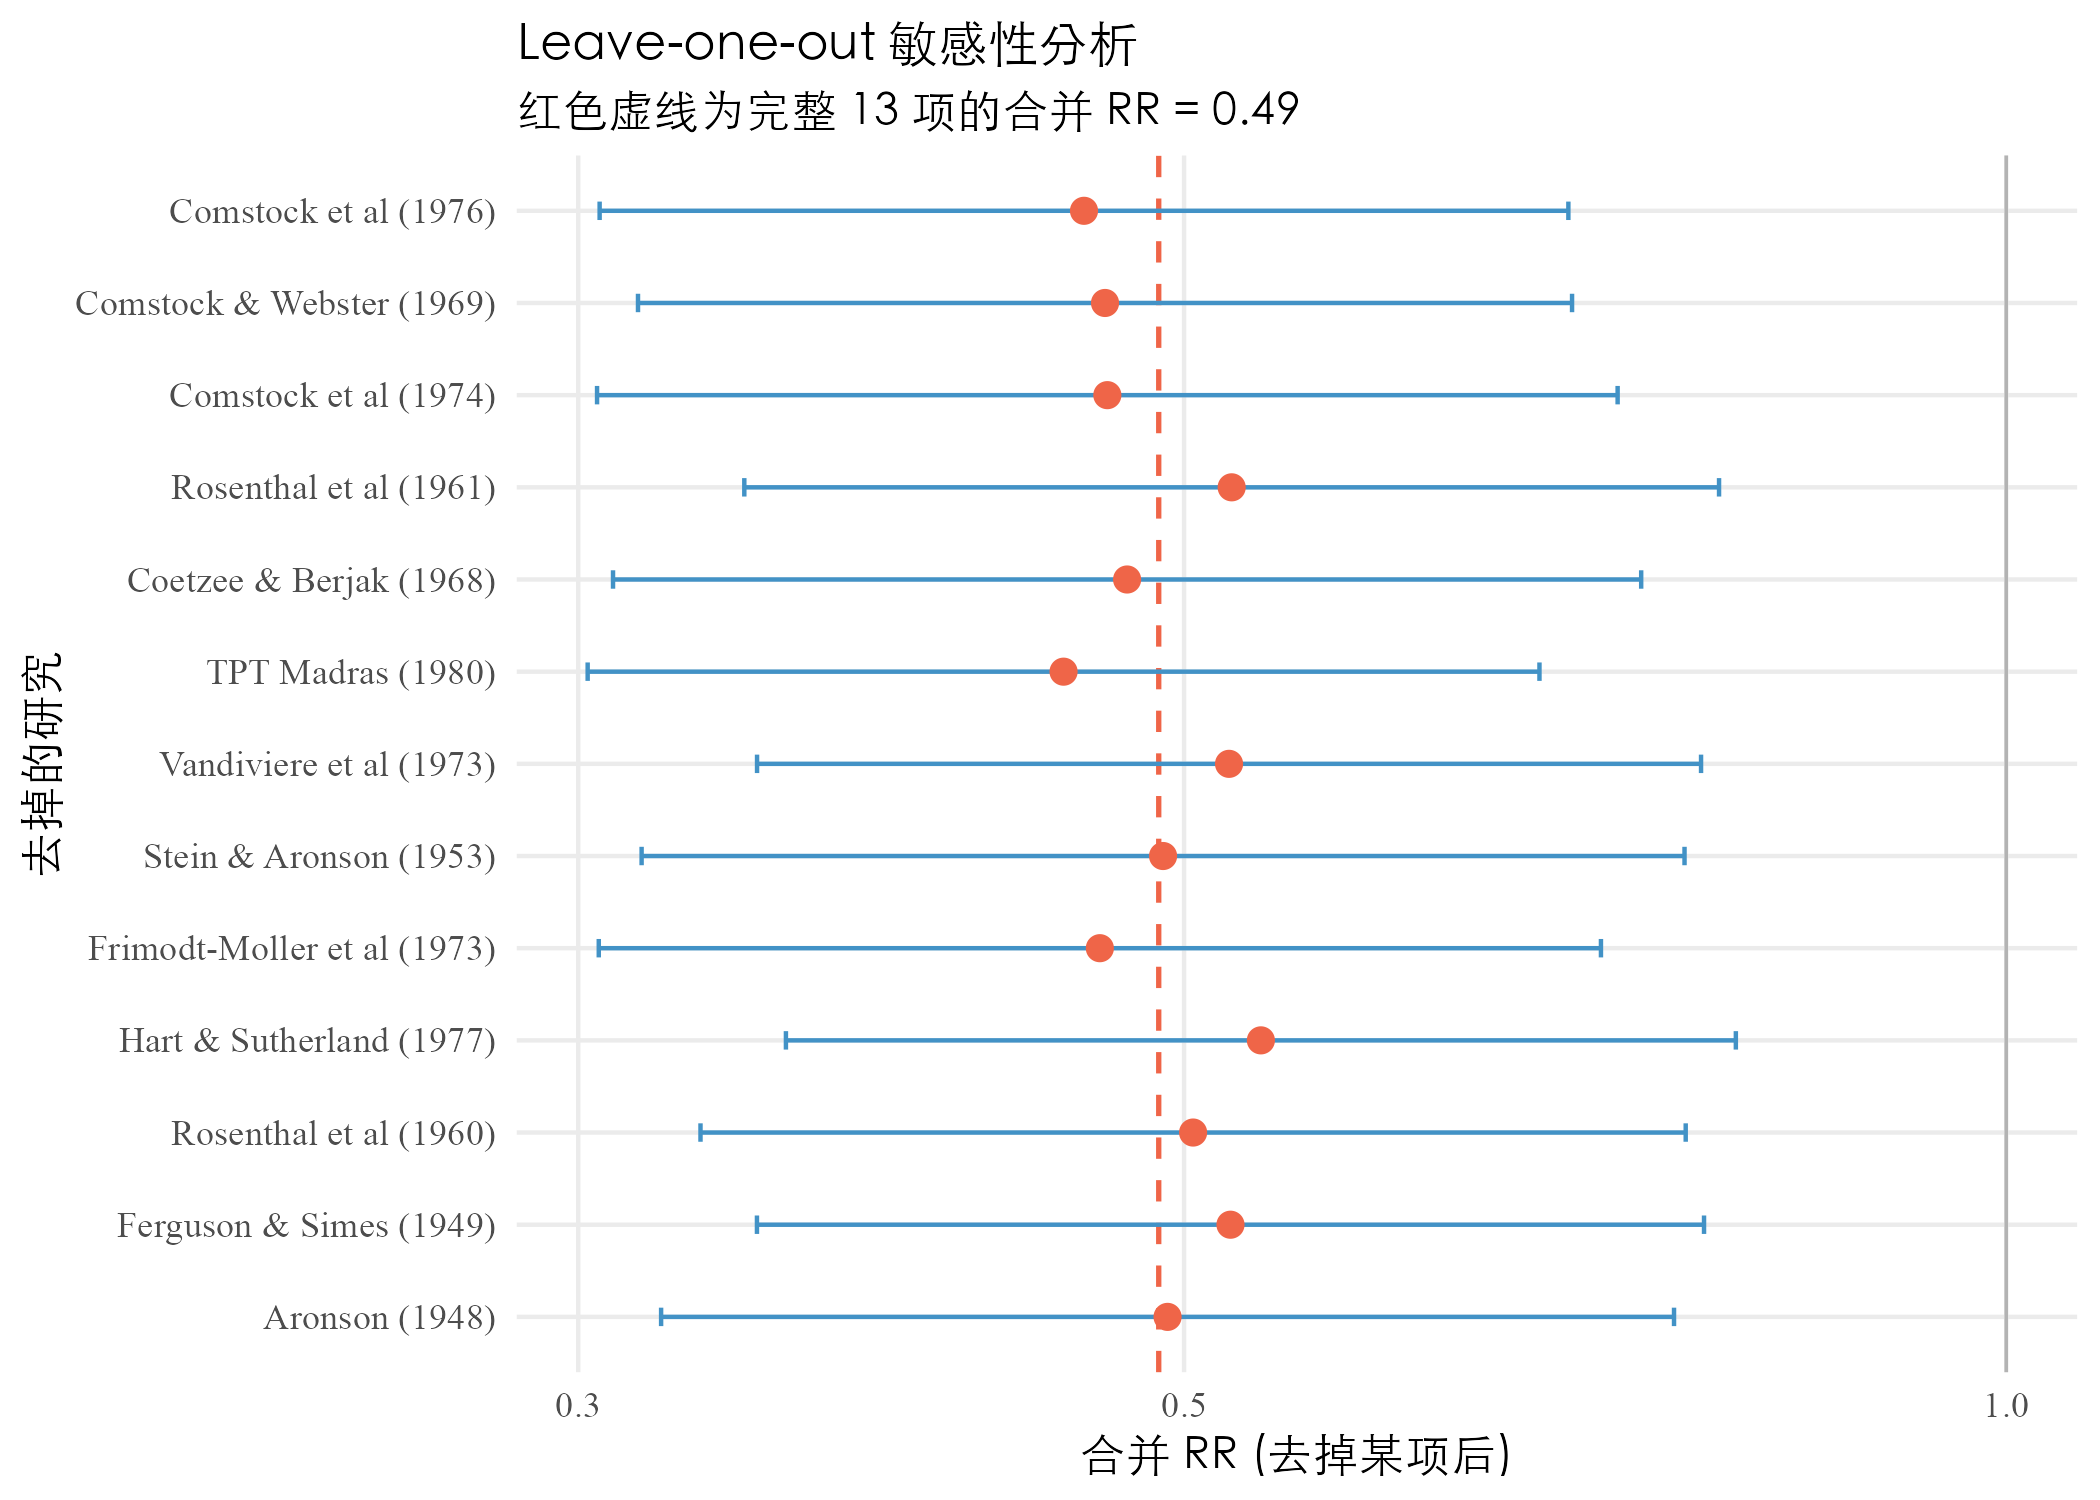
对每项研究 ,去掉该项后用剩余 项跑随机效应模型,得到 个合并估计 与对应 95% CI。把这 个估计排成 forest plot,能直观看出"哪项研究的去除让合并漂移最大"。
loo <- leave1out(re, transf = exp)
print(loo)
完整 13 项合并 。13 个 LOO 合并 RR 跨度从 0.452 到 0.533,所有 95% CI 都不跨过 1,结论"BCG 有保护效应"在去掉任意一项后仍然成立。
最有影响力的两项是去掉 8 号 TPT Madras 1980( 从 0.489 下降到 0.452,保护效应增强)与 4 号 Hart & Sutherland 1977( 从 0.489 上升到 0.533,保护效应削弱)。这两项分别是"反向极端"(赤道附近 RR )与"正向极端"(高纬度 RR ),它们的去除导致合并估计向相反方向漂移。但漂移幅度都在 0.04–0.05 范围内,临床决策上相同。
累积 meta 分析
累积 meta 是另一种稳健性检验:按某种顺序(通常是发表年份)逐项加入研究,每加一项重新跑合并,看证据累积过程。这种分析能回答两个问题:什么时候证据已经足以下结论?后续研究是确认了早期发现还是颠覆了早期发现?
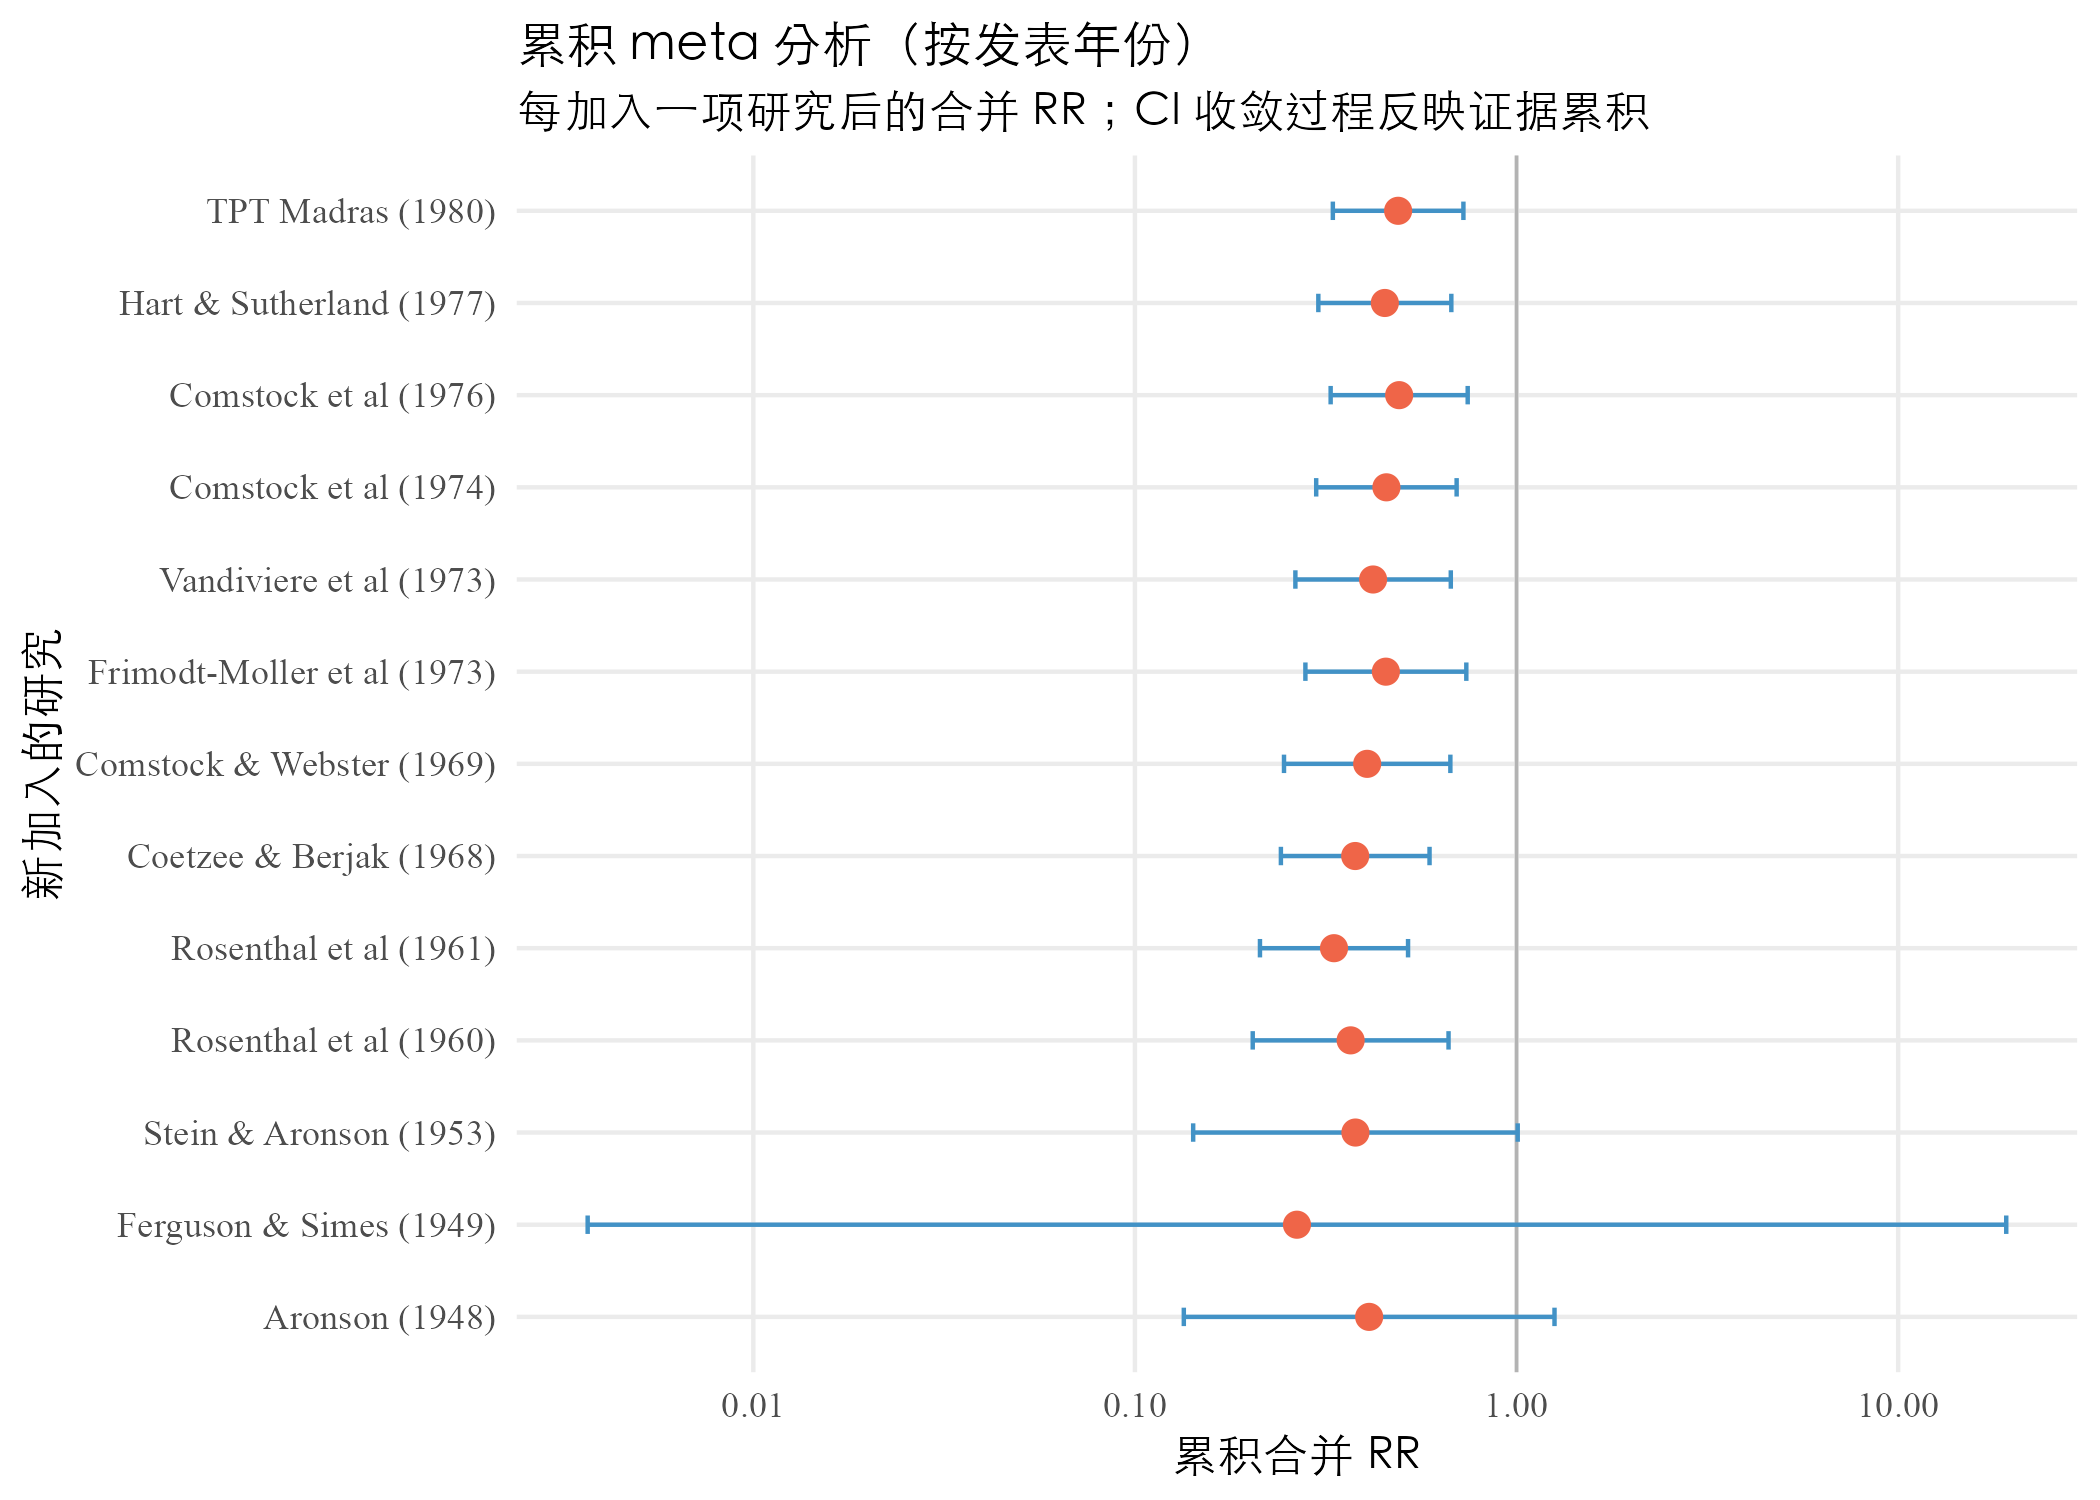
把研究按时间顺序排列,从最早的 1 项开始,逐项加入新研究,每次都跑一次随机效应合并。第 步给出"截至时间 已有证据"的合并估计。把累积估计画成 forest plot,能直观看到证据何时收敛、何时出现转折。
cum <- cumul(re_sorted, transf = exp)
print(cum)
按发表年份累积合并:
| 累积 | 最新加入研究 | 年份 | 合并 RR | 95% CI | ||
|---|---|---|---|---|---|---|
| 1 | Aronson | 1948 | 0.41 | (0.13, 1.26) | 0 | 0% |
| 2 | Ferguson & Simes | 1949 | 0.27 | (0.004, 19.20) | 0 | 0% |
| 3 | Rosenthal 1960 | 1960 | 0.38 | (0.14, 1.01) | 0.087 | 41% |
| 5 | Frimodt-Moller | 1973 | 0.33 | (0.21, 0.52) | 0.086 | 48% |
| 8 | TPT Madras | 1980 | 0.45 | (0.28, 0.74) | 0.178 | 72% |
| 13 | Comstock 1976 | 1980 | 0.49 | (0.33, 0.73) | 0.313 | 92% |
累积到 1973 年(5 项研究,全部为高/中纬度),合并 ,CI ,看起来 BCG 是个相当强的疫苗。1980 年加入 TPT Madras 这项低纬度大样本无效研究后,合并 RR 立刻从 0.33 升到 0.45, 从 48% 跳到 72%,异质性指标显著恶化。如果一个 1973 年的政策制定者读到当时的累积 meta,会得到一个相当乐观的结论;但 1980 年的更新会立刻打破这个乐观。这是累积 meta 最有价值的地方——它揭示了"我们以为的稳定结论何时被新证据颠覆"。
影响诊断
回归分析里有一套成熟的影响诊断指标,能识别哪些观测对模型估计有不成比例的影响。Meta 分析借用了这套工具,每项研究类比线性回归里的一个观测。把这四个指标想象成一张回归桌:13 项研究是桌面上的 13 个砝码,合并均值是桌子的重心。
Studentized residual :第 项研究偏离合并均值的标准化距离。直觉上是问"这个砝码离桌子重心有多远"。 表示该研究偏离整体趋势两个标准差以上,需要核查。
Cook's distance :把第 项研究拿走再放回,整张桌子的重心位置变化的总量。直觉上是问"这个砝码一拿走,桌子整体晃动多大"。 大说明这项研究主导了重心。常用阈值 。
DFFITS :与 Cook's D 类似,但只看合并均值这一个数值的标准化变化量,不考虑其他估计。直觉上是问"这个砝码一拿走,桌子重心在主轴上挪动几个标准差"。常用阈值 , 是参数数。
Hat value :第 项研究的"杠杆"。直觉上是问"这个砝码本身有多重、放在多远的位置"。砝码越重(权重越大)或者放得越远(离合并均值越远),杠杆越大。注意高 hat 不一定有偏倚,只说明该研究对模型有重要贡献。常用阈值 。
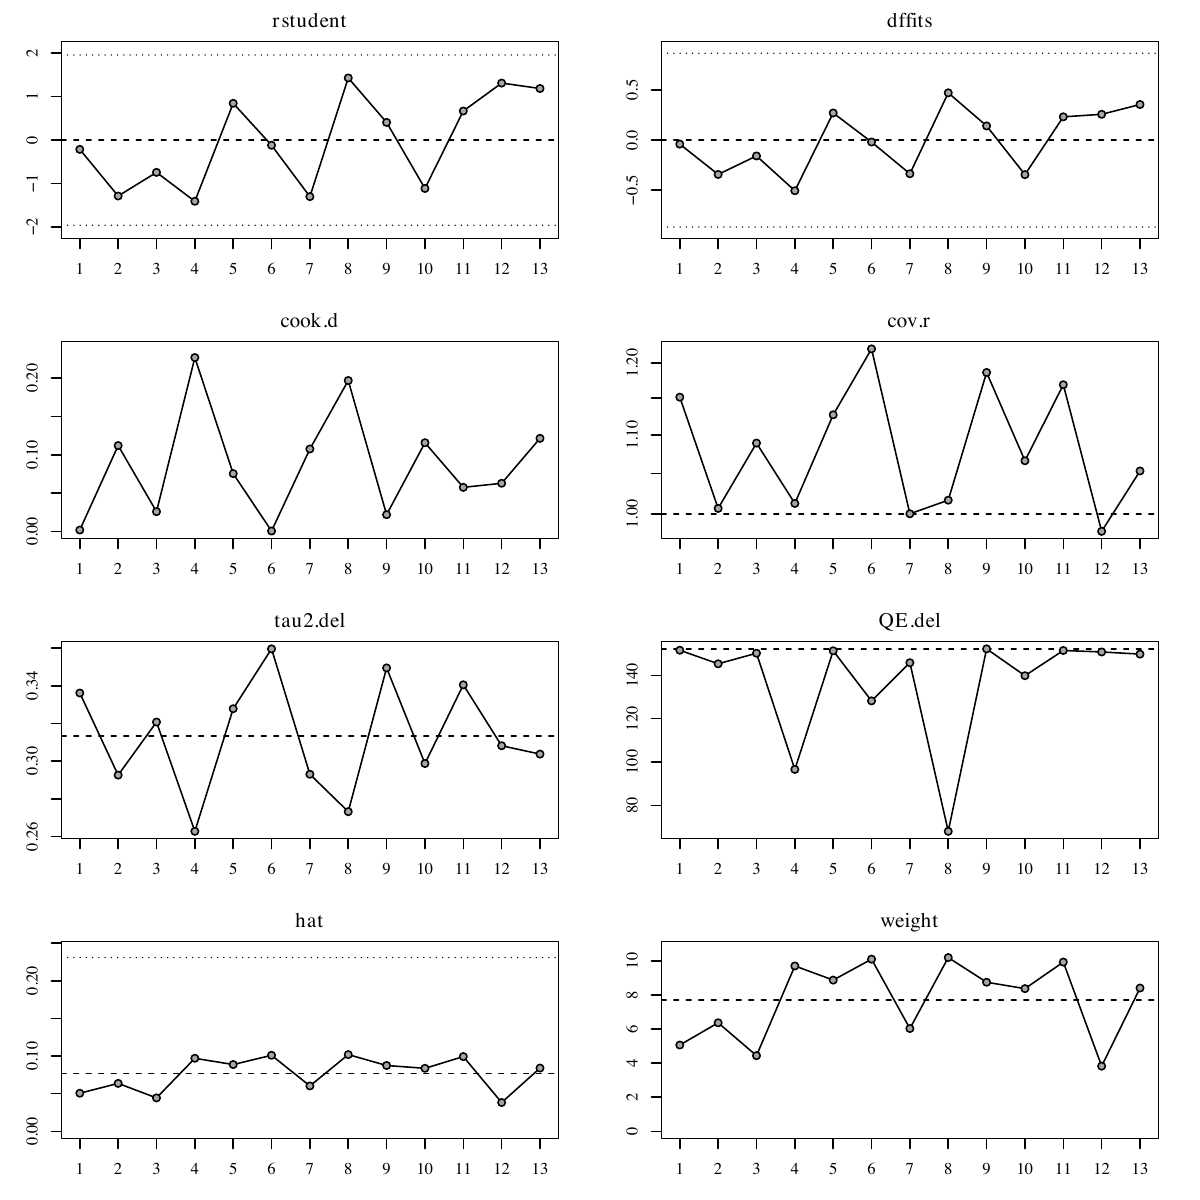
四个指标各有侧重:rstudent 看"研究偏离主流多远",hat 看"研究本身有多大分量",Cook's D 与 DFFITS 看"拿掉它整张桌子怎么晃"。一个研究 hat 大但 rstudent 小(在主流方向上的大研究),通常没问题;hat 小 rstudent 大(小研究但极偏离),影响有限;hat 大 rstudent 大(大研究又偏离),就是 Cook's D 与 DFFITS 同时报警的危险组合。
metafor 的 influence 函数一次性输出全部影响诊断指标,并标记被任意阈值识别的"influential"研究。
inf <- influence(re)
print(inf)
全部 13 项研究的关键指标如下:
| 编号 | 作者 | rstudent | DFFITS | Cook's D | hat |
|---|---|---|---|---|---|
| 1 | Aronson | 0.002 | 0.051 | ||
| 2 | Ferguson & Simes | 0.112 | 0.064 | ||
| 3 | Rosenthal 1960 | 0.026 | 0.044 | ||
| 4 | Hart & Sutherland | 0.227 | 0.097 | ||
| 5 | Frimodt-Moller | 0.075 | 0.089 | ||
| 6 | Stein & Aronson | 0.000 | 0.101 | ||
| 7 | Vandiviere | 0.108 | 0.060 | ||
| 8 | TPT Madras | 0.197 | 0.102 | ||
| 9 | Coetzee & Berjak | 0.022 | 0.087 | ||
| 10 | Rosenthal 1961 | 0.116 | 0.084 | ||
| 11 | Comstock 1974 | 0.057 | 0.099 | ||
| 12 | Comstock & Webster | 0.063 | 0.038 | ||
| 13 | Comstock 1976 | 0.121 | 0.084 |
Cook's distance 最大的两项是 4 号 Hart & Sutherland 1977()与 8 号 TPT Madras 1980()。这与 leave-one-out 结果一致,正是这两项研究在合并均值的两侧产生最大拉拽。但所有 都在 以内,所有 都在 以内,metafor 标记的"influential"研究为空。BCG 数据上没有单一研究被诊断为统计意义的极端值。
影响诊断最危险的误用是事后剔除研究换取更"好看"的结论。看到 4 号 Hart & Sutherland 1977 是 Cook's D 最大的研究,把它剔除会让合并 RR 从 0.49 升到 0.53, 从 92% 降到 90%,看起来稳健性更好。这种做法在 Cochrane Handbook 里被明确禁止:影响诊断的目的是识别需要核查的研究,不是决定要剔除的研究。识别出影响大的研究后,正确流程是回到原文核查方法学:随机化是否严格、失访是否高、结局是否预先注册。如果方法学没问题,研究就保留,无论它对合并结果的影响多大。剔除研究必须基于预先指定的方法学标准,不能基于"它让我的结论更显著"。
第 9 章到这里收束。leave-one-out 表明 BCG 主结论高度稳健(13 项研究任意去掉一项后合并 RR 仍在 – 之间,所有 CI 都不跨过 1);累积 meta 揭示了 1980 年 TPT Madras 加入后整体异质性显著上升的转折;影响诊断指标都在常用阈值内,没有单一研究主导结果。
第 10 章把所有方法的合并估计放进终极对比表,并用 GRADE 框架把这一份证据翻译成临床证据等级,给出"BCG 这份证据值多少"的最终答案。