1985 年,美国田纳西州议会批准了一项规模罕见的教育实验。州政府花了约 1,200 万美元,在全州 79 所小学里把 11,000 多名学生和 1,300 多位老师全部随机分配进三种班级里,连续观察四年,看小班教学是不是真的有效。这就是 Project STAR,全称 Student/Teacher Achievement Ratio。
实验设计本身极为干净。学生入学时被随机分到三种班里。第一种是小班(small class,13–17 人),第二种是常班(regular class,22–25 人),第三种是常班+助教(regular plus aide,22–25 人但配一名教学助理)。老师也是随机分配到这三种班里,和学生一起从幼儿园 K 年级开始,连续到三年级。每年学生考一次 Stanford Achievement Test,记录数学和阅读分数。
这项研究后来成了教育政策与多层建模教学的奠基样本。它一次性回答了两个问题:第一,小班教学的因果效应有多大;第二,学生分数的差异里有多少是来自老师、班级、学校的"上层"波动,而不是单个学生的随机起伏。前一个问题给政策制定者方向,后一个问题给统计学家提出了"嵌套数据怎么分析才算诚实"这个根本难题。
为了让"嵌套到底是个什么东西"不只是一个抽象说法,先看本书全程要用的这份数据的真实结构:
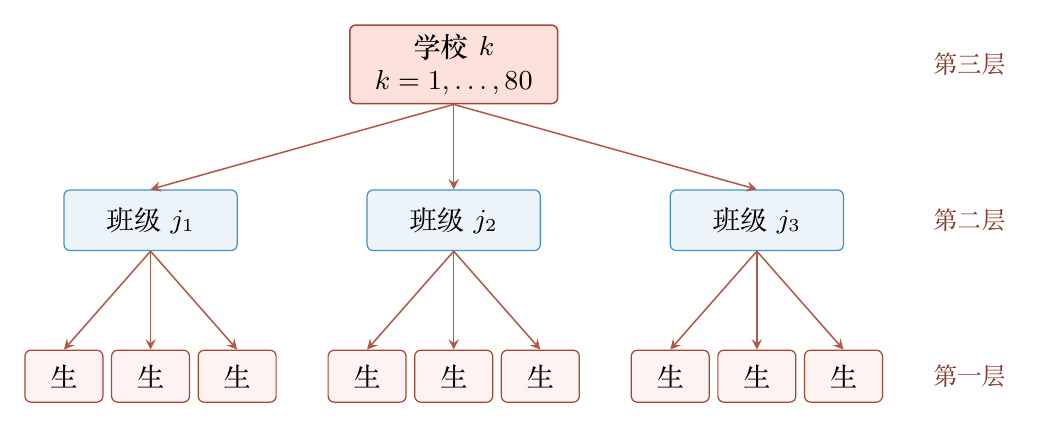
- 5,786 名 K 年级学生,分散在 337 个班级里。每个班级由一位老师带队。
- 这 337 个班级分散在 79 所小学里。每所小学带 4 个班,平均班里 17 人。
- 处理变量
cltype(班级类型)随机分配在班级层面:30% 的班是小班,35% 是常班,35% 是常班+助教。
学生不是独立的样本点,他们三层嵌套——学生在班级里、班级在学校里。这个事实将贯穿全书:每一章用一种新方法,让这个事实在统计推断里得到尊重。
到了 1990 年代末,Bates 和 Pinheiro 把混合效应模型的 R 工具包 nlme 推广开来,后来 Bates 又写了 lme4,把 STAR 之类的多层数据分析变成了一行 lmer 调用。这份数据被收进 mlmRev 包,称为 star,成为多层建模教学的事实标准样本,相当于因果推断教学里的 RHC、回归分析里的 mtcars。**本书全书都用这一份数据。**每一章用一种方法处理这同一份数据,到第 10 章把所有结论汇总比较。
一所学校的数据结构:学生在班级在学校
每所参加 STAR 的小学做的事其实都一样。学校把当年要入学的 K 年级新生集中起来,按完全随机的方式分配进 4 个班里,其中 1 个是小班,2 个是常班(一个带助教一个不带),剩下 1 个再补一种。老师也按随机方式分配。每年 5 月做一次标准化测试,分数交给田纳西大学的统计员录入。
整所学校的核心结构可以装进一张三行小表,行业通称嵌套层级表。下表用 K 年级数据给出全样本的真实数字。
表 1·1 STAR K 年级数据的三层结构(真实数字)
| 层级 | 单位数 | 平均嵌套子数 | 符号 |
|---|---|---|---|
| 学校 school | 79 所 | 约 4 个班 / 校 | (学校索引) |
| 班级 class / teacher | 337 个 | 约 17 名学生 / 班 | (班级索引) |
| 学生 student | 5,786 名 | — | (学生索引) |
读这张表的方法是从下往上一层层套。最底下一层是学生,每名学生留下一份分数 。中间一层是班级,平均 17 名学生坐在同一个班里、由同一位老师教。最上面一层是学校,平均 4 个班同属一所小学,共享同一个校长、同一套课程编排、同一份社区生源。
为什么要这样画这张表?因为本书后面所有多层模型方法,本质上都从这三层结构开始。5,786 名学生 = 337 个班 = 79 所学校。lme4 包用 (1|sch/tch) 的语法表示"班级嵌套在学校里",背后正是这张表的层级关系。本书后续章节里出现的索引 都回到这张图。
停下来想一想。 如果你能告诉别人某名学生的 三个索引各是多少,你就完整定位了这名学生在数据里的位置。同班同学共享同一个 ,同校同学共享同一个 。这就是多层建模整理研究数据的最小单位。
班级类型与考试分数:朴素均值对比
知道了三层结构,怎么算"小班到底有没有用"?
最直觉的做法是看三种班级类型的平均分数,每个班里所有学生的数学分数加起来除以人数。三类的真实数字列在下表。
表 1·2 K 年级三类班级的朴素均值(math 分数)
| 班级类型 | 班级数 | 学生数 | 平均班级人数 | 数学均值(SD) |
|---|---|---|---|---|
| 小班 small | 131 | 1,738 | 13.3 | 491.4 (49.4) |
| 常班 reg | 103 | 2,005 | 19.5 | 483.3 (47.5) |
| 常班+助教 reg+A | 103 | 2,043 | 19.8 | 482.9 (45.9) |
最直观的对比是小班减去常班: 分。换句话说,分到小班的孩子平均比分到常班的孩子多考 8.1 分。常班+助教那一类几乎和不带助教的常班一样(),助教这个变量看起来没用。
用一个完全不需要教育学背景的例子理解这个差距:100 个学生考 0 到 800 分之间的标化测试,全样本的标准差大约是 47 分,所以 8 分相当于 0.17 个标准差。这是个不大但也不能忽视的差距,相当于把一个班的中等水平推到中等偏上。
对一份随机分配处理的数据,小班效应定义为
其中 是分到小班的学生数学均值, 是分到常班的学生数学均值。它衡量"把孩子从常班调进小班"在分数上能换来多少提升。
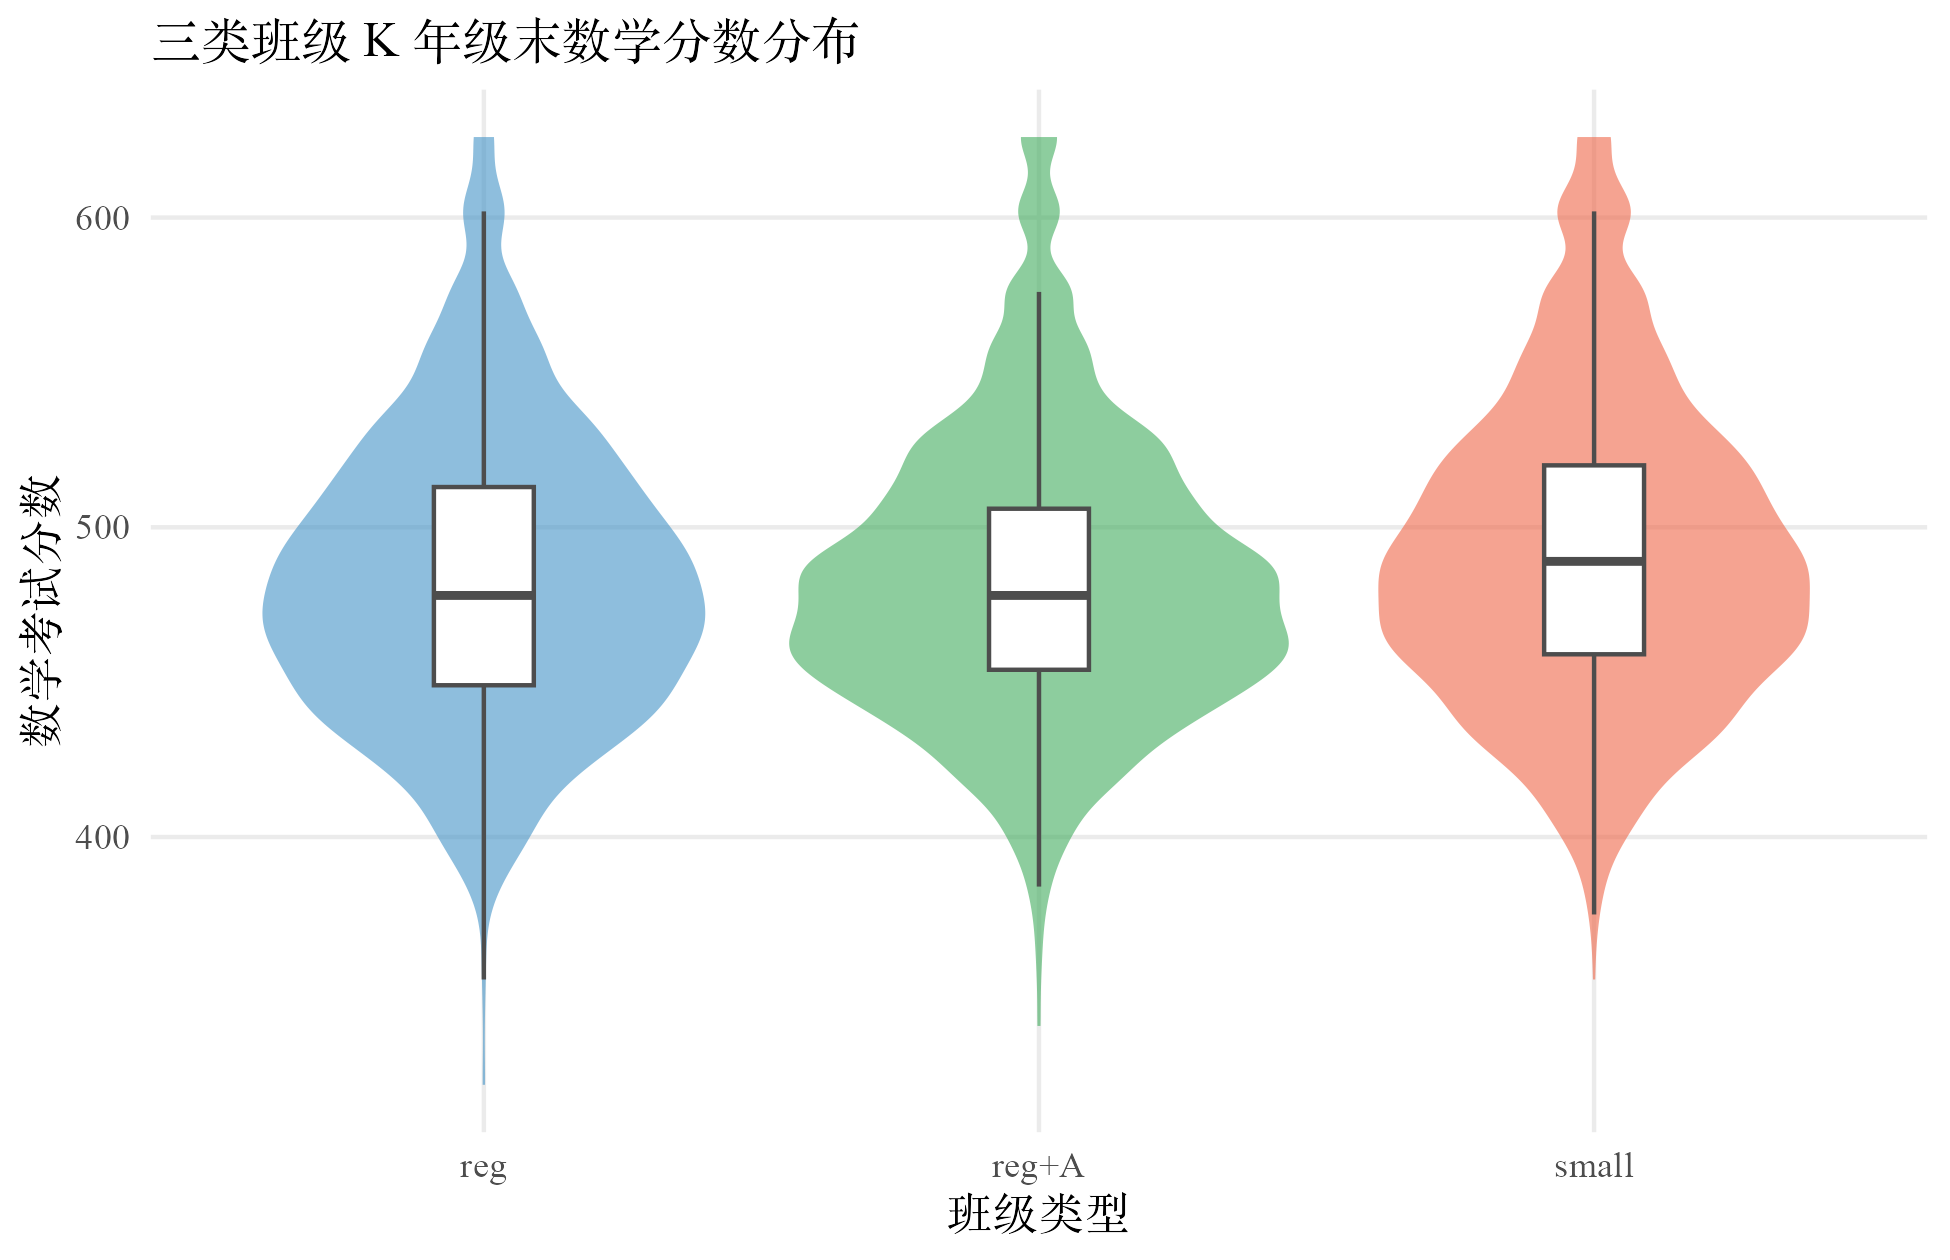
朴素估计 分这个数字看起来直接、可复现,但它隐藏了一个严重的统计问题:它假设 5,786 名学生互相独立。同一个班的 20 个学生共享同一位老师、同一个教室、同一个学习氛围,他们的分数高度相关。把他们当成 20 个独立观测来计算这个差距的标准误,会算出一个比真实情况小很多的不确定度,让"小班 +8 分"看起来比真实更可信。这个问题就是本书第 2 章要面对的核心。
学校层面的差异:一份数据的"伏笔"
扫一眼上面那张朴素均值表,会注意到一个隐藏的事实:三类班级的数学均值都在 483 到 491 之间,跨度只有 8 分。但这只是把全样本平均得到的数字。如果按学校分组看,每所学校的均值差别能拉到 124 分——最差的学校均值是 427,最好的学校均值是 551。
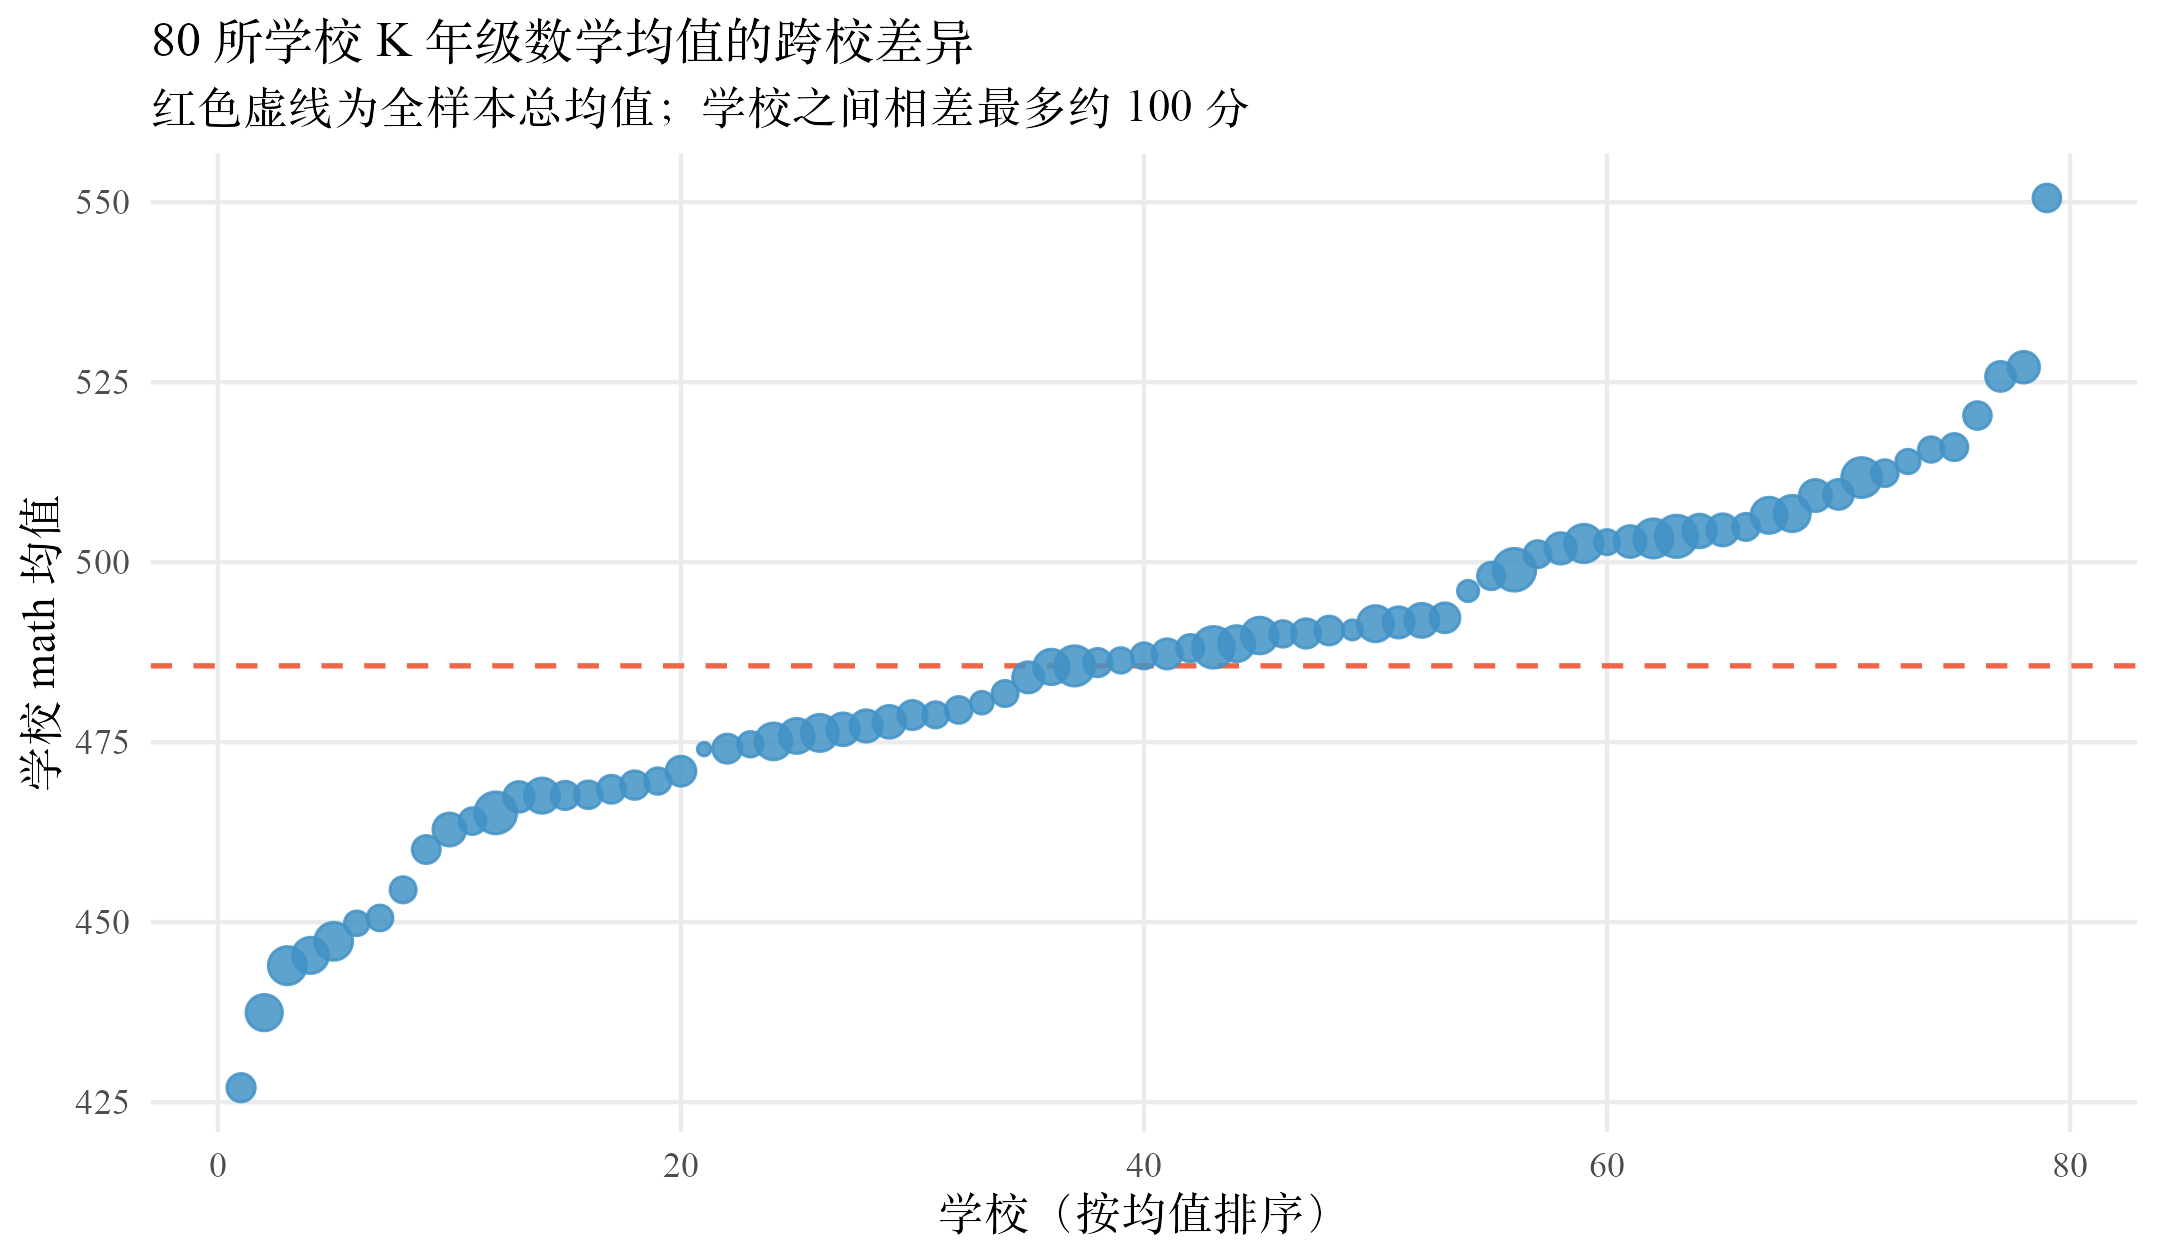
这个事实不是巧合,它说明 STAR 数据里有大量学校层面的系统性差异。这些差异来自学校所在社区的社会经济水平、师资条件、学校管理质量等等不可测变量。如果不把学校层面这部分变异分离出来,"小班 +8 分"这个结论会被学校间的巨大噪声淹没。
班级层面也有类似情况。337 个班的均值跨度从 405.7 分到 580.5 分,跨度 175 分,比跨校差异更夸张。这部分跨班差异里,一部分来自老师质量,一部分来自班里学生的随机组合,一部分来自小班 vs 常班的处理效应本身。如何把这三部分分开,是第 3 到第 8 章轮番要解决的问题。
停下来想一想。 一名学生的分数同时受三种力量影响:自己的能力(学生层)、老师与班里同学的平均水平(班级层)、学校与社区环境(学校层)。一个朴素的分数差 分把所有这些力量都搅在了一起。多层建模就是把这些力量一层层拆开来看的工具。
全书路线图
本书的结构沿着这条思路展开。第 2 章先用最朴素的 OLS 跟带班级随机截距的 lmer 对比,把"为什么忽略嵌套会算错标准误"这件事说清楚,并给出关键诊断指标——组内相关 ICC。第 3 章详细讲空模型的方差分解,让读者亲眼看到 VarCorr 的输出怎么解读。第 4 章把学生层协变量加进 Level-1,讨论中心化的两种做法。第 5 章把处理变量 cltype 加进 Level-2,给出本书的核心因果估计。第 6 章引入随机斜率,讨论 SES 效应是否在班级间随机变化。第 7 章用跨层交互回答"小班对低 SES 学生有没有额外作用"。第 8 章把学校层加进来,跑完整的三层模型。第 9 章做模型诊断与影响分析。第 10 章把所有方法的小班效应估计并列出来对比。
每一章末尾都会更新一张累积对比表,把当前章给出的小班效应、对应标准误、方差分量并列上去。读者如果想直接跳到结论,第 10 章的终极对比表会一目了然地展示:从朴素 OLS 到三层 HLM,"小班效应"这个数字是怎么从 +8.21(SE = 1.56,)漂移到 +8.84(SE = 2.63,)的。点估计基本没变,但对它的把握度变了。这就是多层建模的全部价值。