第 7 章用跨层交互检验了"小班对低 SES 学生是不是有特别大的好处",得到的回答是"没有,小班 ses_F 这一交互项 "。处理效应在不同子群之间几乎一样,小班对低 SES 与非低 SES 学生的提升都在 7 到 8 分之间。到这里为止,本书的模型一直把数据当成"学生嵌套在班级里"的两层结构在处理,从随机截距、随机斜率到跨层交互,背后用的都是 (1|tch)。
但读者如果回去翻第 1 章末尾那张图,会注意到一个一直没被处理的事实:79 所学校的数学均值跨度有 124 分,这部分跨校差异在前面所有模型里被悄悄塞进了"班级层"。当一所学校自己的均值偏低 30 分,这所学校里的每一个班级都会在 估计里继承这 30 分的偏差,让"班级方差"看起来比实际大。本章要做的事就是把学校层从班级层里分出来,跑一个完整的三层模型,看看分出来之后小班效应会变成什么样。
三层嵌套的结构:学生、班级、学校
为了让"为什么要加学校层"不只是一个统计学口号,先用一个生活类比把三层嵌套讲清。
想象一户家族里几代同堂。最底下是孩子,每个孩子有自己的脾气与天赋;中间一代是父母,同一对父母带的几个孩子共享家庭的教养方式、餐桌习惯、作息节奏;最上面是祖辈,同一个祖父祖母往下分出去的几对父母,又共享更上层的家训、家族财力、家族口碑。如果想解释"这家的孩子为什么学习成绩好",把每个孩子当独立样本来看会漏掉父母层面的相似性,把父母当独立样本看又会漏掉祖辈带来的家族影响。
STAR 数据的三层结构正是这副族谱。学生对应孩子,每名学生有自己的个体差异;班级对应父母,同一班的 17 个学生共享一位老师、一间教室、一种学习氛围;学校对应祖辈,同一所学校的 4 个班共享一个校长、一份生源、一个社区。前面所有章节用的 (1|tch) 只承认了"父母层面的共享",把祖辈这一层默认为不存在。
停下来想一想。 如果一所学校所在的社区里平均家庭背景较好、师资稳定、教学传统强,这所学校的所有班级都会在分数上整体偏高。如果不把这部分"学校层共同优势"独立出来,它会被错算成班级层的"班际波动",让人误以为"班际差异"比实际更大。
嵌套随机效应与三层模型形式
对一份三层嵌套数据(学生 在班级 在学校 ),结果 的最简三层模型为
其中三个随机项相互独立: 是学校 的随机截距偏差, 是嵌套在学校 里的班级 的随机截距偏差, 是学生层残差。随机截距 嵌套在 之内,意味着不同学校里的"班级 1"是完全不同的班级、不共用同一个 。这是"嵌套"区别于"交叉"的核心要求。
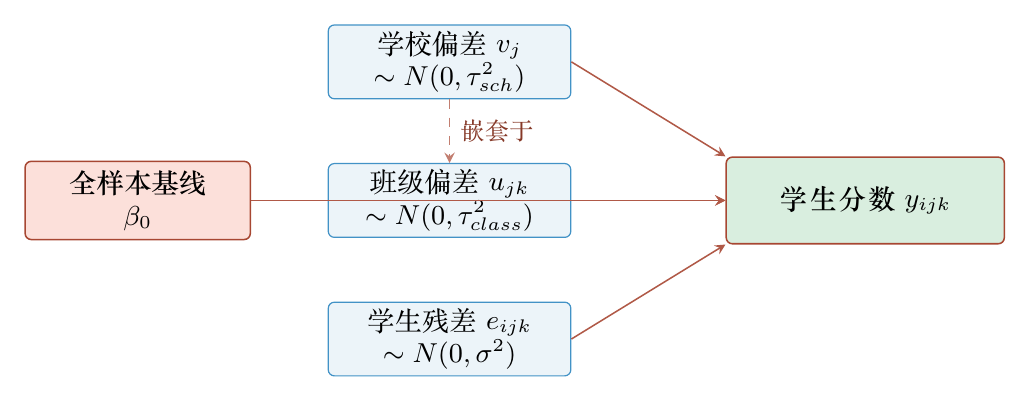
公式里的三层结构对应着族谱里的三代。 是全样本期望均值,所有学校、所有班级、所有学生的"基准线"; 把学校 拉离这条基准线,所有这所学校里的班级与学生都共享这一份偏差; 在学校 内部再把班级 拉离学校均值,本班所有学生再共享这一份偏差; 把学生 在班级均值之上做最后一次个人波动。
为什么要用"嵌套"而不是"交叉"?因为 STAR 里的"班级 1"在 79 所学校里指的是 79 个完全不同的班级,没有任何理由让它们共享同一个班级随机效应。这与"星期一在所有学校都是星期一"的交叉结构不同:星期一这个"组"在不同学校之间确实是同一回事。lme4 的 (1|sch/tch) 语法等价于 (1|sch) + (1|sch:tch),它告诉模型"班级 只在学校 里有意义",自动把跨校的同名班级当成不同的随机单元。
对三层空模型 ,总方差被拆成
对应三个组内相关系数:
其中 是同一所学校两名学生的预期相关性, 是同一所学校同一班级两名学生在学校层效应已扣除之后剩余的相关性, 是纯学生层差异占总方差的比例。三者相加等于 1。
数字例子可以让这套公式落地。先看 STAR 三层空模型的真实输出。
三层空模型:把方差拆成学校 / 班级 / 学生三块
跑空模型只需要把 (1|tch) 换成 (1|sch/tch),剩下完全一样。下面这段代码先拟合三层空模型,再把三个方差分量与对应的 ICC 输出。
library(tidyverse)
library(lme4)
library(lmerTest)
library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch), !is.na(sch),
         !is.na(sx), !is.na(eth), !is.na(ses)) |>
  mutate(
    sex_F  = ifelse(sx == "F", 1, 0),
    eth_B  = ifelse(eth == "B", 1, 0),
    ses_F  = ifelse(ses == "F", 1, 0),
    cltype = factor(cltype, levels = c("reg", "reg+A", "small"))
  )

# 三层空模型:班级嵌套在学校里
m0_3l <- lmer(math ~ 1 + (1 | sch/tch), data = d, REML = TRUE)
as.data.frame(VarCorr(m0_3l))
#         grp        var1  vcov
# 1   tch:sch (Intercept)   283
# 2       sch (Intercept)   365
# 3  Residual        <NA>  1492
三层空模型把 STAR 数学分数的总方差 2,140 拆成三块。学校层方差 ,对应 。班级层方差(学校已扣除),对应 。学生层残差方差 ,对应 。三个 ICC 之和恰好为 1。STAR 里的"嵌套相关"被这三块各分一份,学校层占了 17%,与班级层的 13.2% 量级相当。
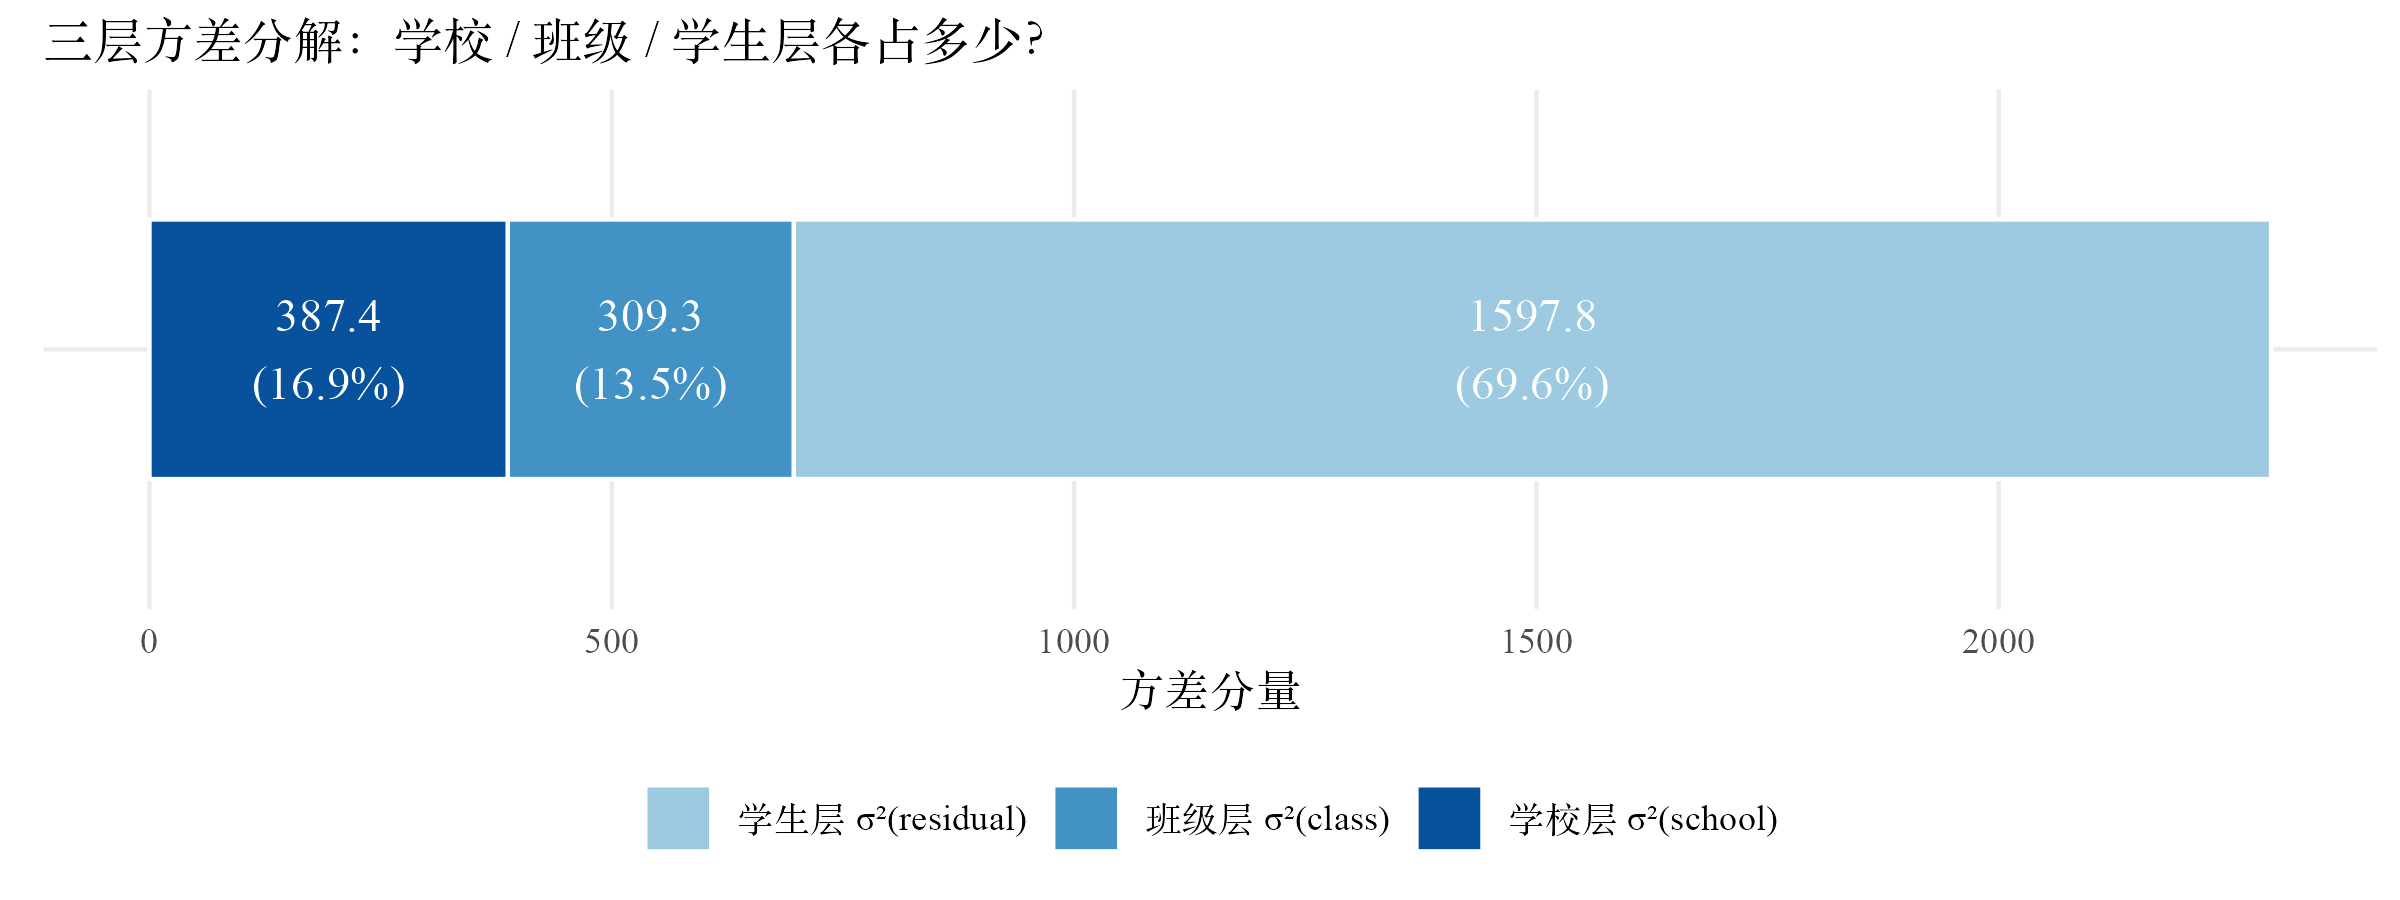
把这三个 ICC 跟第 3 章的二层空模型对比一下就能看出区别。二层空模型给出的"班级层方差"是 689,对应 ICC 30.2%。这 689 在三层分解之后,分裂成了 和 两块,加起来恰好 648,跟二层的 689 非常接近。这不是巧合:如果不让模型看到"学校"这个层级,所有学校层的系统性差异只能被堆进班级层。二层的"班级方差"实际上是"学校 + 班级"两层方差的混合体。
停下来想一想。 如果一所学校的所有班级都比全样本均值高 19 分(),二层模型只能把这 19 分塞进每个班的 里,让"班际差异"看起来更大。三层模型能识别出"这 19 分是同一所学校共享的",把它从班级层挪到学校层,班级层只剩"学校已扣除之后班际还剩下多少差异"。
学校层随机截距 BLUP 的分布
三层模型还顺便给出每所学校的随机截距 BLUP ,相当于"扣掉班级与学生层效应之后,这所学校相对全样本均值高出多少分"。把 79 所学校按 BLUP 排序画出来,就能直观看到学校层的实际差异。
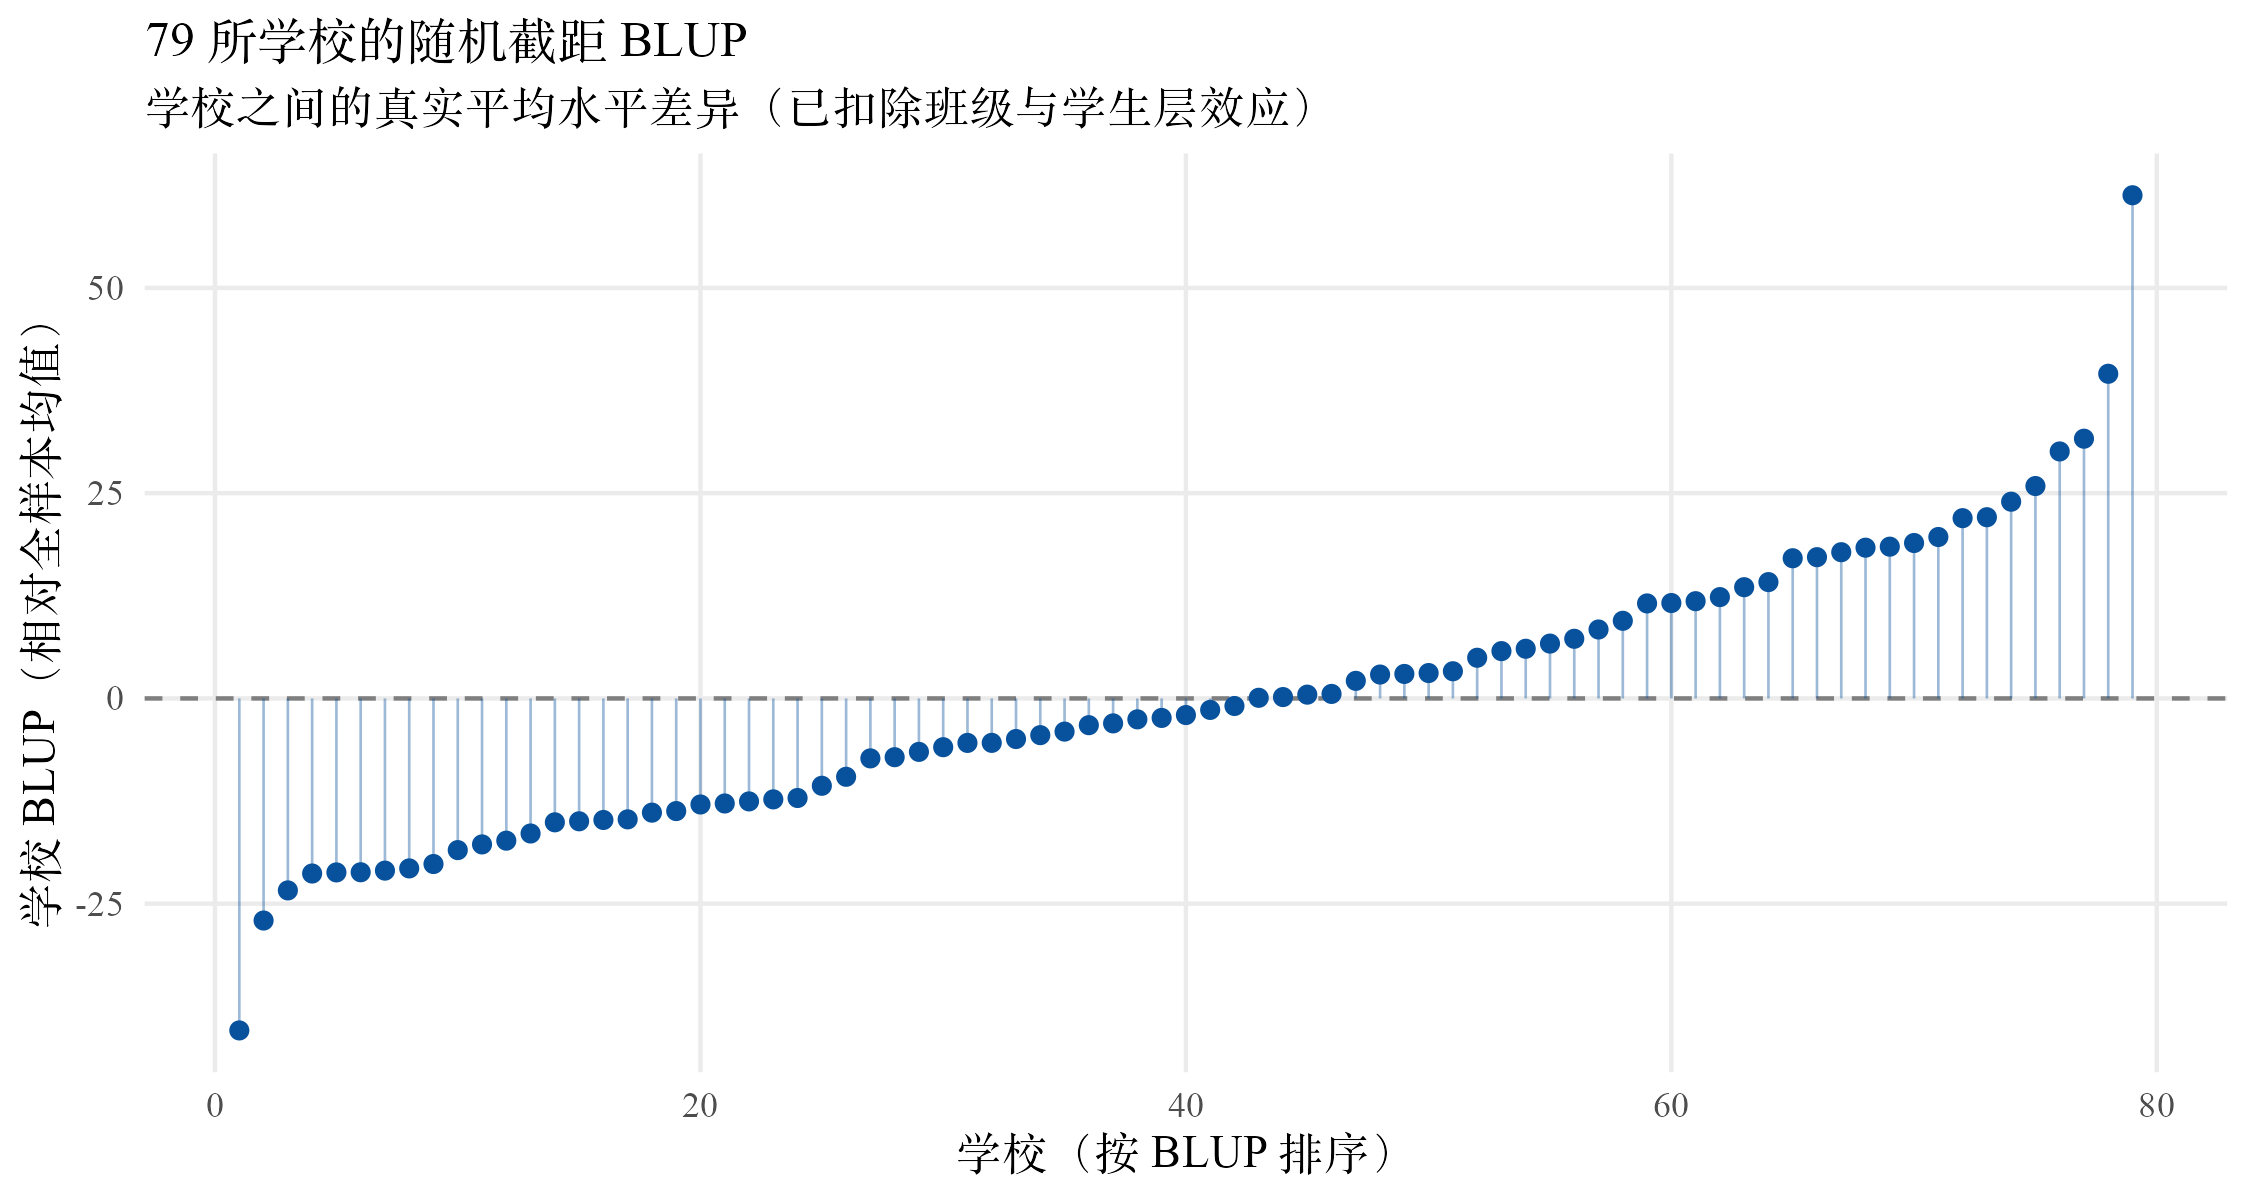
读这张图的方法是看横向的扩展度。BLUP 从大约 到 横跨 60 分,意味着最差的学校"基准线"比最好的学校低 60 分左右。这 60 分跟"小班 vs 常班"的 8 分差距相比是非常大的——学校之间的系统性差异远大于处理效应本身。如果不把学校层扣出来,处理效应估计就要在这 60 分的噪声里挣扎。
为什么这些 BLUP 不集中在零附近?因为 ,所以单所学校的 BLUP 大致在 到 之间散开(按正态假设的 95% 范围)。图上看到的散布幅度跟这个理论值非常吻合。
加上协变量与处理变量:三层模型的完整版
把第 4 到第 7 章的所有协变量装进三层模型,得到本书目前为止最完整的形式:
其中 cltype 是处理变量(小班 vs 常班 vs 常班+助教),三个学生层协变量是性别、族裔、SES,随机部分是嵌套在学校里的班级随机截距。
m_3l_full <- lmer(math ~ cltype + sex_F + eth_B + ses_F +
                    (1 | sch/tch),
                  data = d, REML = TRUE)
summary(m_3l_full)$coefficients
#                Estimate Std. Error      df t value  Pr(>|t|)
# (Intercept)    491.94      2.99   158.7  164.69  <2e-16
# cltypereg+A      0.00      2.85   239.9    0.00   1.000
# cltypesmall      8.84      2.63   233.6    3.36   0.001
# sex_F            6.12      0.97  5429.9    6.32   3e-10
# eth_B          -10.89      2.34   126.3   -4.66   8e-06
# ses_F          -19.86      1.20  5544.5  -16.49  <2e-16

# 二层版本(同一份协变量,没有 sch)作为对比
m_2l_full <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | tch),
                  data = d, REML = TRUE)
summary(m_2l_full)$coefficients["cltypesmall", ]
#  Estimate Std. Error         df    t value   Pr(>|t|)
#     7.68       3.63       321.1     2.12      0.035
小班相对常班的处理效应在三层模型里是 8.84 分,标准误 2.63,。跟二层模型的 7.68 分(SE = 3.63,)相比,点估计更大、标准误反而更小。这是本章最反直觉的结果:加进一层随机效应,理论上在拟合更复杂的模型,反而把"小班效应"的不确定度压低了。
解释这件事的关键在于把"学校层"看清。二层模型把学校层差异塞进班级层 ,让 变成"两层差异之和",这个膨胀的方差直接进入小班效应的标准误估计。三层模型把它分开:班级层只剩 ,跨校系统性差异被 单独承担。处理变量 cltype 是在班级层变化的,它的标准误主要受班级层方差影响,班级层方差变小,处理效应的 SE 自然下降。
这里要再仔细看一下方差分解的对应关系。三层模型 + 全协变量下,、、两者相加 。二层模型 + 全协变量下,。两个数字相差不到 2%。这是一条干净的加和关系:
其中 是二层模型估出来的"班级层方差", 与 是三层模型估出来的两个分量。二层模型不是"算错"了,它只是没有把学校层独立出来,所有学校层差异只好寄居在班级层方差里。加和关系告诉我们两层方差与三层方差总量相等,区别在分配方式。
停下来想一想。 小班效应的 SE 由"班级层方差占整体的比例"决定(因为处理是班级层变量)。二层模型的班级层方差是 638,三层模型的班级层方差是 283,分子从 638 变成 283,SE 自然从 3.63 降到 2.63。三层模型让 SE 下降的原因不是"模型变复杂了所以拟合得更紧",而是"它把原本错算到班级层的方差挪走,让真正属于班级层的方差归位"。
LRT 检验:三层 vs 二层的模型对比
加上学校层这一层值不值?方差分解里 已经占总方差 17%,是不是显著到必须独立成一层,还要做正式的统计检验。
对"是否引入额外随机效应"的检验,标准做法是似然比检验(LRT, likelihood ratio test)。两个模型一个是简化版(只有班级随机截距),一个是完整版(再加学校随机截距),用 ML 拟合两个模型,把对数似然之差乘以 2,对照 分布查临界值。零假设是"学校层方差为零,两层模型已经足够"。
# LRT 必须用 ML 拟合
m_2l_ml <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | tch),
                data = d, REML = FALSE)
m_3l_ml <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | sch/tch),
                data = d, REML = FALSE)
anova(m_2l_ml, m_3l_ml)
#           npar   AIC   BIC  logLik deviance  Chisq Df Pr(>Chisq)
# m_2l_ml      7 59218 59272 -29602    59204
# m_3l_ml      8 59130 59190 -29557    59114  90.68  1   <2.2e-16
LRT 给出 ,自由度为 1(多估了一个 ),,拒绝"学校层方差为零"的零假设。AIC 也从 59,218 降到 59,130,下降 89 个单位。按经验法则 已支持复杂模型,89 显著超过这个门槛。STAR 数据里的学校层不是边缘效应,是模型必须诚实承认的层级。
LRT 在"检验方差分量是否为零"时有一个微妙之处:方差不能为负,零假设是参数取在参数空间边界上,标准的 临界值是保守的,真实的零分布是 的混合分布(Self & Liang 1987, Stram & Lee 1994)。本数据 远高于任何合理临界值,这点细节不影响结论;但读者将来跑临界值附近的 LRT 时要记得这件事。
如果数据有学校层但只用 (1|tch) 拟合,模型会把学校层的系统性差异强行塞进班级层随机截距。最直接的后果是班级层方差被伪膨胀——本数据里 从真实的 283 涨到 638,看上去班级之间的差异比实际大一倍多。膨胀的方差又会传染给处理效应标准误:处理变量 cltype 在班级层变化,它的 SE 受班级层方差影响,本数据二层 SE 是 3.63、三层 SE 是 2.63,差距正来自这部分错算。除此之外,学校层 BLUP 拿不到也是一笔损失:想知道"哪所学校特别好、哪所特别差",二层模型完全没有这个估计,只有 (1|sch/tch) 才会在 ranef 里返回 $sch 这一项。
诊断方法:跑空模型时同时拟合二层与三层,比较 跟 。如果两者接近、且 占总方差超过 5%,就必须用三层模型。
累积对比表更新
把本章给出的两条结果——三层空模型与三层 + 全协变量——加进累积对比表。表头新增一列 ,前面几行的这一列填 —(二层模型没有这个分量)。
表 8·1 第 5 至第 8 章的小班效应累积对比
| 方法 | small | SE | ||||
|---|---|---|---|---|---|---|
| OLS 朴素 | 8.21 | 1.56 | 0.001 | — | — | 2,264 |
| OLS + 学生协变量 | 8.13 | 1.50 | 0.001 | — | — | 2,104 |
二层 (1|tch) | 7.90 | 3.76 | 0.036 | — | 685 | 1,597 |
| 二层 + 学生协变量 | 7.68 | 3.63 | 0.035 | — | 638 | 1,492 |
三层 (1|sch/tch) | 8.91 | 2.67 | 0.001 | 366 | 288 | 1,598 |
| 三层 + 学生协变量 | 8.84 | 2.63 | 0.001 | 365 | 283 | 1,492 |
读这张表的关键在两处。第一处是 small 那一列从 7.68(二层 + 学生协变量)跳到 8.84(三层 + 学生协变量),点估计变大约 1.2 分。这部分变化来自学校层被独立出来后,处理效应不再被错误地"分摊"给学校层差异,模型把这 1.2 分还给了 cltype。第二处是 SE 列同时从 3.63 降到 2.63, 值从 0.035 缩到 0.001。点估计变大、不确定度变小,处理效应的统计支持显著加强。
从主估计到模型诊断的过渡
到本章为止,本书的模型已经包含学生层协变量、班级层处理变量与学校层随机截距,形式上是教育学多层建模文献里非常完整的标准三层模型——这套结构的提出可以追溯到 Raudenbush 与 Bryk 1986 把 HLM 推广到三层的工作,以及 Goldstein 1987 在英国教育数据上的并行发展,两条线后来汇合成今天的多层建模标准教材。本数据的结论是:小班相对常班 +8.84 分,95% CI 大致 ,,比第 5 章二层估计的 7.68 分更大、不确定度更小。
但模型给出""这个结论之前,需要做最后一道工序:检查模型本身是不是合身。残差有没有系统性偏离假设?正态性在三层都成立吗?某些班级或学校的 BLUP 是不是大到能单独驱动整个估计?这些问题构成第 9 章的内容。
第 9 章把这道工序补上。在三层 + 全协变量这个主模型上,先按层级把残差拆开看:学生层残差、班级层 BLUP、学校层 BLUP 各自服不服从正态。再画 QQ 图诊断尾部偏离。最后做 leave-one-class-out 敏感性分析,逐个删除班级重新拟合,看看小班效应估计在不同子样本下的漂移幅度,回答"主结论是不是被一两个班的极端表现绑架"。把诊断这一关过了,第 10 章才能放心地把全书所有方法的结果摆在一起做最终对比。