第 5 章把处理变量 cltype 加进 Level-2,得到本书核心的 分小班效应。模型里所有学生层协变量(性别、族裔、家境)的斜率都被默认为所有班级共享同一个值。比如低 SES 学生比非低 SES 学生平均低 分,这个差距被假定为每个班级、每位老师都一样。
但这个假设其实很强。有的班级里老师特别善于照顾家境困难的学生,让 SES 差距收窄;另一些班里这个差距可能拉得更大。把这种"斜率本身在班际变动"的可能性写进模型,就是本章要做的事。技术上叫随机斜率(random slope)。本章用 STAR 数据跑出来,明确给出一个负面结论:在这份数据上,SES 斜率的班际异质性几乎不存在。但负面结论也有教学价值——它告诉读者随机斜率不是想加就加,需要 LRT 给出依据。
随机斜率:让协变量的影响在组间变化
先看一个生活类比:每个班对低 SES 学生的"关照度"不同
想象同一个学区里两位老师。第一位老师特别擅长辅导家境困难的学生,会主动给免费午餐学生留作业本、组织放学后的小组学习。在她的班里,低 SES 学生跟非低 SES 学生的分数差距可能只有 10 分。第二位老师完全按教材进度走,从不针对差异学生做调整,他班里低 SES 学生跟非低 SES 学生的差距可能拉到 25 分。
如果用 M5 那种"全班级共享一个 SES 斜率"的模型来分析这两个班,得到的会是一个平均斜率——大概 分,但这个数字模糊掉了班际的真实差异。把"每位老师对低 SES 学生的关照度"作为班级的另一个特征写进模型,就是随机斜率要解决的问题。
随机斜率的概念可以简单说成:斜率不只一个,每个班一个,全样本的斜率分布有均值有方差。均值就是 M5 给出的固定斜率 ,方差是新东西,叫斜率的随机方差。
随机斜率的形式定义与几何含义
设 是学生 在班级 的某个协变量(如 ses_F)。随机斜率模型把这个协变量的斜率允许在班级之间变化:
其中 是固定效应(全样本的平均截距与平均斜率), 是班级 的随机截距偏差, 是班级 的随机斜率偏差, 是学生残差。
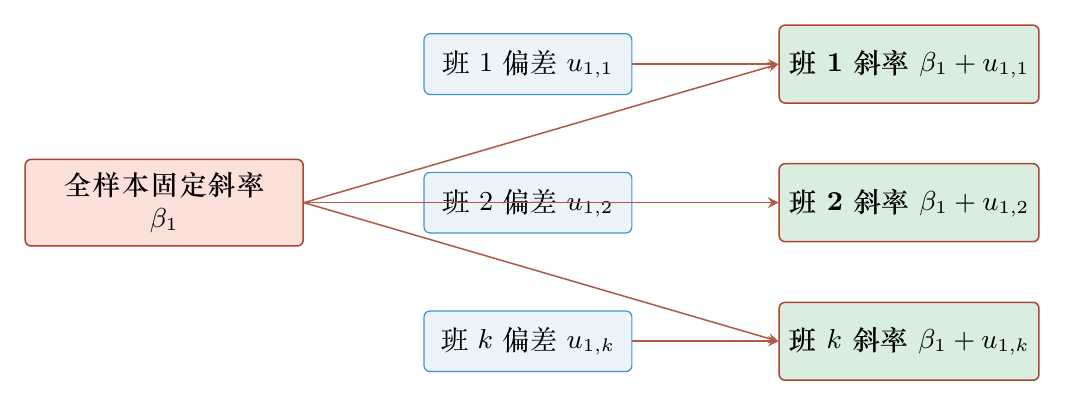
公式里 是新东西。它的含义是"第 个班级的 SES 斜率比全样本平均斜率 多出多少"。 的班级里,低 SES 学生跟非低 SES 学生的差距比平均小(因为 是负数,加上正的 等于差距变小); 的班级里,差距比平均更大。 度量了这种班际异质性的强度,是模型新引入的参数。
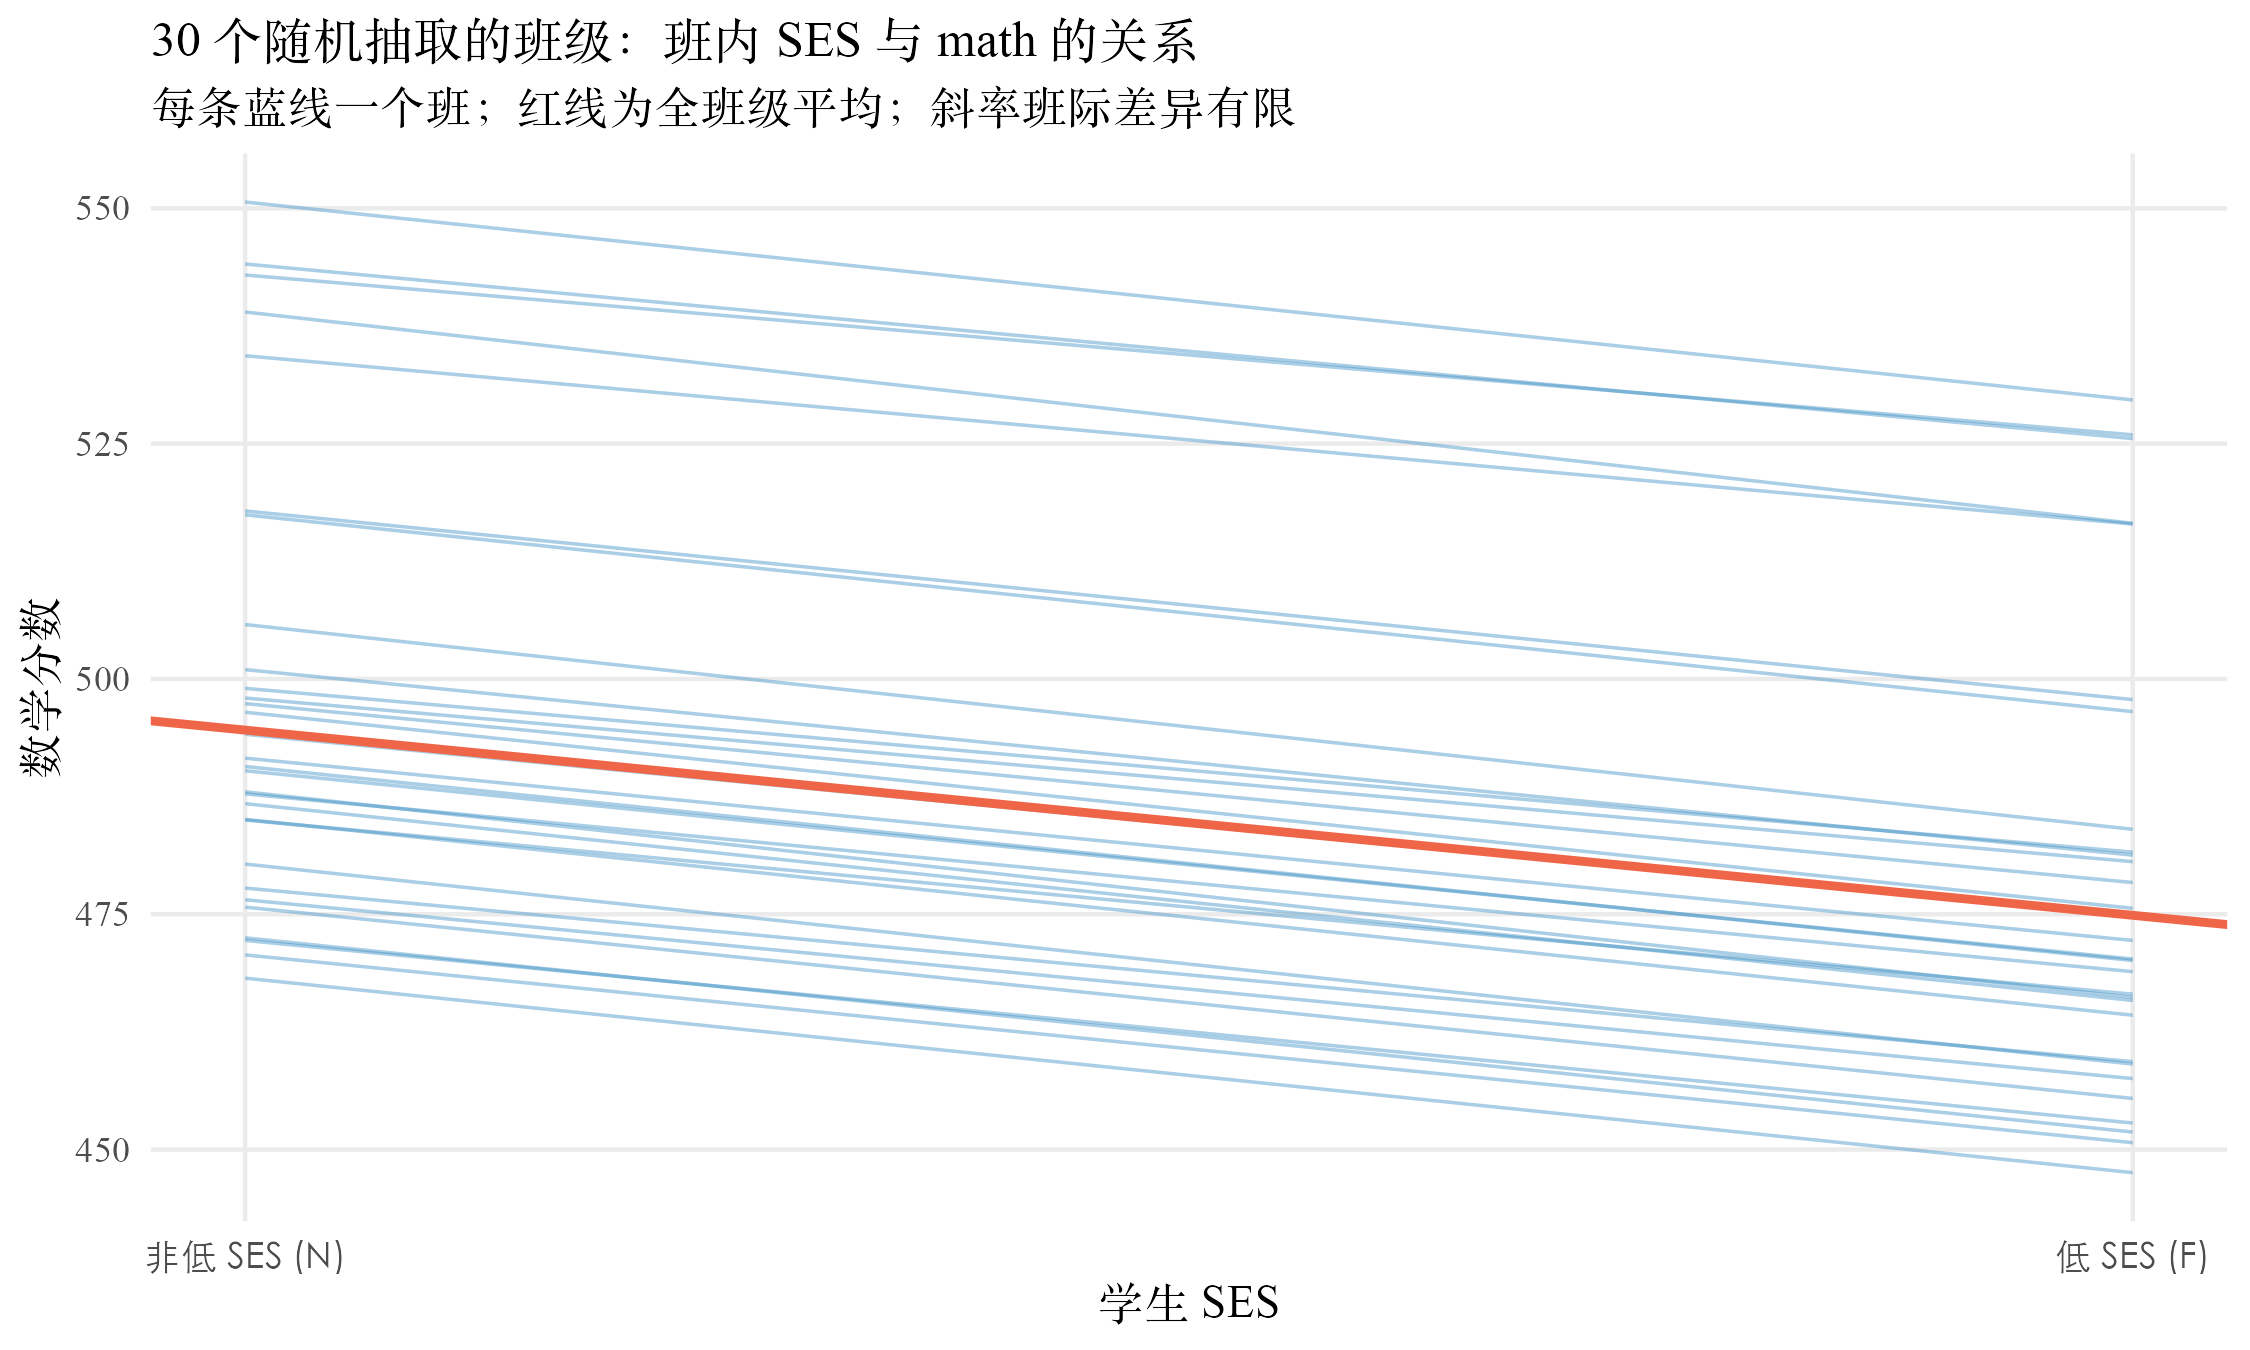
几何上,M5 的拟合给出一条共同的直线(截距随班级变,斜率不变)。M7 的拟合给出每班一条直线(截距和斜率都随班级变)。如果 很大,30 个班的 30 条直线会"扇形发散";如果 接近 0,30 条直线几乎平行,跟 M5 给出的一条直线没差。本章要回答的就是 STAR 数据里到底是哪种情况。
随机效应协方差矩阵 G:斜率与截距相关吗
设班级 的随机效应向量为 ,假设它服从二维正态:
其中 是截距的班际方差, 是斜率的班际方差, 是截距与斜率的协方差。
为什么要写出 矩阵?因为它告诉你"截距高的班是不是斜率也大"。如果 ,整体均值高的班同时也是低 SES 差距小的班——这种班可能是优质学校里的精英班,整体水平高且教师补偿能力强。如果 ,平均水平高的班反而对低 SES 学生不照顾,可能是"高水平老师压根没碰过差生"那一类。
lme4 的语法用两种方式写随机斜率。(1 + ses_F | tch) 让截距和斜率随班级变化且相关,估计完整的 矩阵(含 );(1 + ses_F || tch) 让两者独立变化,强行假设 ,只估计 和 两个数。
为什么 lme4 提供这两种?因为完整的 矩阵在小样本下不容易估准, 这个协方差经常贴边——非常接近 或非常接近 0。分析者如果只关心"斜率有没有班际变化",用独立写法(双竖线)就够了,参数少一个,模型更稳。本章先跑独立写法的 M7 给出 LRT 结论,再跑相关写法的 M8 让读者感受两者的差别。
学术背景:Goldstein 1986 的随机系数模型
随机斜率的统计史可以追到 1980 年代中期。Goldstein (1986) 在 Biometrika 上发表了《多层混合线性模型分析》,把当时教育统计里"教师效应"和"学生背景"的双层数据结构正式纳入混合模型框架。Goldstein 当时是英国教育统计学会的核心人物,他写的 Multilevel Statistical Models 教材后来成了多层建模领域的基础读物。
随机斜率这个概念在 Goldstein 之前其实已经在统计学里以"随机系数模型"的名字流传(如 Laird & Ware 1982),但 Goldstein 把它跟教育数据的具体结构对齐,让"班级差异不只在均值上、还在 SES 效应上"这种问题变成可以建模的东西。lme4 的 lmer 函数就是直接继承这条工作线索。
M7 与 M8:让 SES 斜率随班级变化
下面用 lme4 把随机斜率加进 M5 的模型,得到 M7(无相关)和 M8(有相关)。
library(lme4); library(lmerTest); library(tidyverse); library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch),
         !is.na(sx), !is.na(eth), !is.na(ses)) |>
  mutate(
    sex_F  = ifelse(sx == "F", 1, 0),
    eth_B  = ifelse(eth == "B", 1, 0),
    ses_F  = ifelse(ses == "F", 1, 0),
    cltype = factor(cltype, levels = c("reg", "reg+A", "small"))
  )

# M5 参照:仅随机截距
m5 <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | tch),
           data = d, REML = TRUE)

# M7:加随机斜率(无截距-斜率相关)
m7 <- lmer(math ~ cltype + sex_F + eth_B + ses_F +
             (1 + ses_F || tch), data = d, REML = TRUE)

# M8:放开截距-斜率相关
m8 <- lmer(math ~ cltype + sex_F + eth_B + ses_F +
             (1 + ses_F | tch),  data = d, REML = TRUE)

# LRT 检验:M5 vs M7(用 ML 拟合,REML 不能直接做 LRT)
m5_ml <- update(m5, REML = FALSE)
m7_ml <- update(m7, REML = FALSE)
anova(m5_ml, m7_ml)
LRT 给出的关键数字是 ,自由度 1,p 值 。
LRT 的 p 值 显著高于 ,随机斜率不显著。这意味着加进 这个新参数并没有让模型显著变好,本数据里 SES 斜率在班级间的变化跟"全用同一个斜率"的假设统计学上无法区分。
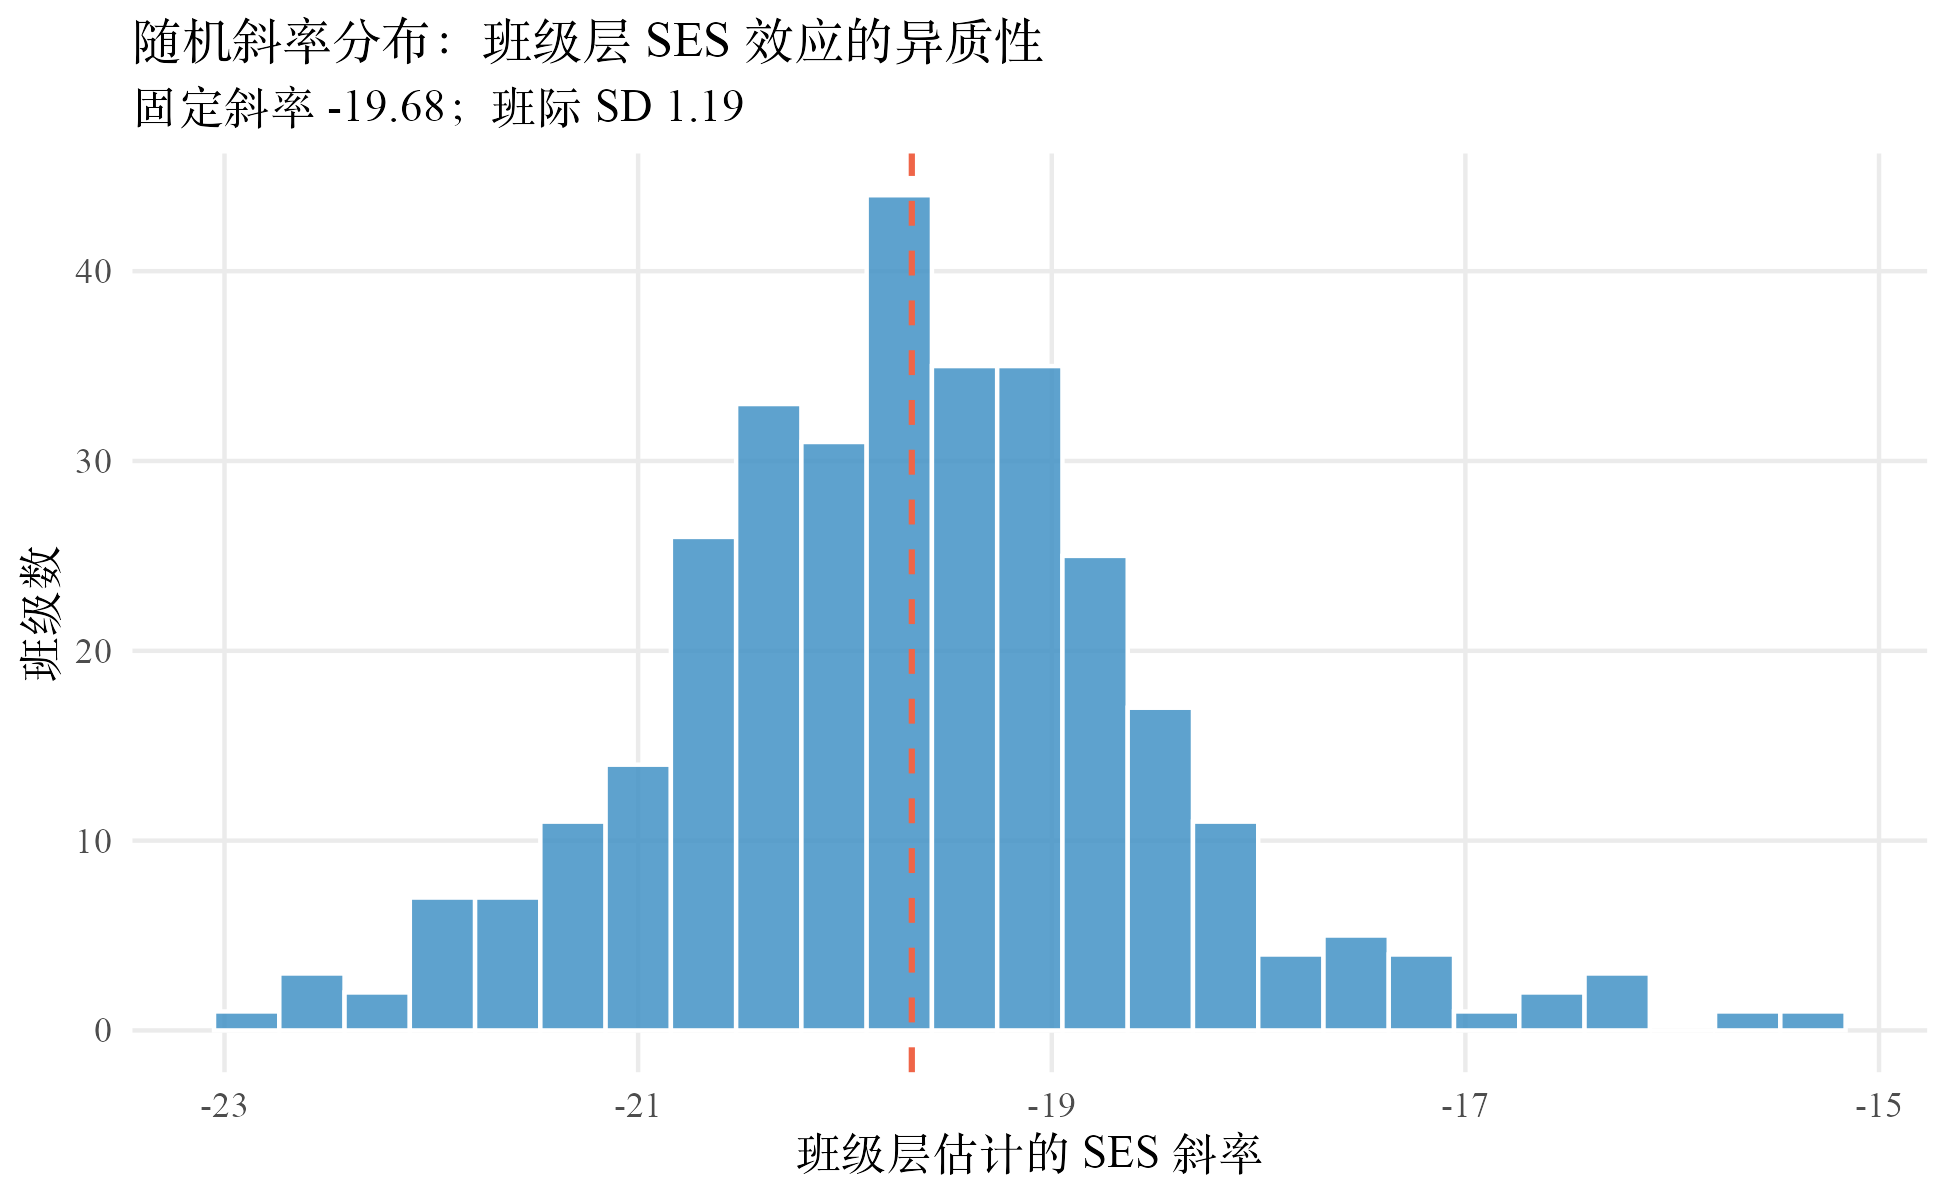
从数字看,固定 SES 斜率是 分,班级层斜率 BLUP 的 SD 大约是 ,班际斜率 SD 占固定斜率的 左右。也就是说,估计出来的"班际斜率波动"绝对值很小——绝大多数班的 SES 斜率都在 到 之间,跟全样本平均几乎没差。
这跟第 5 章的小班效应相反。小班效应数字大( 分)且显著(p 0.035),随机斜率参数小(SD 1.19)且不显著(p 0.46)。两个对比放在一起恰好让读者感受到"哪些异质性该建模、哪些不该"。
把代码跑完后,画一张 spaghetti 图直观看一下班际斜率的变异:30 个随机抽取班级的 SES 斜率几乎平行,肉眼几乎看不到扇形发散;再把每个班的 SES 斜率取出来画成直方图,分布也极度集中在固定斜率 分附近,班际 SD 仅 。
方差成分检验的雷区:边界问题与 p 值减半
LRT 给出 p 0.46 这个数字之前,还有一个边界问题需要交代清楚,本节把这个细节补上。
否则会偏保守。
原因是零假设处于参数空间的边界。检验""时, 这个参数本身只能取非负值,零假设就在 的左端点。在这种边界情形下,似然比统计量的渐近分布不再是标准的 ,而是 的混合分布——一半概率取 0,一半概率取 。
实际效果是:anova 默认按 算 p 值,偏向把模型差异看小。正确做法是把 anova 给的 p 值除以 2,或者用 RLRsim 包做参数 bootstrap。
诊断方法。 如果 anova 给的 p 值在 到 之间,把它除以 2 后可能会跨过 显著线,结论会反转。这种"擦边球"案例最危险。本章 STAR 数据的 p 值 即使除以 2 也是 ,远大于 ,结论不变;但如果你看到的 p 值是 ,就一定要做这个修正。
记忆方法。 方差成分的 LRT 是"半截 检验",p 值要打五折。
随机斜率不显著的解读:为什么这是个有用的负面结论
LRT 给出 p 0.46,p 值除以 2 也是 0.23,结论稳稳落在"不显著"那边。但负面结论不是"白跑了",它至少告诉读者两件有用的事。
负面结论的第一层含义是 M5 的设定可以放心用。如果随机斜率显著,M5 给出的固定 SES 斜率 就只是一个班际平均,遮住了一些班特别大、一些班特别小的真实异质性。LRT 显示这种异质性在 STAR 数据里小到统计学上不存在,因此 M5 的 可以直接解读为所有班的共同 SES 效应,不需要再追加随机斜率。
负面结论的第二层含义是随机斜率不能"想加就加"。多层模型里有个常见的过度拟合做法,是把每个学生层协变量都设成随机斜率,让模型的方差结构尽可能丰富。但每个随机斜率都要估计 (如果用相关写法还要估计 协方差),参数越多对样本量要求越高,小样本下经常给出"奇怪斜率 + 奇怪协方差"的结果。LRT 的负面结论给"不必要加随机斜率"提供了硬证据。
停下来想一想。 随机斜率不显著是不是意味着"班级老师对学生没影响"?不是。意味着"班级老师对低 SES 学生与非低 SES 学生的差距没有差别"。两位老师可能都让全班整体加 5 分(这进入随机截距 而不是斜率 ),但他们对 SES 差距的处理可能很相似。STAR 数据的随机分配也帮了忙——既然班级是随机分的,"擅长照顾低 SES 学生"的老师不会系统性地集中在某类班级上,整体看起来 SES 斜率就近乎一致。
累积方法对比表更新
把本章的 M7(即使不显著)也加进累积表,让读者直观看到加随机斜率前后小班效应几乎没变化。
表 6·1 累积方法对比(截至第 6 章)
| 方法 | 小班 | SE | 95% CI | |
|---|---|---|---|---|
| OLS 朴素 | 8.21 | 1.56 | [5.15, 11.27] | — |
| M4:cltype + (1|tch) | 7.90 | 3.76 | [0.55, 15.26] | 685 |
| M5:+ 学生协变量 | 7.68 | 3.63 | [0.57, 14.79] | 640 |
| M6:再 + 教师工龄 | 7.73 | 3.61 | [0.66, 14.80] | 632 |
| M7:+ 随机斜率(LRT 不显著) | 7.69 | 3.63 | [0.57, 14.81] | 640 |
M7 这一行只是为了"对比展示"。LRT 既然给出 p 0.46,正式报告里不会保留 M7 作为最终模型,本书后面继续以 M5 / M6 作为基准模型走下去。
下一章预告
第 6 章给出了一个负面结论:低 SES 学生的"分差"在班级之间几乎没有变化。但还有一个更实质的政策问题:小班对低 SES 学生有没有特别的好处?
这个问题问的是"cltype 对 ses_F 的效应有没有差异"——也就是处理变量与学生层协变量的交叉。它需要的工具是跨层交互项,而不是随机斜率。第 7 章会把 cltype * ses_F 加进模型,看四种组合(小班/常班 × 低 SES/非低 SES)的预测均值,并给出明确的政策结论。