第 8 章给出本书的主结论:小班相对常班 +8.84 分,标准误 2.63,。这个结论建立在三层 + 全协变量模型上,它的可信度受两条线牵制——模型假设是不是成立、某些观测是不是单方面在主导整个估计。前者要看残差的分布与正态性,后者要看删掉个别班级或学校之后估计会不会大幅漂移。本章把这两条线都走一遍。
诊断这件事在传统单层回归里相对直接,残差就一份,画一张 QQ 图、一张残差 vs 拟合值图大致就够了。多层模型麻烦在残差有好几份,每一层都有自己的随机项。Snijders 与 Berkhof 2008 在《Diagnostic Checks for Multilevel Models》里专门讲了如何分层诊断;HLMdiag 包是这套思路在 R 里的工程实现。本章不进入 HLMdiag 的所有功能,只把最关键的几张图与几条计算用 lme4 自带的 residuals 与 ranef 跑出来,把诊断的核心逻辑讲透。
多层模型的分层残差结构
要讲清楚多层模型的残差为什么不能混在一起看,先用一个生活类比。
把多层模型预测一名学生分数的过程想象成做三明治。最底下一片面包是全样本均值 ,所有学生的"基础分数"都从这片面包开始。中间夹的是两层奶酪:一层是学校效应 ,整所学校共享一份;另一层是班级效应 ,整个班级共享一份。最上面一片面包是学生层个人偏差 ,每名学生各有一份。三层叠在一起就是模型的预测:
如果某个三明治不好吃,问题可能出在任何一层。底层全样本均值估错( 偏离),中层学校或班级配比不对( 或 服从性差),上层学生层个人波动异常( 尾部太肥)。诊断的目标就是把每一层分开尝一口,看看是哪一层出了问题。
对三层模型 ,三层各自的"残差"含义不同:
Level-1(学生层)残差 是观测分数与模型给出的条件预测之差,由 residuals(model) 返回,反映学生在自己班级均值之上的个人波动。
Level-2(班级层)BLUP 是班级随机截距的最佳线性无偏预测,由 ``ranef(model)$`tch:sch``` 返回,反映班级在学校均值之上的偏离。
Level-3(学校层)BLUP 是学校随机截距的最佳线性无偏预测,由 ranef(model)$sch 返回,反映学校在全样本均值之上的偏离。
三个量分别假设服从均值为零的正态分布,对应方差 、、。诊断时三层各画一张 QQ 图、各算一份描述统计。
为什么不能把三层混在一起检查正态性?因为三层的方差量级差别很大,混在一起会让"哪一层有问题"无法定位。STAR 三层 + 全协变量模型给出 、、,三个尺度差不多但意义完全不同。混合检查只会得到"加权平均的尺度",把任一层的小问题平均掉。
学生层残差:QQ 图与方差稳定性
从学生层残差开始诊断。它数量最大(5,768 个),最容易看出尾部偏离。下面这段代码先把残差从主模型里抓出来,再画两张图:残差 vs 拟合值的散点图(检查方差是否随预测值变化)、QQ 图(检查正态性)。
library(tidyverse)
library(lme4)
library(lmerTest)
library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch), !is.na(sch),
         !is.na(sx), !is.na(eth), !is.na(ses)) |>
  mutate(
    sex_F  = ifelse(sx == "F", 1, 0),
    eth_B  = ifelse(eth == "B", 1, 0),
    ses_F  = ifelse(ses == "F", 1, 0),
    cltype = factor(cltype, levels = c("reg", "reg+A", "small"))
  )

# 主模型:三层 + 全协变量
m <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | sch/tch),
          data = d, REML = TRUE)

res_l1 <- residuals(m)        # 学生层残差
fit_l1 <- fitted(m)
sd(res_l1)
# [1] 38.62

# 班级层 BLUP 与学校层 BLUP
re <- ranef(m)
class_blup  <- re$`tch:sch`[, "(Intercept)"]
school_blup <- re$sch[, "(Intercept)"]
sd(class_blup)
# [1] 16.83
sd(school_blup)
# [1] 19.10
三层残差 / BLUP 的 SD 跟模型估出的方差分量基本对应:学生层残差 SD = 38.62,班级层 BLUP SD = 16.83,学校层 BLUP SD = 19.10。三层各自的"尺度"跟 、、 一致。BLUP 的 SD 通常会略小于 ,因为 BLUP 本身经过收缩;本数据两者非常接近,说明信息量充足,收缩程度有限。
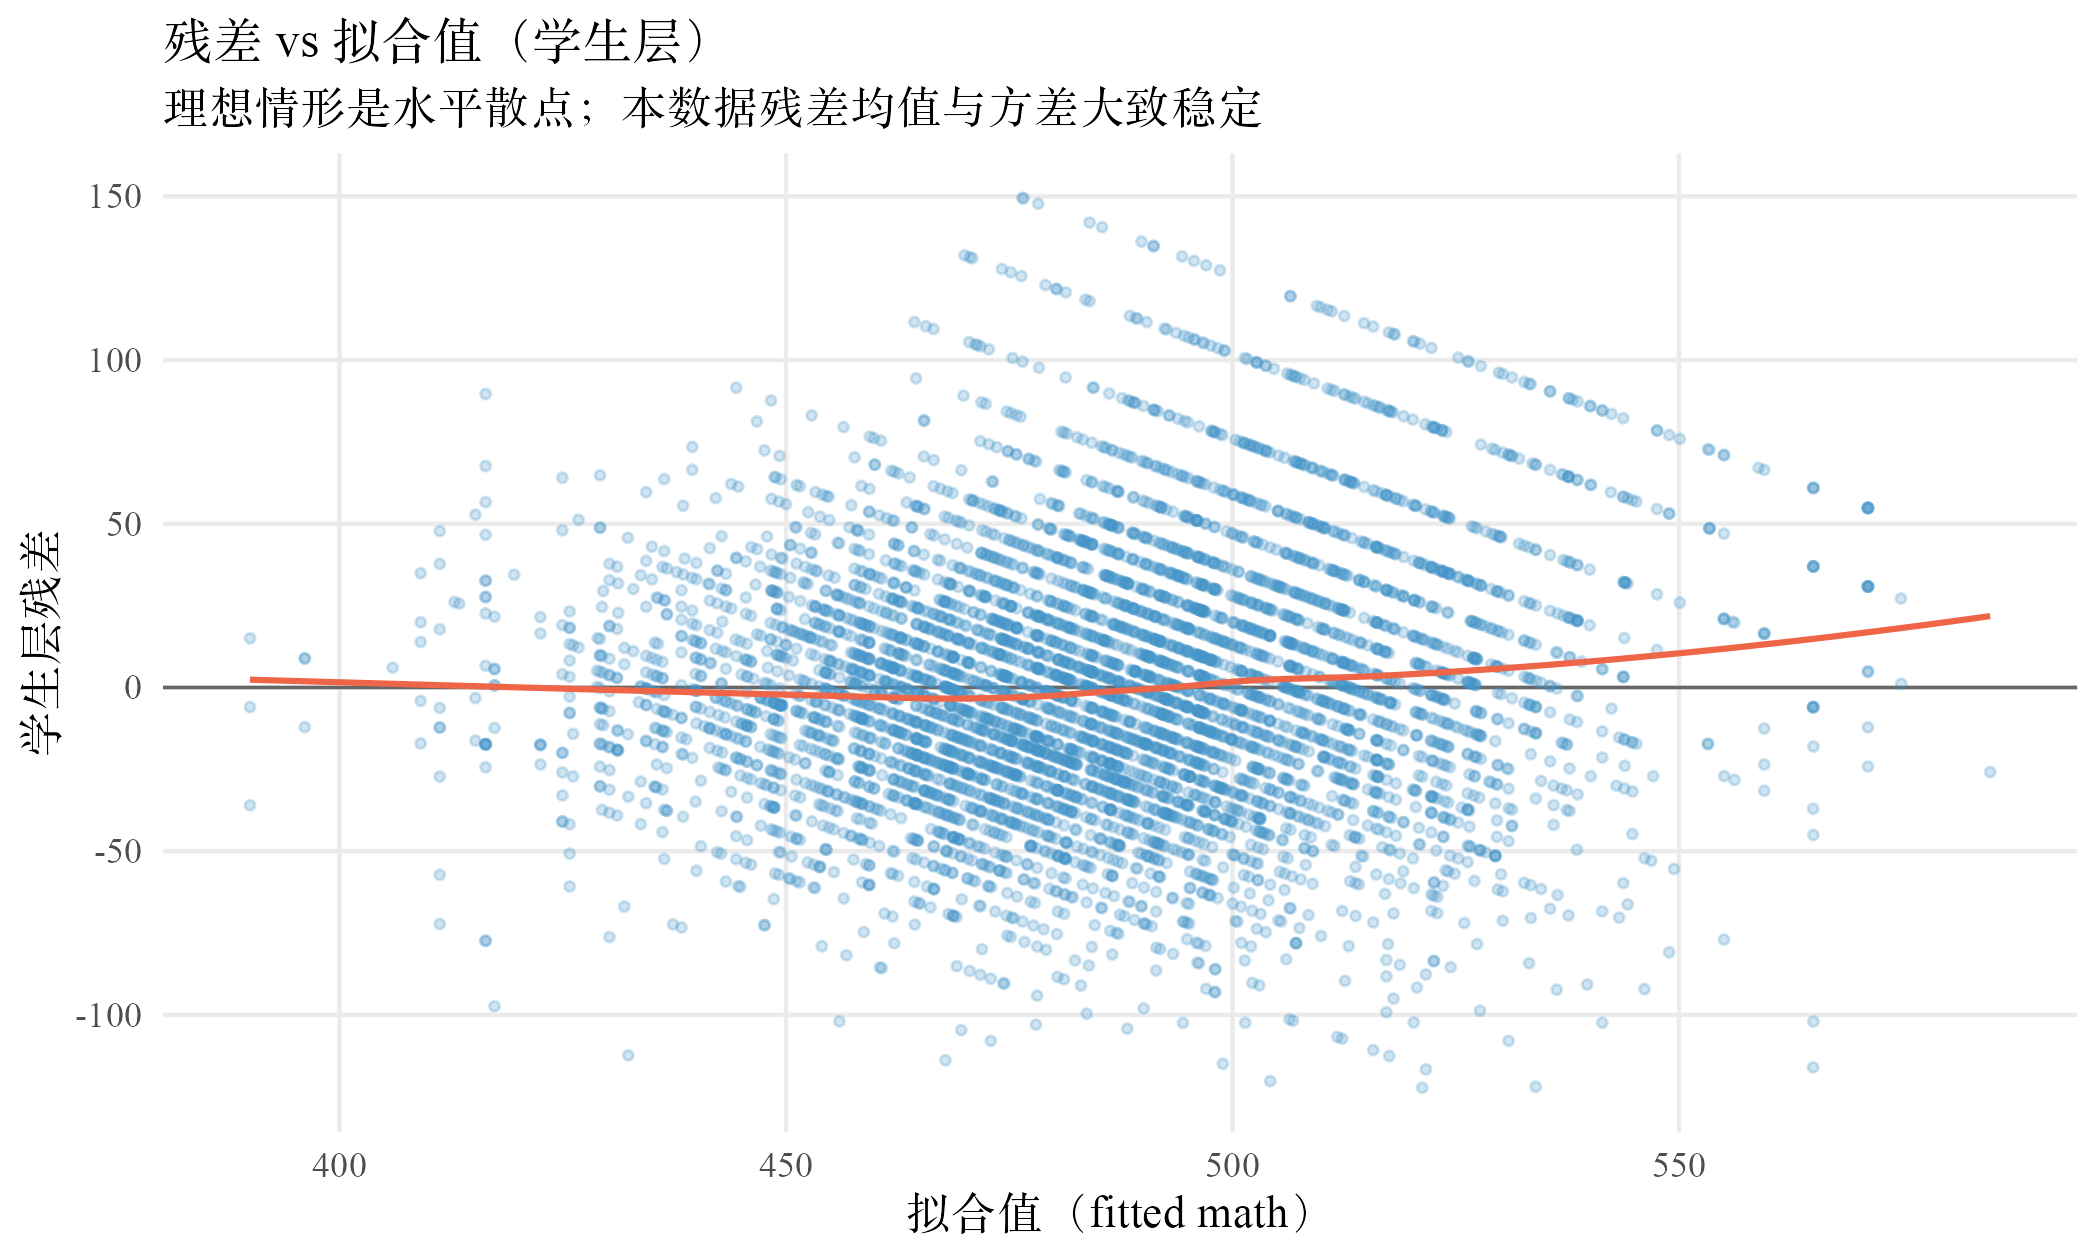
读残差 vs 拟合值这张图的方法是看横向带状的均匀程度。理想情形是散点像水平的香肠,中线在零附近,宽度沿横轴稳定。本数据的散点确实大致呈水平带状,loess 平滑曲线靠近零线,没有明显的弯曲或漏斗形。这告诉我们模型的固定效应结构(cltype + 学生协变量)大致捕捉了"学生分数随这些预测变量怎么变"的趋势,残差里没有系统性的未解释模式。
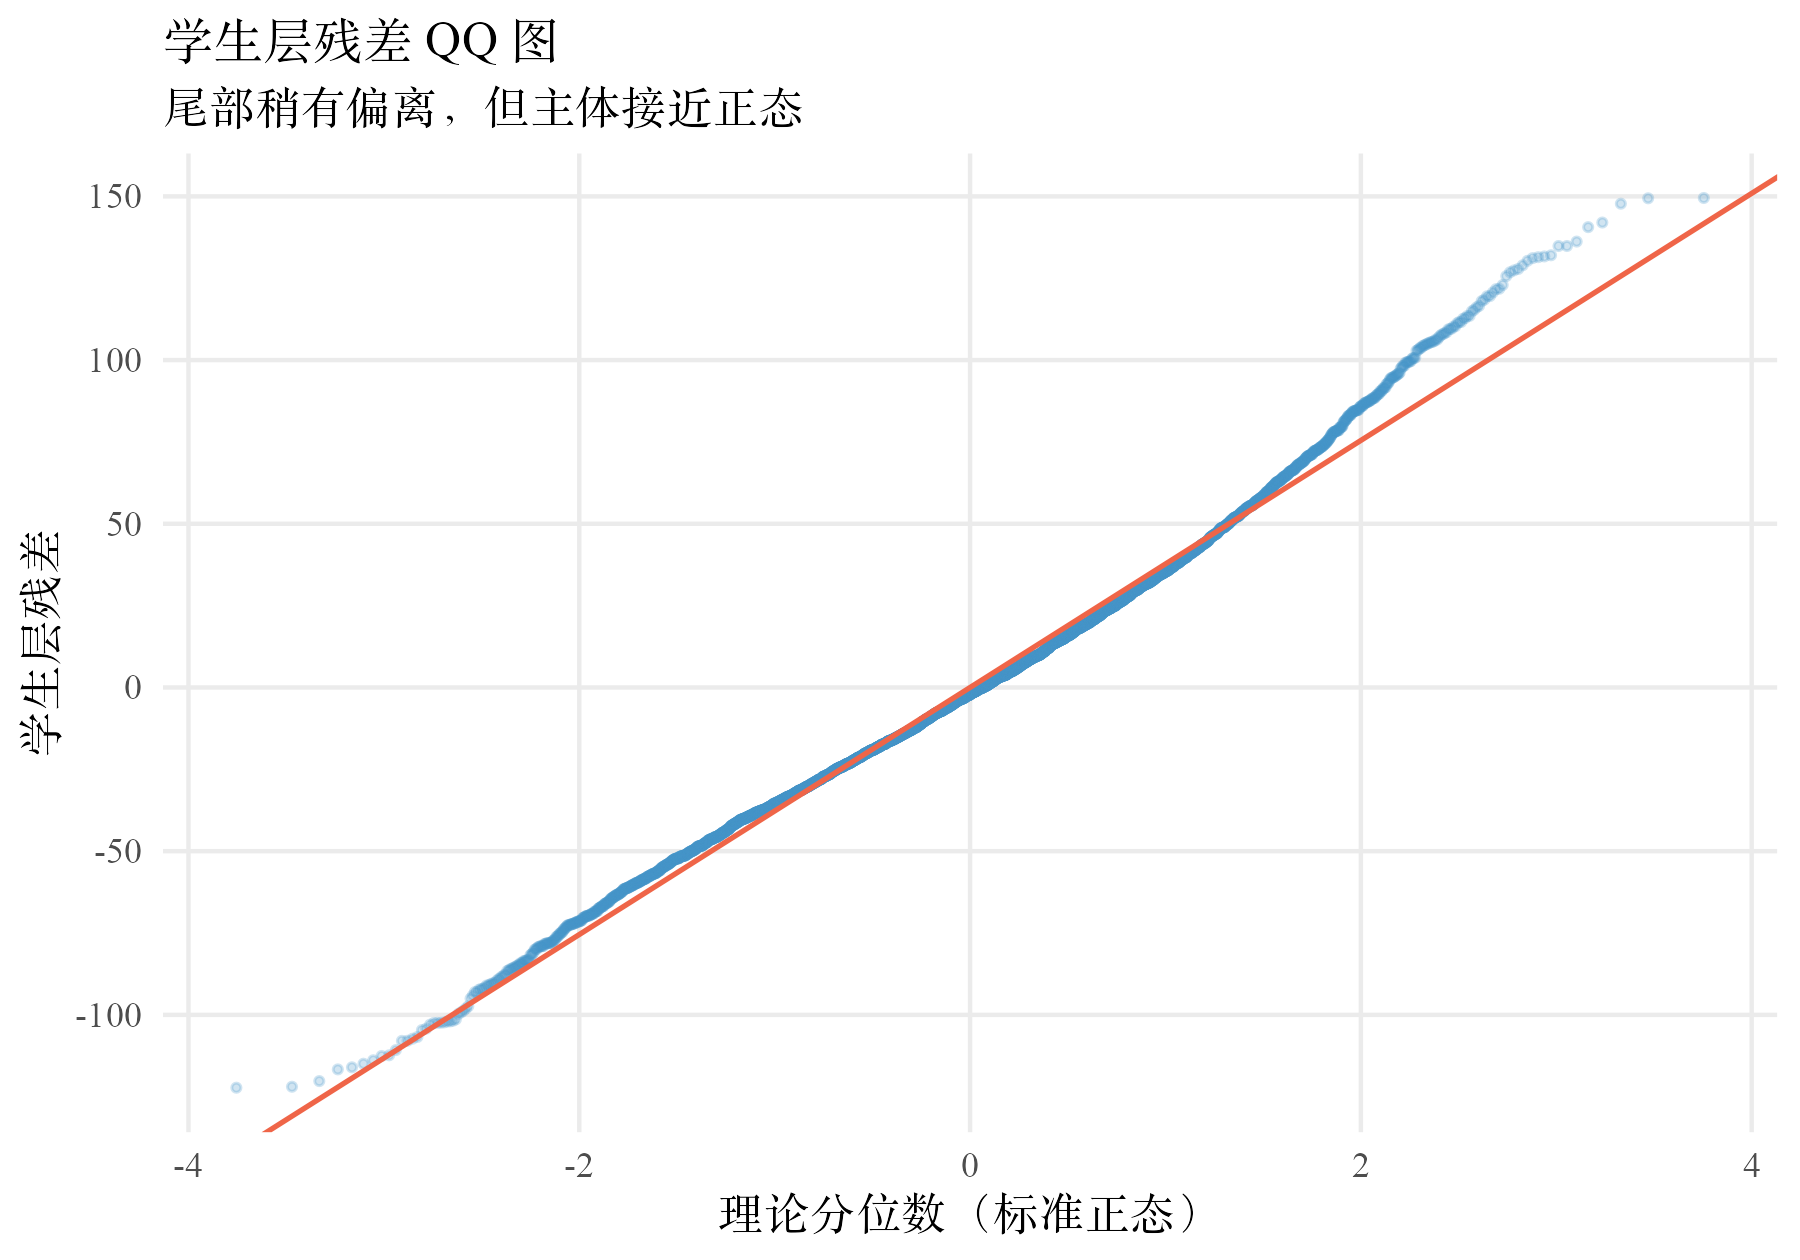
QQ 图判断正态性的方法是看散点是否沿对角线排开。中间段贴得越紧越接近正态,两端偏离越远尾部就越肥。本数据 QQ 图主体非常贴线,覆盖大约 到 个标准正态分位数的区间;只在两端约 与 之外有少量偏离,表现为低端略低于理论值、高端略高于理论值。这是尾部稍翘但不严重的典型形态。
为什么尾部稍翘不要紧?因为多层模型的小班效应估计是对处理变量 cltype 的固定效应做加权平均,主要受残差分布的中间段(信息密集区)影响,对极端尾部不敏感。正态性偏离一般要等到尾部比正态肥很多——比如出现明显双峰、长尾或截断——才会让固定效应推断显著失真。本数据的尾部偏离离这个程度还很远。
停下来想一想。 如果 QQ 图主体严重弯曲(不止尾部),意味着残差不是来自一个单一的正态分布,可能有未建模的子总体。处理方法是检查是否漏掉了某个分类协变量(族裔、年级、特殊教育标签),或考虑残差的异方差结构。本数据没有这种征兆。
班级层与学校层 BLUP 的诊断
学生层残差是诊断的"前菜"。班级层与学校层的 BLUP 同样要单独检查,因为它们各自假设来自一个零均值正态分布。lme4 不直接给 BLUP 的 QQ 图,但用 ranef 拿到 BLUP 之后画一张就够。
班级层 BLUP 一共有 323 个(每班一个),学校层 BLUP 一共有 79 个(每校一个)。学校层只有 79 个点,不太适合做严格的正态性检验,重点看是否有极端 outlier。班级层 323 个点足够看 QQ 图,重点看主体是否贴线。
实操时这两层检查很少出现重大偏离,因为 BLUP 本身经过收缩——极端值被向均值拉近,分布会比真实更接近正态。这是 BLUP 的"双刃剑":一方面它让 outlier 不那么离谱,另一方面它也掩盖了真实的非正态。Snijders 与 Berkhof 2008 提出的解决办法是用"标准化随机效应" 来做正态性检验,本数据两层 BLUP 的 SD 跟方差分量平方根接近(16.83 vs ,19.10 vs ),说明 BLUP 的描述统计与模型假设一致。
多层模型的总残差 是三层独立正态分布之和。混在一起做 Shapiro-Wilk 检验,看到的是这三个分布的卷积,主体仍然接近正态,但任一层的偏离都被其他两层"稀释"。
诊断方法:用 residuals(model) 拿学生层残差,用 ``ranef(model)sch` 拿学校层 BLUP,三者各画一张 QQ 图。如果某一层主体严重偏离正态,问题可能集中在那一层。
第二个常见疏漏:忽略 BLUP 的收缩效应。BLUP 不是真实随机效应,它是贝叶斯后验均值,会把极端值往均值拉。班级层 BLUP 在 QQ 图上呈现正态,不能保证真实班级效应也正态。所以 BLUP 的 QQ 图通过不代表"假设成立",更准确的说法是"假设没被这层证据推翻"。
leave-one-class-out 敏感性分析
在班级层做 leave-one-out 敏感性分析的步骤是:依次删除一个班级的所有学生,把模型在 名学生上重新拟合一遍,记录处理效应估计 与变化量 。如果所有 都很小( 远小于 ),主结论稳健;如果某个班的 极大,意味着该班在主结论里占据了不成比例的影响力,结论受单一班级驱动。
为什么在班级层做 leave-one-out 而不是在学生层?因为多层模型的处理变量 cltype 在班级层变化,单个学生删除几乎不影响小班效应估计;班级层删除才能反映"删掉一个完整的处理单元"对结论的影响。在学校层做删除也可以,但每删掉一所学校就丢掉 名学生,敏感性会过强;班级层是"信息密度合适"的删除粒度。
实操上,给所有 323 个班都跑一遍 leave-one-out 计算量较大;常用的折中是挑出几个潜在影响最大的班做敏感性分析。这些"嫌疑班"通常是 BLUP 绝对值最大(在班际中最离群)或样本量最大(在估计中权重最高)的那几个。
# 选样本量最大的 5 个班 + BLUP 绝对值最大的 5 个班作为候选
class_n <- d |> count(tch)
re      <- ranef(m)
class_blup <- re$`tch:sch`[, "(Intercept)"]

extreme_classes <- tibble(tch = rownames(re$`tch:sch`),
                          blup = class_blup) |>
  arrange(desc(abs(blup))) |>
  head(5) |>
  pull(tch)
big_classes <- class_n |> arrange(desc(n)) |> head(5) |> pull(tch)
candidate <- unique(c(extreme_classes, big_classes))

base_eff <- summary(m)$coefficients["cltypesmall", "Estimate"]   # 8.84

# 对每个候选班,删掉它的所有学生重新拟合
loo_results <- map_dfr(candidate, function(k) {
  d_loo <- d |> filter(tch != k)
  m_loo <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | sch/tch),
                data = d_loo, REML = TRUE)
  tibble(
    excluded_tch = k,
    n_dropped    = sum(d$tch == k),
    eff_small    = summary(m_loo)$coefficients["cltypesmall", "Estimate"],
    se_small     = summary(m_loo)$coefficients["cltypesmall", "Std. Error"],
    delta        = summary(m_loo)$coefficients["cltypesmall", "Estimate"] - base_eff
  )
})
10 个候选班全部跑完,删除任何一个班之后小班效应的估计在 8.57 到 8.89 之间漂移,对应 范围 到 。也就是说,最极端的删除也只让小班效应改变 0.27 分,相对原始估计 8.84 漂移不到 4%,远小于 SE = 2.63。主结论对单个班级的删除高度稳健:没有任何一个班单独在驱动"小班 +8.84 分"这个结论,它是 323 个班共同支撑出来的稳定估计。
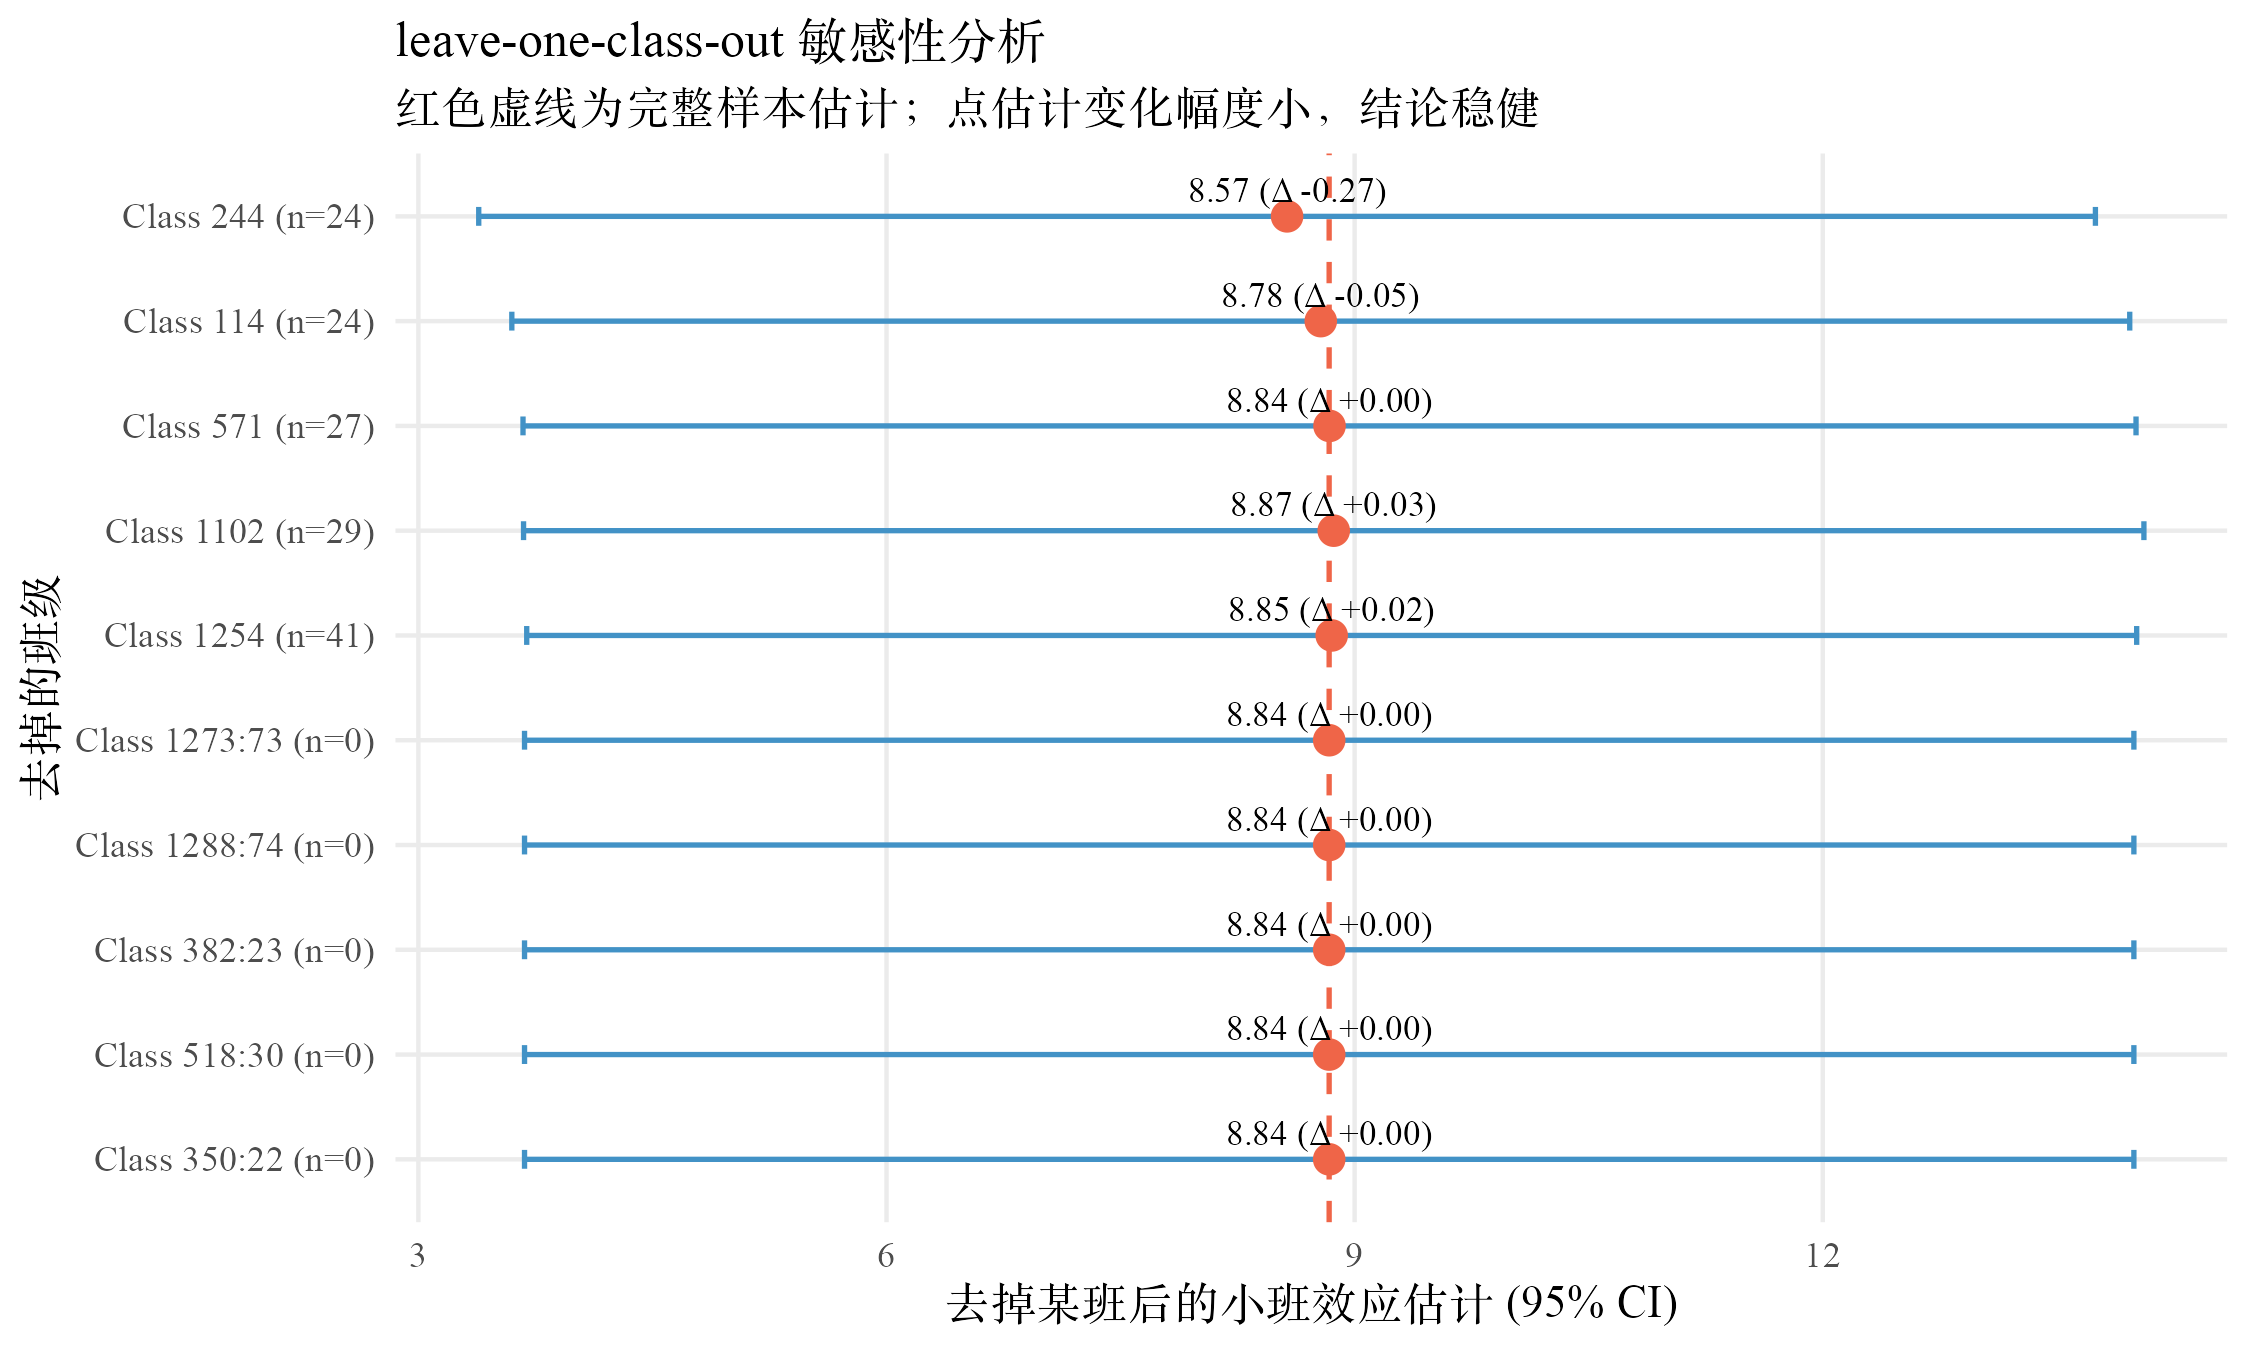
读 leave-one-class-out 森林图的方法是看红点离虚线远不远。所有 10 个红点都贴在虚线附近,CI 宽度也跟原始估计接近。如果某个红点显著偏离虚线,意味着那个班对主结论有"杠杆性"影响,需要进一步调查它的特殊性(是否数据录入错误、是否极端 outlier 班)。本数据没有这种现象。
影响力诊断与班级权重
LOO 是"删掉看变化"的事后检验,互补的视角是事前估计每个班的潜在影响力。直观的启发式是:一个班的影响力大致正比于班级规模 BLUP 绝对值。班级越大、BLUP 越极端,这个班对 与 估计的拉动越强。
# 每个班的样本量
class_summary <- d |> count(tch) |> mutate(tch = as.character(tch))
parse_tch <- function(s) sub("^[^:]+:", "", s)   # "1:23" -> "23"

infl_df <- tibble(label = rownames(re$`tch:sch`),
                  tch = parse_tch(rownames(re$`tch:sch`)),
                  blup = class_blup) |>
  left_join(class_summary, by = "tch") |>
  mutate(influence = n * abs(blup)) |>
  arrange(desc(influence))

# 影响最大的 10 个班
head(infl_df, 10)
输出会按 influence 降序排列,给出最可能影响主估计的班级名单。结合 LOO 结果可以做最终判断:影响力最大的几个班,逐一删除之后估计变化也很小(),说明即使是"最有分量"的班也不足以单独绑架结论。
停下来想一想。 如果某个班的 influence 排第一、删掉之后小班效应从 8.84 变成 5.20(),结论就被这一个班绑架了。处理办法不一定是排除该班,更应该是回去看这个班的数据是不是有录入错误、是不是有学生层未建模的极端协变量。本数据没有触发这种警报。
累积对比表更新
把本章给出的诊断后基线估计加进累积对比表。第 9 章不引入新模型,只在主模型上做了诊断,因此对比表里只增加一行"主模型(LOO 基线)",标注"敏感性分析"。
表 9·1 第 5 至第 9 章的小班效应累积对比
| 方法 | small | SE | ||||
|---|---|---|---|---|---|---|
| OLS 朴素 | 8.21 | 1.56 | 0.001 | — | — | 2,264 |
| OLS + 学生协变量 | 8.13 | 1.50 | 0.001 | — | — | 2,104 |
二层 (1|tch) | 7.90 | 3.76 | 0.036 | — | 685 | 1,597 |
| 二层 + 学生协变量 | 7.68 | 3.63 | 0.035 | — | 638 | 1,492 |
三层 (1|sch/tch) | 8.91 | 2.67 | 0.001 | 366 | 288 | 1,598 |
| 三层 + 学生协变量 | 8.84 | 2.63 | 0.001 | 365 | 283 | 1,492 |
| 三层 + 学生协变量(LOO 基线) | 8.84 | 2.63 | 0.001 | 365 | 283 | 1,492 |
LOO 基线那一行的数字跟主估计一致,意义在于它代表"在所有候选 leave-one-out 子样本里,估计漂移幅度都不超过 0.3 分"这一稳健性结论。这是诊断的最终交付物:一个有信任状的处理效应估计。
从诊断到方法对比的过渡
第 8 章给出主估计,本章把主估计的内部诊断与外部敏感性都过了一遍。现在可以放心地把这个 +8.84 分(SE 2.63)当成本书最终的"小班效应"估计。但读者还需要看到的是:跟前面所有章节里出现的 OLS、二层、三层各种变体相比,这个最终估计是不是合理、它跟其他方法的差距来自哪里、什么时候用二层够、什么时候必须三层。
第 10 章会做这件事。把全书出现的七种估计——朴素 OLS、OLS + 学生协变量、二层、二层 + 学生协变量、三层、三层 + 学生协变量、三层 + 跨层交互——的小班效应、SE、95% CI、方差分量并列在同一张表里,画一张终极的森林图。再用 AIC / BIC / LRT 对模型进行正式比较,给出"这份数据上哪种模型最合适"的回答。最后用一段实践指南讲清楚什么时候选什么模型,让读者把本书里学到的方法带到自己的数据上。