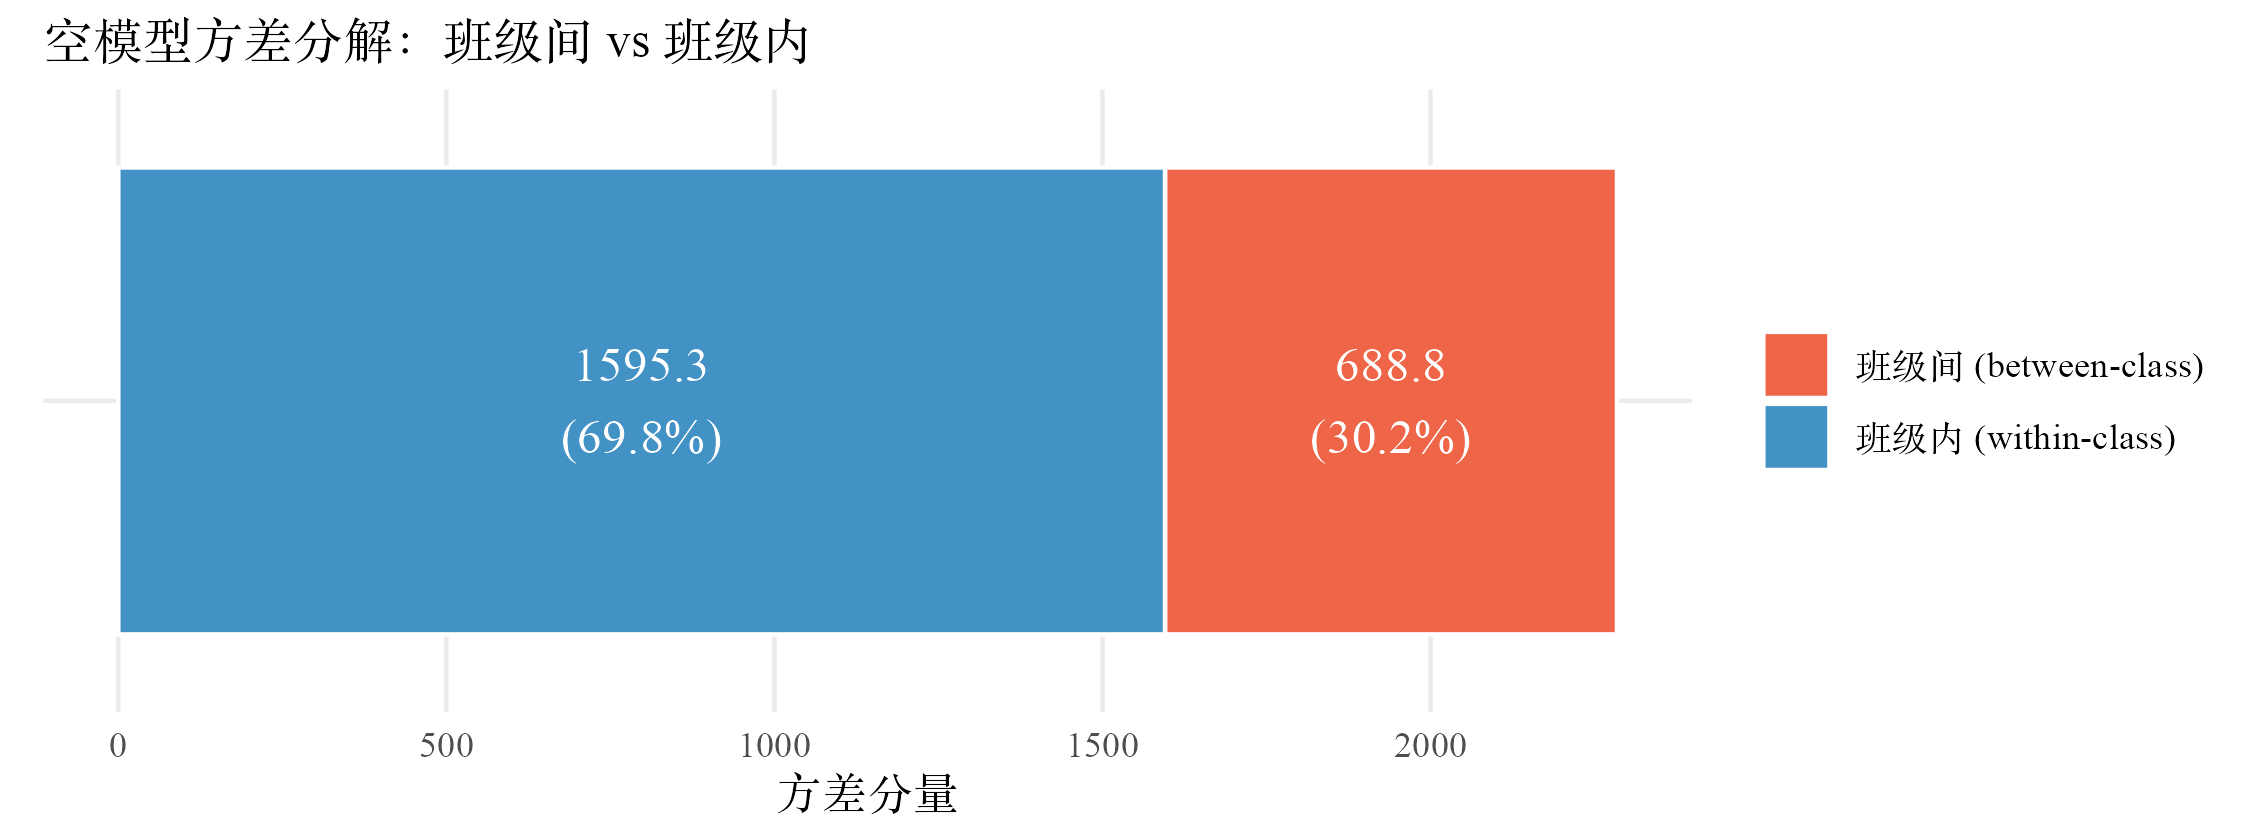
第 2 章把空模型当成"算 ICC 的工具"用过一次。从 VarCorr 抓出 和 ,代进 算出 ICC = 30.2%,本章的故事开始时这件事已经做完了。问题是空模型本身远不止给出两个方差数字这么简单。它的 summary 输出里还有固定截距 (SE = 2.49)这一行,有 337 个班级各自对应的随机截距估计 ,有 REML 跟 ML 两套不同的拟合结果,还有跟纯朴素 OLS 的似然比检验。这些都是第 4 章及以后会反复用到的基础量。
本章把空模型从头到尾拆一遍。先把模型方程写下来,再用一段话把每个符号锚到具体的"人"或"班"上;接着讲随机截距的 BLUP 估计,重点说为什么估出来的班均值会被"拉"向全样本均值这个看似奇怪的现象;然后对比 REML 与 ML 两种估计方法在多层模型里的分工;最后用似然比检验确认"加随机截距"相对纯 OLS 是不是值得。第 4 章会在此基础上加入学生层协变量,第 5 章再加处理变量。
空模型的方程与每个符号背后的人
对学生 嵌套在班级 里的两层数据,最简单的空模型写作
其中 是班级 里第 名学生的数学分数, 是全样本"总均值"对应的固定截距, 是班级 相对总均值的偏差,服从均值为 0、方差为 的正态分布; 是该学生相对班级均值的个体波动,服从均值为 0、方差为 的正态分布; 与 互相独立。"空模型"指右边没有任何解释变量,只用截距加随机效应来描述结果。
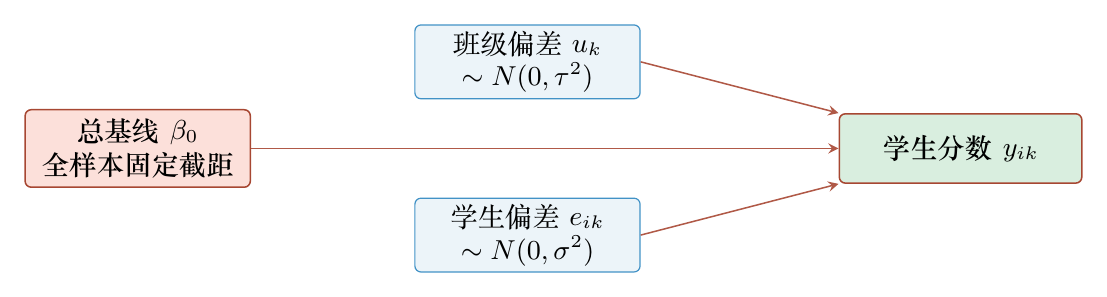
把这条公式翻成话:每名学生的分数等于一个总基线 ,加上他所在班级的"班级偏差" ,再加上他个人在班里的"个体波动" 。 就是全样本数学均值的估计; 是某个班相对这条基线高几分还是低几分; 是某名学生相对班级均值的余下偏离。三个量的加和给出每名学生的分数预测。
library(tidyverse)
library(lme4)
library(lmerTest)
library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch), !is.na(sch))

m0 <- lmer(math ~ 1 + (1 | tch), data = d, REML = TRUE)
summary(m0)
# Linear mixed model fit by REML. t-tests use Satterthwaite's method
# Formula: math ~ 1 + (1 | tch)
#
# Random effects:
#  Groups   Name        Variance Std.Dev.
#  tch      (Intercept)  689     26.25
#  Residual             1595     39.94
# Number of obs: 5786, groups:  tch, 337
#
# Fixed effects:
#             Estimate Std. Error      df t value Pr(>|t|)
# (Intercept)  486.30      2.49   333.6  195.3    <2e-16

VarCorr(m0)                          # 随机效应方差分量
ranef_class <- ranef(m0)$tch         # 337 个班的 BLUP
这份输出包含三块关键信息。第一块是 Random effects:班级间方差 ,对应班级间标准差 ;班级内方差 ,对应学生层标准差 。班级层 26 分相当于"两个班的均值平均差 26 分"这种数量级;学生层 40 分相当于"班里同学之间的分数高低差 40 分"这种数量级。
第二块是 Fixed effects:固定截距 ,标准误 2.49,意思是"考虑了班级嵌套之后,对全样本数学均值的估计是 486.3,误差棒是 2.5 分"。这跟简单平均得到的 487 分非常接近,但 SE 比朴素 OLS 的 0.65 大了将近 4 倍——这是嵌套结构对均值估计本身的把握度的扣分。
第三块是底下的 Number of obs: 5786, groups: tch, 337,这一行是 lmer 在帮你确认数据结构没读错:5,786 名学生分散在 337 个班级里。
BLUP 与收缩:班均值被全样本均值"拉"回
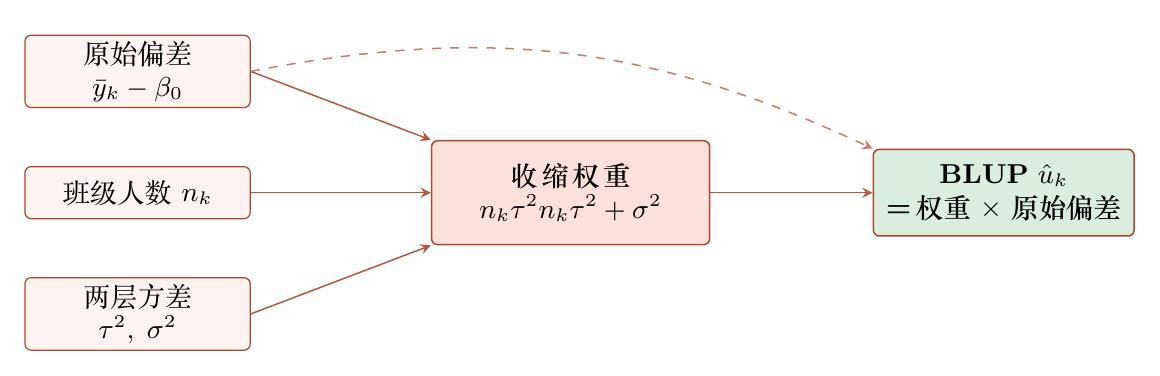
对随机截距模型 ,每个班级 的随机截距 用一个带收缩权重的公式来估,而非直接采用"班级均值减全样本均值":
其中 是班级 的人数, 是该班的原始均值, 是全样本固定截距, 与 是两层方差。这个估计被称为最优线性无偏预测量(best linear unbiased predictor,BLUP),由 Henderson 1950 年代在动物育种里推导出来。
光看公式有点抽象,把它代成具体数字就很直观。STAR 里某个班 12 名学生原始均值 545 分,全样本均值 486.3 分,原始偏差是 分。代入 BLUP 公式,权重是
其中 12 是班级人数,689 是班级间方差,1,595 是班级内方差。BLUP 估计是 ,比原始偏差 58.7 缩了将近十分。这个缩水现象就是收缩(shrinkage)。
为什么要这样估?想象你是当年的 STAR 数据分析师,在 79 所学校的 337 个班里抽 12 个孩子算班均值。如果这 12 个孩子里恰好坐了几个考试当天发挥极好的学霸,原始均值会被拉得离谱地高。BLUP 的设计思路是:"样本量小的班、班均值特别极端的班,更可能是抽样偶然导致的,向全样本均值靠回去更靠谱;样本量大、信息充足的班,自己的均值就足够可信,不用调多少。" 权重 恰好实现这个直觉—— 大权重接近 1,几乎不动; 小权重远离 1,往全样本均值靠。
用班里讨论的场景再说一遍。 全班开班会评优秀学生,老师听到家长打电话单方面夸自家孩子时不会照单全收,会跟班里其他同学的反馈对比着听。家长给的 90 分(原始均值)跟班里同学反馈的中位数 70 分加权后变成 75 分(BLUP)。家长的话不是没价值,但要被"集体平均"的力量稍微拉回来。班里反馈越多( 越大),家长的话就越占主导;反馈越少,越要靠班级整体判断。
回到 STAR 的全样本数字:337 个班的原始均值标准差是 28.59,BLUP 标准差是 24.29,整体收缩了 。BLUP 的范围从 到 ,开根号一下,,跟 BLUP SD = 24.29 接近——理论上 BLUP SD 应该略小于 ,因为收缩让方差被吃掉一点。
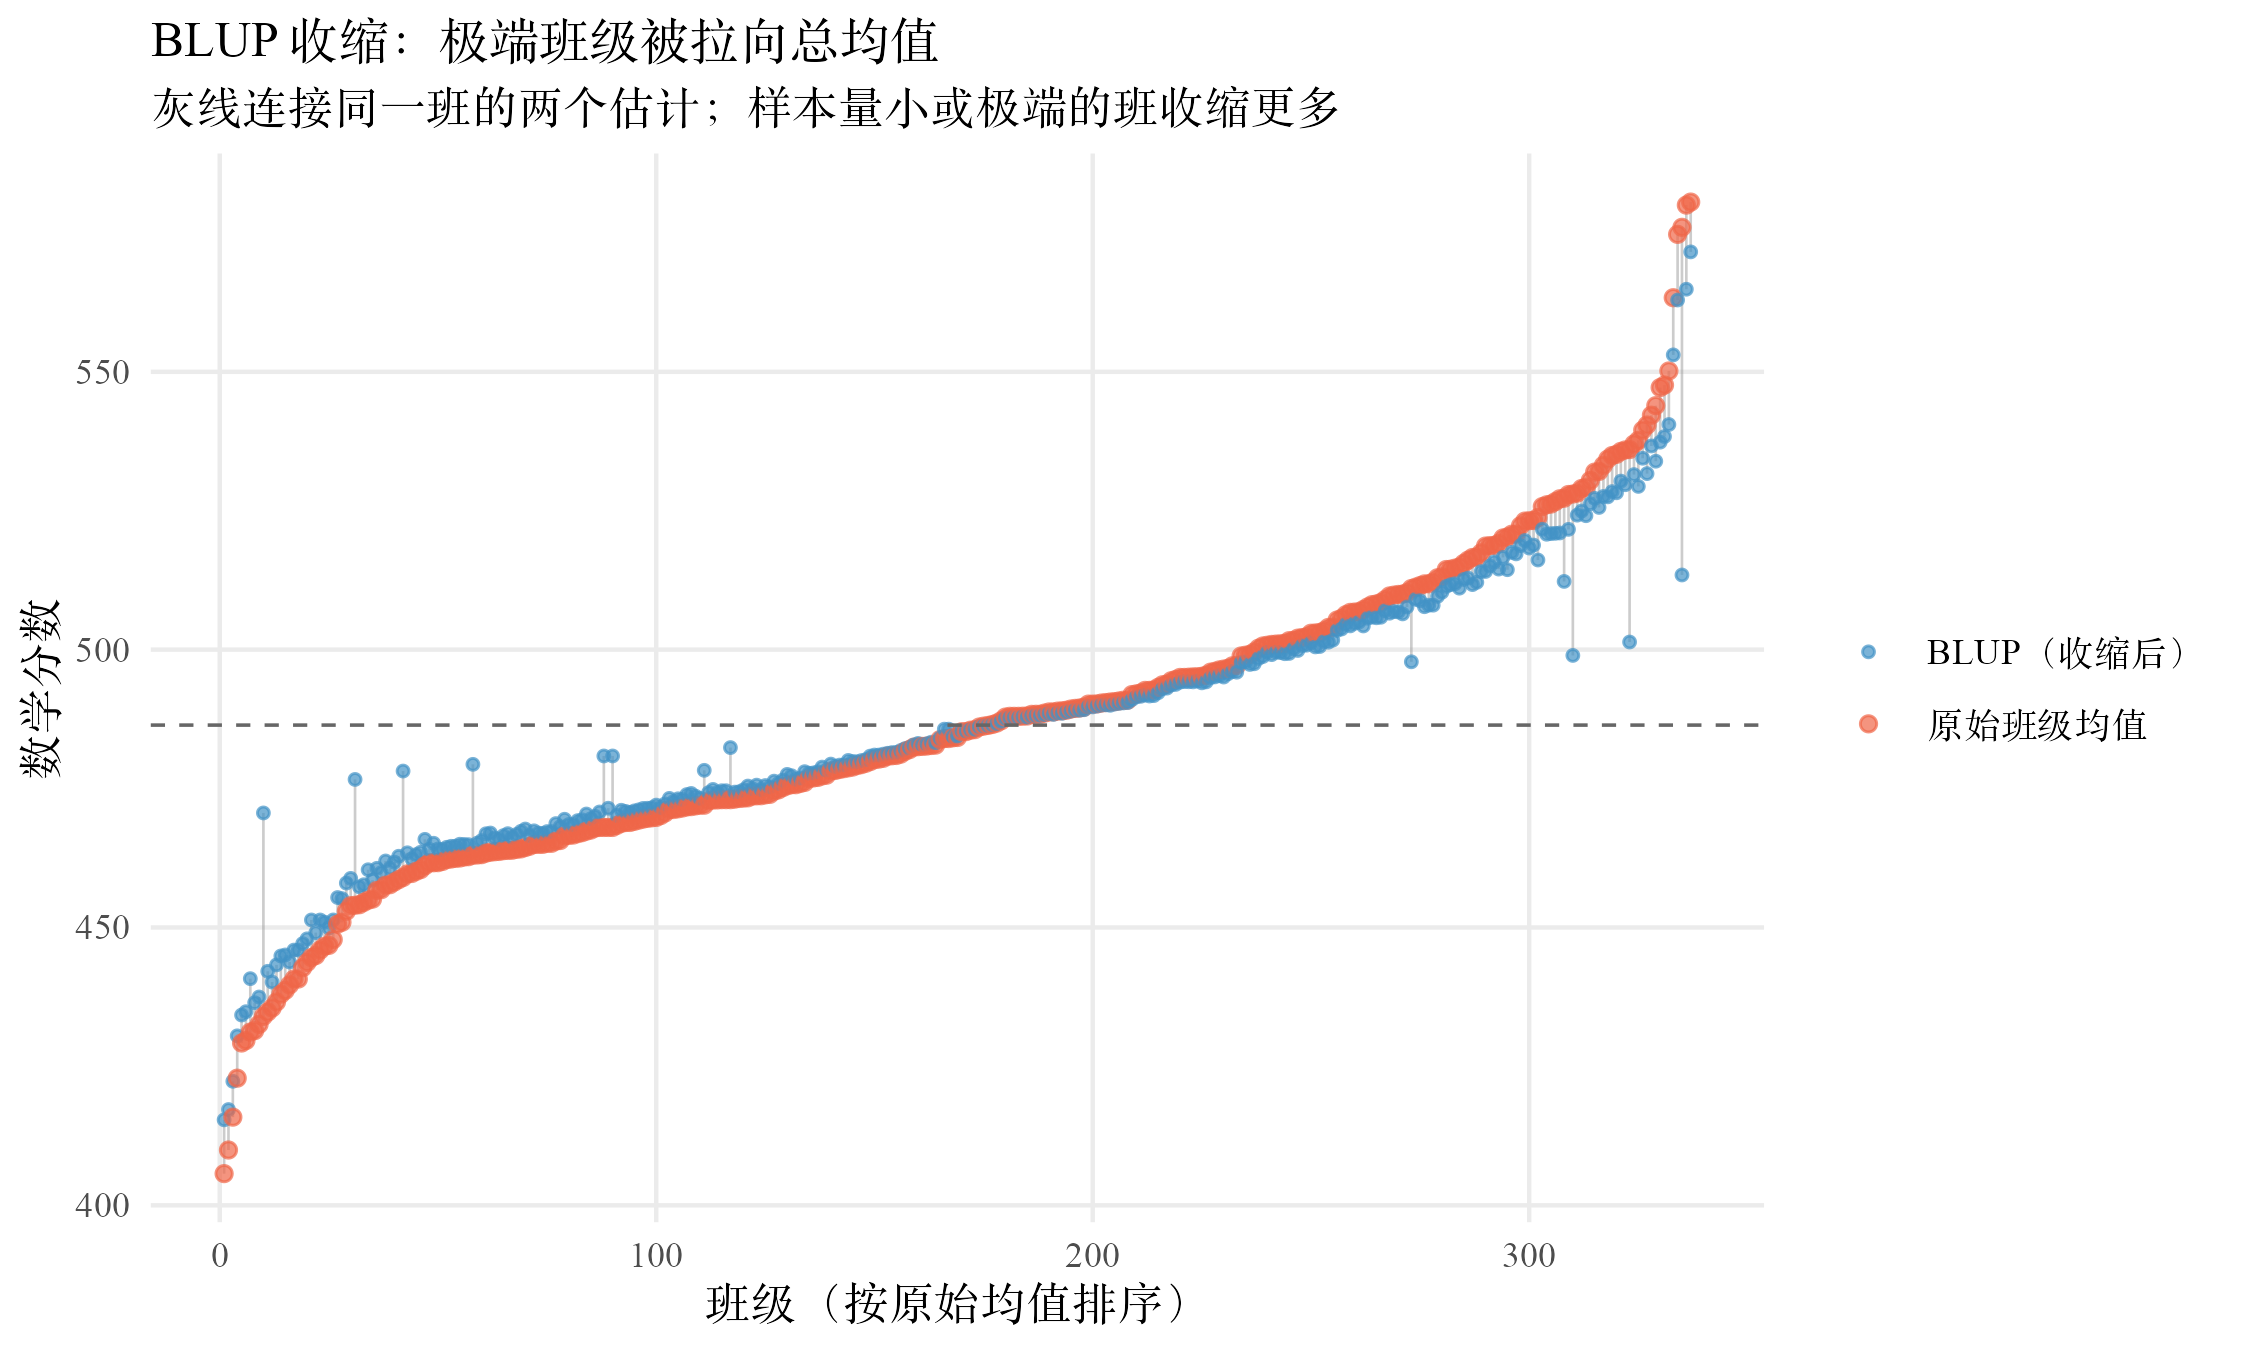
把 337 个班按原始均值排好,每个班画一对点(原始均值与 BLUP),两端最极端的几个班向中间收缩得最显眼,中间一带的班几乎没动。这跟 BLUP 公式给出的逻辑完全对应——极端值更可能是抽样偶然,应该被拉回去。
BLUP 这个概念是 1950 年 Henderson 在康奈尔大学农学院提出来的,原本是给牛奶产量遗传值的预测用的。育种学家面对的问题跟教育研究面对的问题数学形式相同:从有限观测里估计每头母牛、每个班级的"真实潜力",要兼顾"自身观测"和"群体先验"。Robinson 1991 年在 Statistical Science 上写过一篇 BLUP 历史综述,是这条线索的标准参考。
REML vs ML:两种估计方法在多层模型里的分工
lmer 默认用 REML(restricted maximum likelihood,限制性极大似然)拟合。为什么不用更"标准"的 ML(极大似然)?这背后有个微妙但重要的偏差问题。
ML 估计方差分量时把所有观测代进似然函数一起最大化,结果是固定效应跟方差分量"互相影响"。具体后果是 跟 会被系统性低估,幅度跟参数个数有关。Patterson 与 Thompson 1971 年在 Biometrika 上提出 REML,思路是"先用一个变换把固定效应那一块从似然里去掉,再对剩下的部分做极大似然"。这样估出来的方差分量是无偏(或近似无偏)的。
代价是 REML 的似然值不能用来比较不同固定效应结构的模型,因为变换本身依赖固定效应设定。如果想用似然比检验比较两个模型的固定效应(比如"加 cltype 比不加 cltype 好不好"),必须切到 ML。
具体到 STAR 的空模型,REML 和 ML 给出的方差分量差别非常小:
表 3·1 空模型 REML 与 ML 估计对比
| 参数 | REML | ML |
|---|---|---|
| (班级间方差) | 689 | 686 |
| (班级内方差) | 1,595 | 1,595 |
| (固定截距) | 486.30 | 486.30 |
样本量 5,786、班级数 337 的情况下,两种方法差别小到可以忽略。但样本量小的时候差别会放大。Bates 等人写 lme4 时把 REML 设为默认,正是为了让用户在大多数场景下拿到的是无偏估计;只在做模型比较时显式切到 REML = FALSE。
有些教材、有些早期 SAS 代码默认用 ML 估方差分量,给出的 系统性偏低。当用 ML 算 ICC,分子 偏低、分母也偏低,比值不一定怎么变;但当 用来做后续计算(比如设计效应、BLUP 收缩权重),就会传递误差。
诊断方法:检查 lmer 调用是否显式设置了 REML = TRUE 或者用了默认值。如果代码里写了 REML = FALSE,看是不是只在做似然比检验之前临时切的。
记忆方法:估方差用 REML,比固定效应用 ML,最后报告时再切回 REML。lmerTest 的 anova 在两个 lmer 模型之间做 LRT 时会自动 refit 成 ML,不用自己切。
似然比检验:空模型相对朴素 OLS 是否值得
读完空模型的所有数字之后,要回答的最后一个问题是:"加上 (1|tch) 这个随机截距,相比纯 的 OLS,到底好多少?" 答案要靠似然比检验给。
似然比检验比较两个嵌套模型的对数似然,统计量
其中 是各模型的对数似然,简单模型嵌套在复杂模型里。在原假设"复杂模型不比简单模型好"下,LR 服从自由度等于参数差的卡方分布。
把朴素 OLS(仅截距)跟空模型放进 anova 比较。两者参数差是 1(多了一个 ),但 在原假设下卡在边界 0 上,标准卡方分布不再适用,要用 这种"边界混合"分布——Self 与 Liang 1987 年专门处理过这个边界问题。lme4 跟 RLRsim 都内置了正确的检验程序,常规用法直接用 anova 比较 lmer 跟 lm,得到 LR = 1,355.15、。
LR = 1,355 在 5,786 个学生 + 337 个班这个样本规模下属于合理量级。ICC = 30.2% 这种强嵌套结构下,纯 OLS 模型抓不住任何班级层信息,似然被显著拉低。LR = 1,355 的具体数值不是重点,重点是它显著超过任何合理的卡方临界值——多层结构必须建模。这条结论第 2 章已经从"标准误膨胀 2.38 倍"给出了一次,本节用似然比再验证一次,两条独立证据指向同一个判断。
从空模型到学生层协变量
本章把空模型从头到尾解了一遍。读者现在应该能复述这套逻辑:空模型方程 把每名学生分数拆成总基线、班级偏差、个体波动;lmer 给出的输出包含 、、 三块;337 个班的 用 BLUP 估计,估出来比原始班均值整体收缩 15%,因为极端班更可能是抽样偶然;REML 给方差分量、ML 给固定效应似然比检验,lme4 默认 REML 不用自己切;空模型相对纯 OLS 的 LR 高达 1,355,强嵌套结构必须建模。
但本章只用了"空模型"这一个最简单的设定。STAR 数据里还有大量被忽略的信息:学生的性别、族裔、是否享受免费午餐、教师的工龄与学位、学校类型。这些变量要么是学生层的(每个学生不一样),要么是班级或学校层的(同班同校的学生共享)。把它们加进模型,方差分量会怎么变?小班效应 分会怎么漂移?
下一章先处理学生层协变量。会加性别、族裔、SES 三个变量,看 能被压下去多少(学生层变量解释的是学生层方差),看 会不会被影响(教育研究里这块通常变化很小)。还会引入一个对教育数据特别重要的方法——组均值中心化(centering within cluster),讲清同一个变量 SES 在"个体层"和"班级层"两个层面的效应可以完全不同,不分开看会把两者混合成单一系数。第 5 章再加处理变量 cltype,把"小班 vs 常班"正式作为多层模型的协变量推上来。