第 1 章末尾留过一道伏笔:朴素 OLS 给出"小班 +8 分、"的结论看起来干净利落,但它把 5,786 名学生当成了 5,786 个独立观测。从那以后本书做的所有事,都是在把这个伏笔拆开。第 2 章引入组内相关 ICC,看清同班学生为什么不独立;第 3 章讲清空模型的方差分解;第 4 到第 6 章在 Level-1 与 Level-2 加入协变量与随机斜率;第 7 章用跨层交互检验"小班对低 SES 学生是否有特殊作用";第 8 章把学校层独立出来,跑完整三层模型;第 9 章诊断主模型并做 leave-one-out 敏感性分析。
每一章都给出过一个对应的"小班效应"估计。把这些估计排成一列,能看到一张完整的方法漂移图谱。本章的任务就是把这张图谱铺开,回答几个相互关联的问题——七种方法的小班效应到底差多少,差距来自哪里,哪种模型在这份数据上最合适,最终的结论是什么,读者拿到一份新数据时应该怎么挑模型。
七种方法的终极对比
把本书所有出现过的小班效应估计放在同一张表里。包括两种 OLS(朴素与 + 学生协变量)、两种二层模型(仅 cltype 与 + 学生协变量)、两种三层模型(仅 cltype 与 + 学生协变量)、最后再加一种三层 + 跨层交互,共七种。
表 10·1 全书七种方法的小班效应估计与方差分量
| 方法 | small | SE | 95% CI | |||
|---|---|---|---|---|---|---|
| OLS 朴素 | 8.21 | 1.56 | [5.15, 11.27] | — | — | 2,264 |
| OLS + 学生协变量 | 8.13 | 1.50 | [5.18, 11.07] | — | — | 2,104 |
二层 (1|tch) | 7.90 | 3.75 | [0.55, 15.26] | — | 683 | 1,597 |
| 二层 + 学生协变量 | 7.68 | 3.63 | [0.57, 14.79] | — | 638 | 1,492 |
三层 (1|sch/tch) | 8.91 | 2.67 | [3.67, 14.14] | 366 | 288 | 1,598 |
| 三层 + 学生协变量 | 8.84 | 2.63 | [3.68, 14.00] | 365 | 283 | 1,492 |
| 三层 + 跨层交互 | 9.10 | 2.98 | [3.26, 14.94] | 365 | 284 | 1,492 |
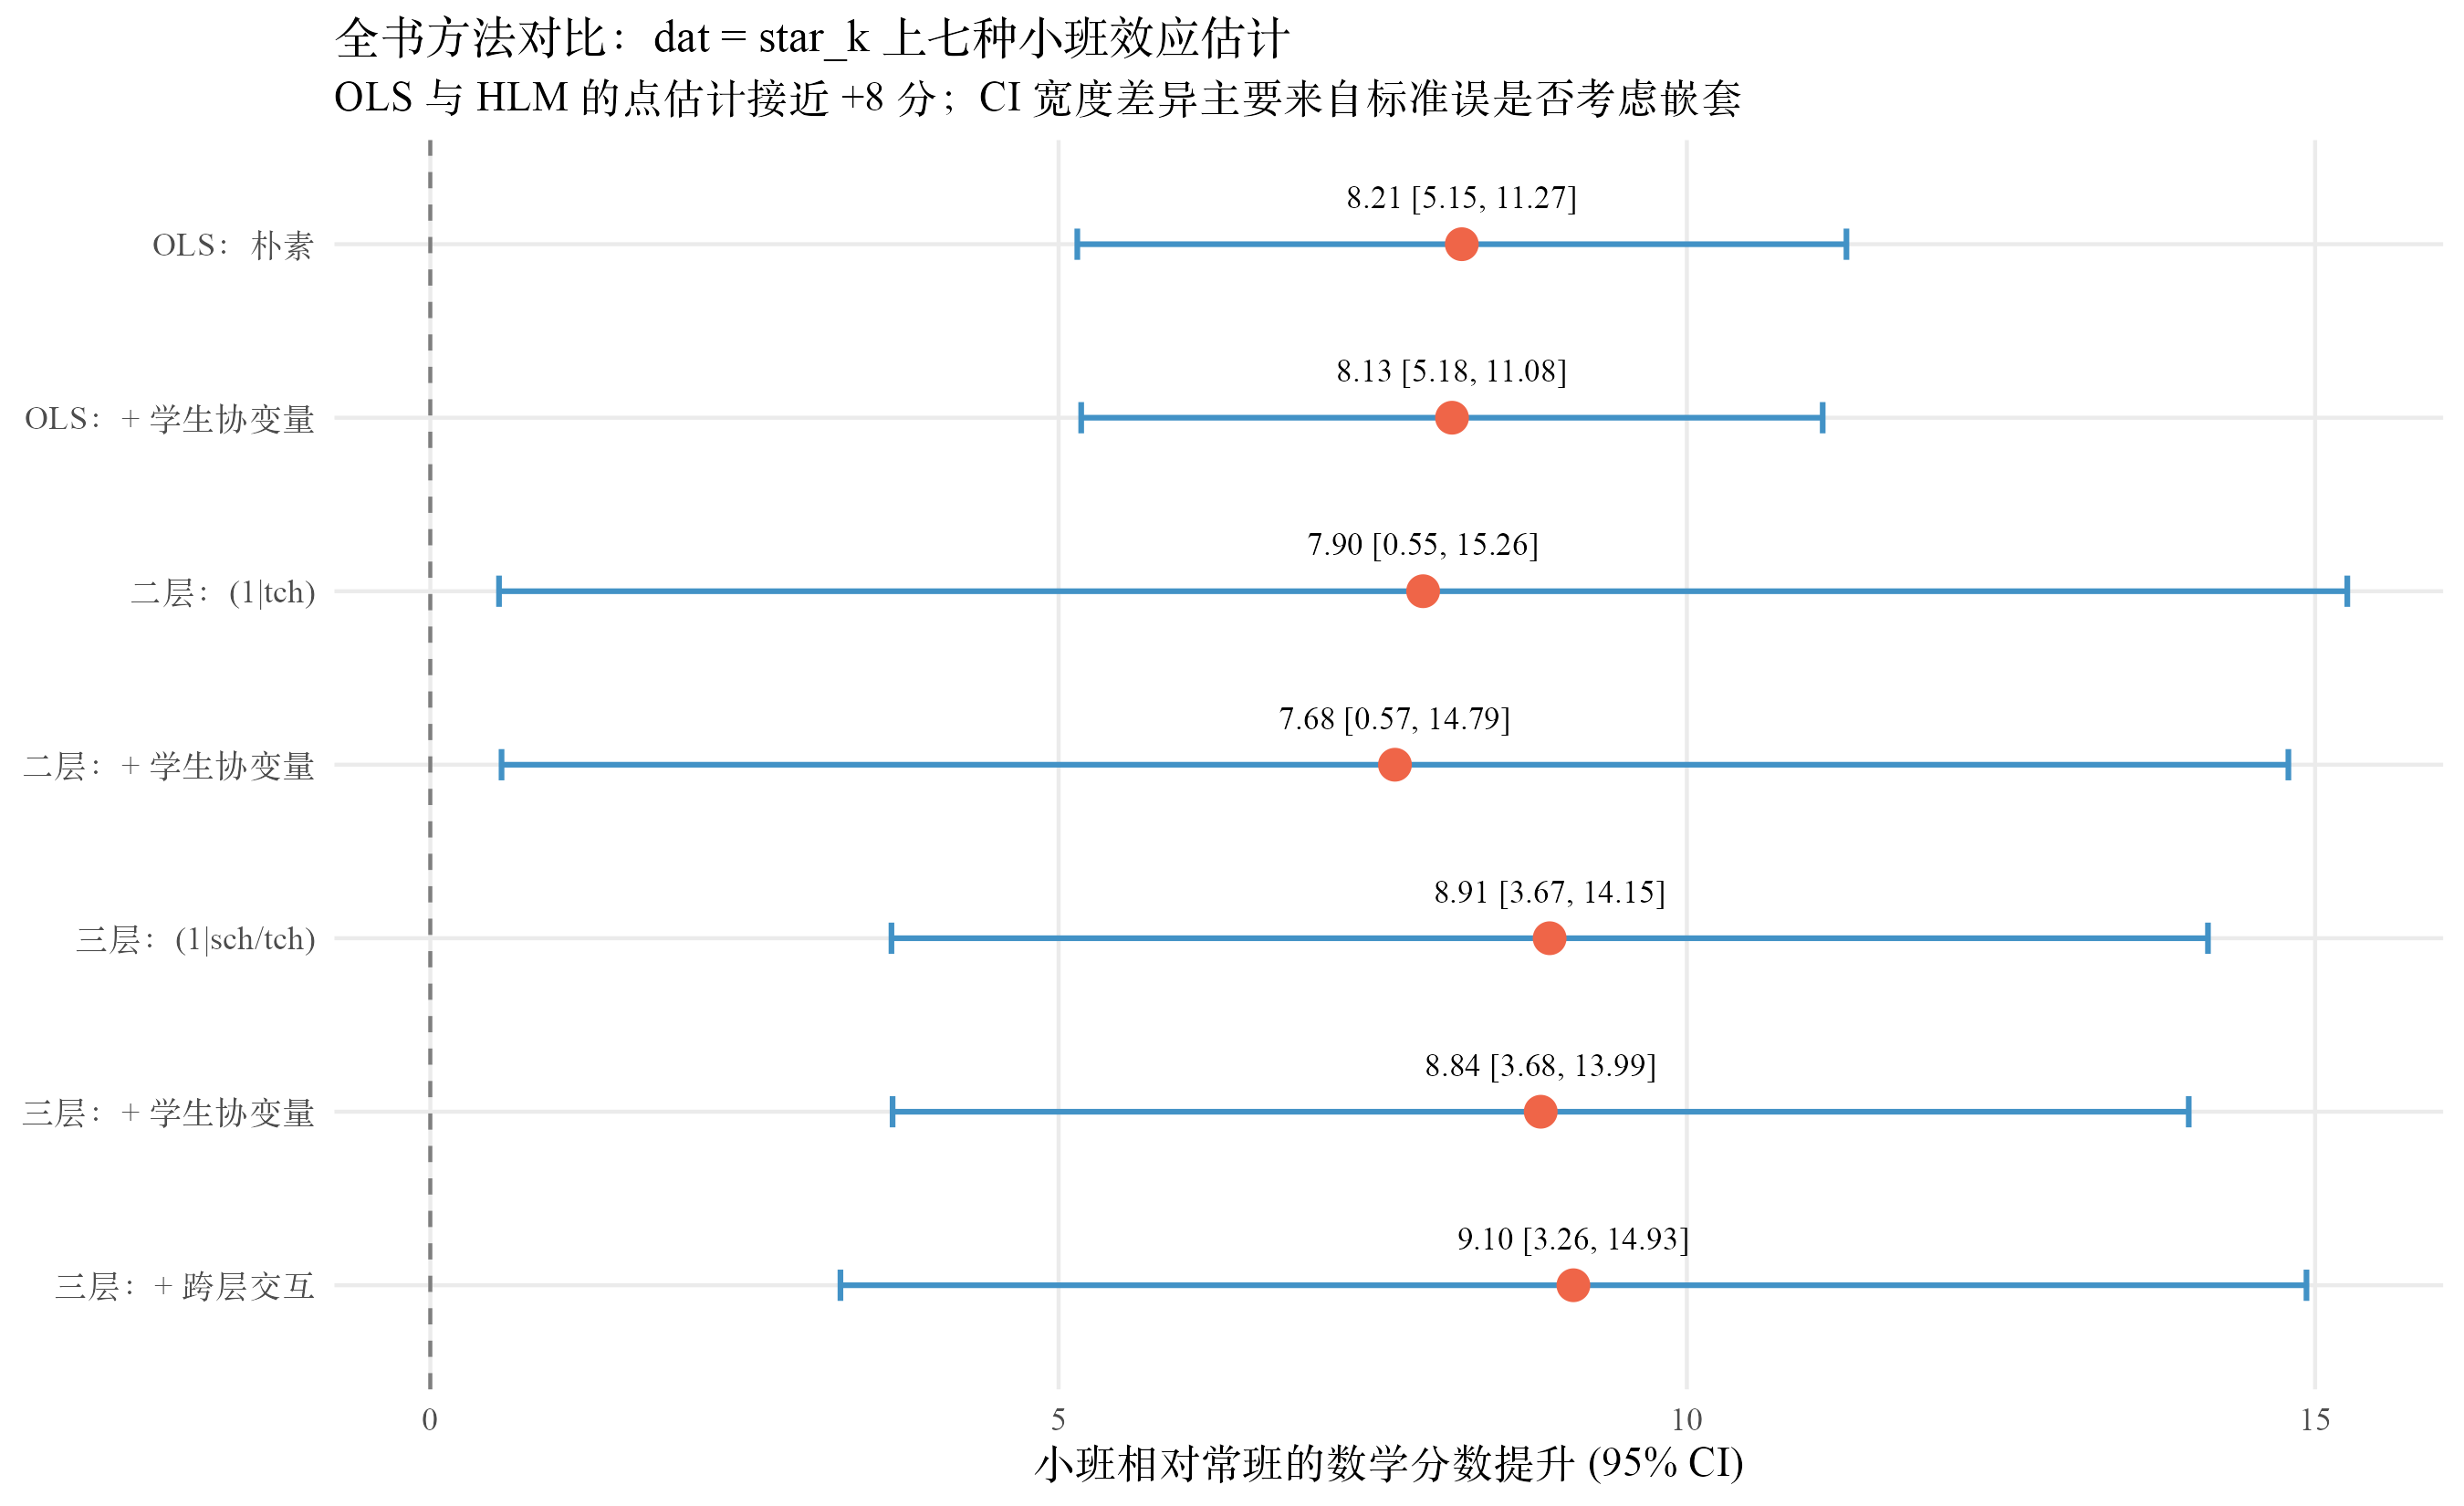
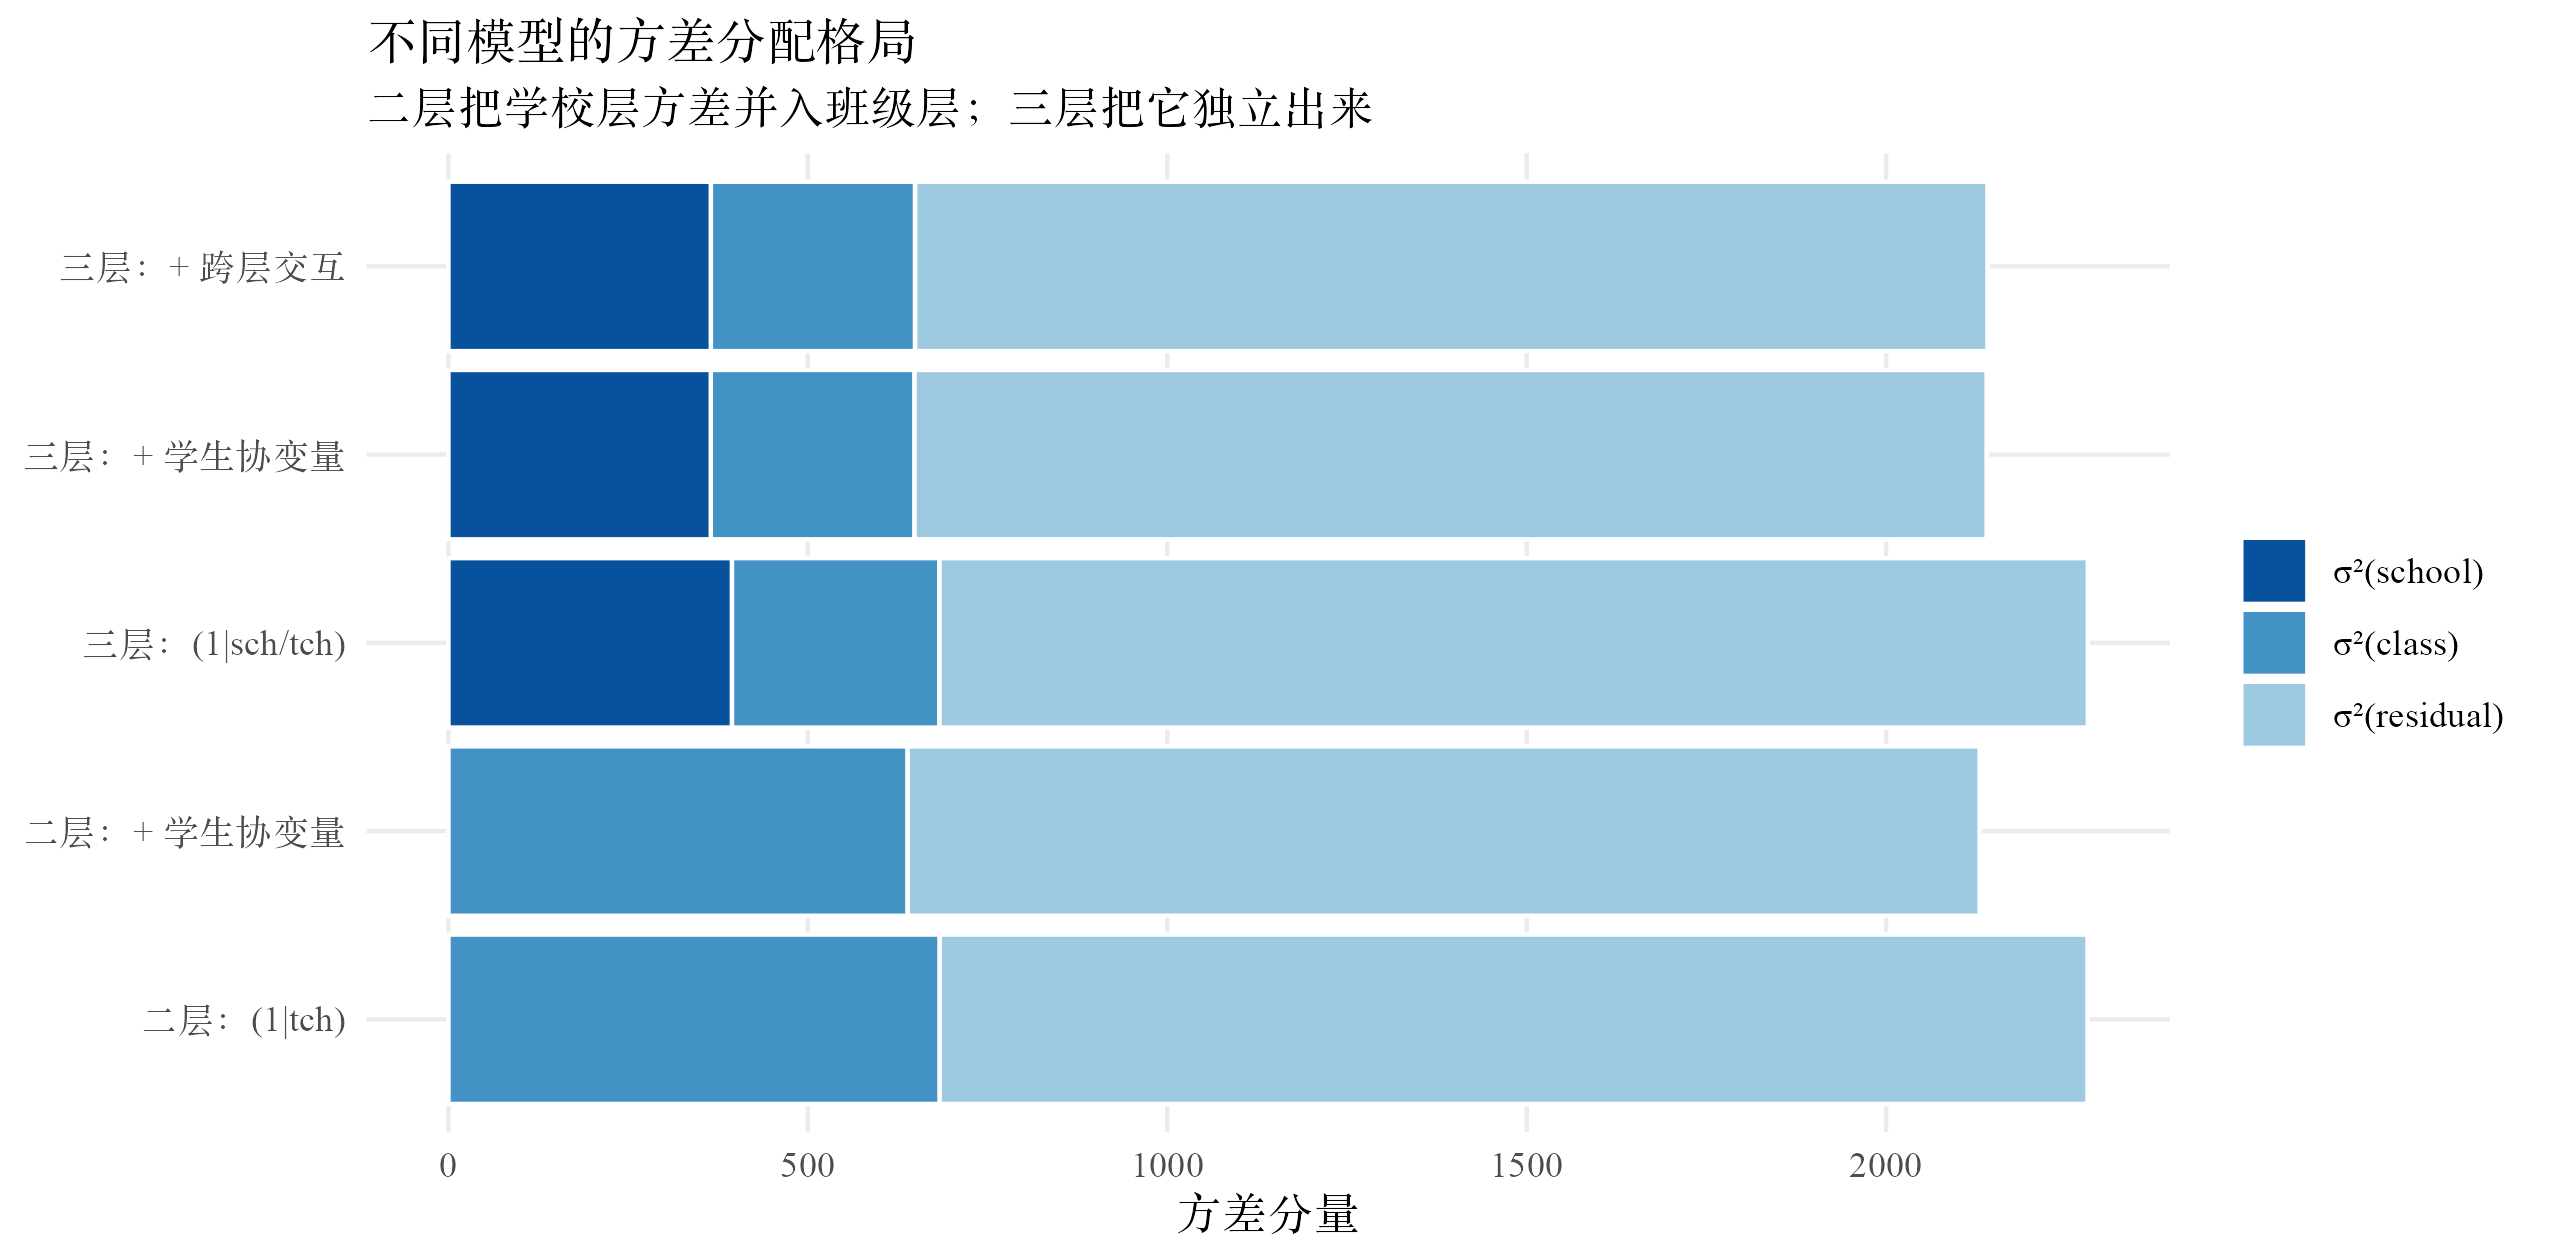
读这张表的方法是分两步看。先看点估计(small 列),七种方法给出的小班效应在 7.68 到 9.10 之间漂移,跨度 1.4 分。这个漂移不是统计噪声,而是不同模型对"如何分摊学校层方差"做出的不同决定造成的。OLS 不区分嵌套,把所有学生当独立观测;二层模型承认班级层但忽略学校层,把学校层差异塞进班级层;三层模型把学校层独立出来,让处理变量的方差归位。
再看标准误(SE 列)。OLS 的两种版本 SE 都在 1.5 左右,远小于多层模型的 2.6 到 3.8。这个差距直接决定了 95% CI 的宽度:OLS 的 CI 大约 ,二层 CI ,三层 CI 。OLS 的 CI 最窄,但这种"精确"建立在独立观测假设之上,而该假设在嵌套数据里不成立。多层模型给的 CI 更宽,是诚实承认"5,768 个学生不是 5,768 个独立信息单位"的代价。
为什么二层 CI 反而比三层更宽( vs )?因为二层模型把学校层方差塞给班级层,让处理变量的标准误"扛"了更多它本不该扛的方差。三层模型把学校层方差独立出来后,班级层方差从 638 降到 283,处理变量的标准误下降。这是结构正确性带来的精度收益:模型层级越贴合数据真实嵌套,估计越精确。
模型选择:AIC / BIC / LRT
AIC(Akaike Information Criterion)= ,BIC(Bayesian Information Criterion)= ,其中 是模型对数似然、 是参数个数、 是样本量。两者都是"惩罚复杂度"的拟合优度,越小越好。AIC 倾向选择有更好预测能力的模型,BIC 因为惩罚项里有 ,在大样本下更倾向选择简单模型。
LRT(似然比检验)适用于嵌套模型对比,统计量 在零假设(简化模型成立)下渐近服从 分布, 等于两模型参数差。LRT 给出 值,AIC / BIC 给出排序,三者可以联合判断"加复杂度值不值"。
把第 8 章给出的二层 + 学生协变量与三层 + 学生协变量两个主要候选放在 ML 拟合下做正式对比。
library(tidyverse)
library(lme4)
library(lmerTest)
library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch), !is.na(sch),
         !is.na(sx), !is.na(eth), !is.na(ses)) |>
  mutate(
    sex_F  = ifelse(sx == "F", 1, 0),
    eth_B  = ifelse(eth == "B", 1, 0),
    ses_F  = ifelse(ses == "F", 1, 0),
    cltype = factor(cltype, levels = c("reg", "reg+A", "small"))
  )

# 七种方法
m_ols       <- lm(math ~ cltype, data = d)
m_ols_full  <- lm(math ~ cltype + sex_F + eth_B + ses_F, data = d)
m_2l        <- lmer(math ~ cltype + (1 | tch), data = d, REML = TRUE)
m_2l_full   <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | tch),
                    data = d, REML = TRUE)
m_3l        <- lmer(math ~ cltype + (1 | sch/tch), data = d, REML = TRUE)
m_3l_full   <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | sch/tch),
                    data = d, REML = TRUE)
m_3l_ix     <- lmer(math ~ cltype * ses_F + sex_F + eth_B + (1 | sch/tch),
                    data = d, REML = TRUE)

# AIC / BIC(ML 拟合)
m_2l_full_ml <- update(m_2l_full, REML = FALSE)
m_3l_full_ml <- update(m_3l_full, REML = FALSE)
tibble(
  method = c("二层:+ 学生协变量", "三层:+ 学生协变量"),
  AIC    = c(AIC(m_2l_full_ml), AIC(m_3l_full_ml)),
  BIC    = c(BIC(m_2l_full_ml), BIC(m_3l_full_ml))
)
#  method                   AIC      BIC
#  二层:+ 学生协变量    59218.4  59271.7
#  三层:+ 学生协变量    59129.7  59189.6
AIC 从二层的 59,218 降到三层的 59,130,下降 。BIC 从 59,272 降到 59,190,下降 。两种准则同向,差距都远超经验门槛 10。结合第 8 章的 LRT ,三种证据一致指向同一结论:在 STAR 数据上,三层模型显著优于二层模型。学校层方差 365 不是噪声,是必须独立成一层的真实结构。
为什么 AIC 与 BIC 在这份数据上判断一致?因为本数据样本量大(5,768),即便 BIC 对复杂度的惩罚比 AIC 重,89 这种量级的对数似然差距也压倒了 这一笔多估参数的额外惩罚(一个新的 参数)。
BIC 的惩罚项 让"加一个参数"在 时罚 ,在 时罚 ,惩罚力度涨幅平缓。对于真实存在的随机效应(如本数据的学校层方差 365),BIC 在样本量足够大之前仍然可能拒绝复杂模型,把真实结构当噪声。
诊断方法:跑 LRT 看 值。LRT 不依赖样本量惩罚的具体常数,给出的是"这份数据上简化模型为真的概率"。同时看模型残差与 BLUP 的描述统计:如果忽略学校层之后班级层方差离奇膨胀(本数据 638 vs 283),说明有一层方差被错放。AIC 与 BIC 联合看,两者一致才放心;分歧时优先按 LRT 与残差诊断决策,再考虑预测目的(AIC 偏预测)还是解释目的(BIC 偏简单模型)。
本数据三层模型在所有准则下都赢,没有触发这个雷区。
方法选择决策树
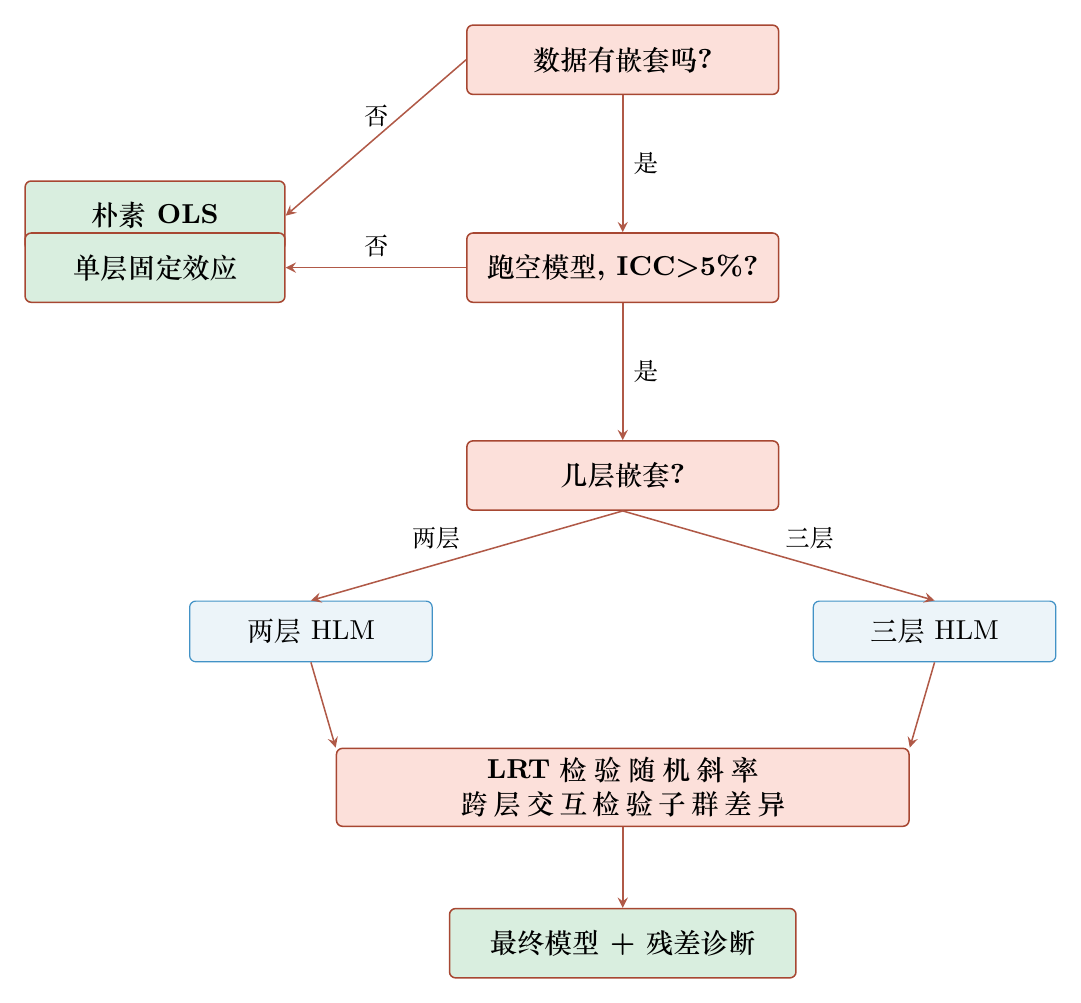
读者读完本书最关心的问题大概是:拿到一份新数据,应该用哪个模型?这件事没有"通用答案",但有一条思路可以顺着走完。
最先要问的是数据是否有嵌套。观测之间没有任何分组结构——纯横截面、独立抽样——朴素 OLS 就够用。如果有嵌套,接下来确定嵌套层数。学生在班级里、班级在学校里是三层;患者在医院里、医院在城市里也是三层;员工在团队里、团队在公司里通常算两层(公司这一层往往要么没数据要么样本太少)。对每一个潜在的高层(班级、学校、医院、公司),跑一个空模型把这一层的 ICC 算出来。ICC 超过 5% 就值得保留这一层;超过 10% 必须保留。
层级确定之后,再决定每一层的随机效应只有截距还是也有斜率。怀疑某个解释变量的效应在不同组间不同时(比如怀疑 SES 的效应在不同班级里不一样),加随机斜率,并用 LRT 检验它。本书第 6 章给的例子是 ses_F 的随机斜率 LRT ,没有支持,最后没保留。如果怀疑处理效应在某个学生层子群(性别、SES、族裔)上有特别的作用,再用跨层交互检验。本书第 7 章的例子是 cltype ses_F,交互 ,没有支持,但跨层交互本身是一种值得检验的可能性。
模型选定之后还有诊断与敏感性分析这一关。残差按层级拆开看 QQ 图,做 leave-one-out 看主结论是不是被少数高层单位绑架。这一步的标准做法是 Snijders & Berkhof 2008 给的分层残差框架。
整条思路对应的是 Hox 在多层建模教材里给出的方法选择策略:先建空模型确定层级,再加 Level-1 固定效应,再加 Level-2 / Level-3 固定效应,再讨论随机斜率与跨层交互,最后做诊断。本书前九章正是按这个顺序展开的。
在 STAR 数据上的最终结论
把本书所有方法收拢到一句结论:在 Tennessee STAR 数据上,从最朴素的 OLS(小班 +8.21 分,SE 1.56)到最复杂的三层 + 跨层交互(+9.10 分,SE 2.98),点估计在 +7.68 到 +9.10 之间漂移,差距主要取决于是否独立估计学校层方差。SE 的差距是关键:朴素 OLS 给出"高度显著"的过分自信结论,二层模型给出标准误膨胀的保守结论,三层模型在两者之间给出最贴合数据真实结构的诚实估计。
最稳妥的最终结论是:将一名 K 年级学生从 22–25 人的常班调进 13–17 人的小班,预期数学分数提升 8.84 分(95% CI ,)。8.84 分相当于 0.18 个标化测试标准差,是教育政策意义上不大但不可忽略的处理效应。区间下限 3.68 分意味着即使在最不乐观的情况下,这个效应也比零有相当距离。
回到第 1 章给的伏笔。"小班 +8 分"这个朴素结论作为方向是对的,作为推断却是有问题的。本书做的事就是让"+8 分"这个方向稳稳落在一个有诚实标准误的估计上。处理变量在班级层变化,估计这个效应必须考虑学生在班级里的相关性;而学校层在 STAR 数据里贡献了 17% 的总方差,必须独立成一层。把这两件事都做到,才得到 +8.84 分(SE 2.63)这个最终数字。
把多层建模工作流搬到新数据
读完十章,读者已经走过一份完整的多层建模流程:从看见嵌套结构、识别 ICC、跑空模型、加 Level-1 与 Level-2 固定效应、引入随机斜率与跨层交互、扩展到三层、做诊断与敏感性分析、最后做方法对比。这不是教材里的"方法清单",是一份可以直接搬到自己数据上的工作流。
把这份工作流搬到新数据时有几件事要记住。先画嵌套层级图,把数据里的"学生在哪、班级在哪、学校在哪"在纸上画清楚,再写代码。先跑空模型算 ICC,决定哪几层值得保留。把模型逐步建复杂,每加一个固定效应或随机效应都做一次 LRT 与残差诊断,避免一上来就把所有变量塞进最复杂的模型里。把每一步的估计摆出来对比,让读者(包括自己)看到"加这一项之后小班效应变成了什么样"。
最后一件事是 STAR 数据本身告诉我们的。这份数据来自 1985 到 1989 年的田纳西州,26,796 条观测里包含了 11,598 名学生四年的成长。它不是模拟数据、不是教学示例,是 1,200 万美元真实政策实验留下来的遗产。本书每一章给出的数字都是这份数据在 R 里的真实输出。把"小班 +8.84 分"这个数字写进本书的最后一章,意味着它经得起朴素 OLS、二层 lmer、三层 lmer、随机斜率检验、跨层交互检验、模型诊断、影响分析七道检验。这个数字现在交给读者,去回答你自己手上那份嵌套数据的处理效应问题。