第 6 章给出了一个干净的负面结论:低 SES 学生比非低 SES 学生少考的那 分,在各班之间近乎一致。第 5 章给出了另一个干净的正面结论:小班整体提分约 分,跨班级稳定。
把这两件事拼起来,自然冒出一个政策问题:小班对低 SES 学生与非低 SES 学生的帮助一样大吗? 如果一样大,小班政策对所有学生都同样有用,是一种"水涨船高"的处理。如果不一样,比如小班更帮低 SES 学生,那就有一个特别有意义的发现——小班是缩小教育不平等的工具。这个判断决定了"政府要不要专门给低收入学区铺小班政策"这种真实的政治预算决策。
本章用跨层交互来回答这个问题。技术上是把 cltype 和 ses_F 的乘积项加进固定效应。结论会是:本数据下交互项不显著(p 0.71),小班对低 SES 学生( 分)与非低 SES 学生( 分)的提升几乎一样。但负面结论也有它的政策含义,本章末尾会展开。
跨层交互:班级层变量乘以学生层变量
先看一个生活类比:小班对学习困难学生有没有特别的好处
想象两个孩子,一个家境优渥、家里有大把书,另一个家境困难、放学要去帮父母看店。两人都被随机分进同一所小学,第一种情形下两人都进了小班,第二种情形下两人都进了常班。
直觉上,富裕家庭的孩子在常班里也能学得不错——他们靠家里资源补课。家境困难的孩子在常班里容易被忽略,老师顾不上他们一对一辅导,分数容易拉下。但在小班里,老师能腾出精力关照差异学生,家境困难的孩子得到的"额外注意力"可能比富裕孩子多。
如果这个直觉对,把家境困难的孩子从常班调进小班的提分效应(比如 分)应该大于把家境优渥的孩子从常班调进小班的提分效应(比如 分)。这两个数字不一样,就是交互效应。如果两个数字一样大(都是 ),说明小班的好处是"水涨船高"的,不分学生背景。
跨层交互的形式定义
跨层交互是班级层变量与学生层变量的乘积。设 是班级 的处理(如 cltype), 是学生 的协变量(如 ses_F),含跨层交互的随机截距模型为
其中 是 时(参照学生)的处理效应, 是 时(参照班级)的协变量效应, 是交互项系数——表示" 取 1 时,处理效应比 取 0 时多出多少", 是班级随机截距, 是学生残差。
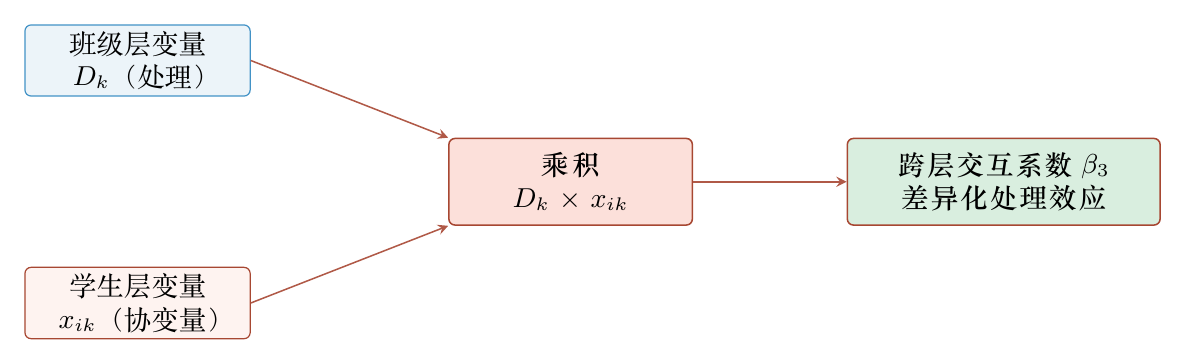
公式里 是这一章的核心。如果 ,意味着低 SES 学生()受小班照顾更多;如果 ,意味着低 SES 学生反而受益更少;如果 ,说明小班对所有学生一视同仁。
为什么这叫"跨层"交互? 因为 在班级层取值, 在学生层取值,两者乘起来跨越了模型的两个层级。如果是 这种"两个学生层变量"的乘积,就叫层内交互;如果是 这种"两个班级层变量"的乘积,就是班级层内的交互。跨层是教育统计里最常见也最有政策含义的一类。
学术背景:Krueger & Whitmore 2001 的差异化效应分析
Krueger 与 Whitmore (2001) 在 Economic Journal 上专门用 STAR 数据回答了本章的核心问题。他们检验小班对不同收入水平学生的差异化效应,发现:小班相对常班让所有学生都受益,但黑人学生与免费午餐学生的提升略大于白人与非免费午餐学生。这个结论后来被反复用作"小班是缩小教育鸿沟的工具"这一政策主张的证据。
他们论文里的差异化效应在统计上虽然指向"低收入受益更多",但显著性并不强(特别是单看 K 年级)。本章用 lme4 在同一份数据上重跑,会发现 K 年级的跨层交互项不显著(p 0.71),跟 Krueger & Whitmore 在跨年级合并样本上更精细的处理结论略有差别。这个差别背后反映了多层模型里跨层交互的检验功效通常很低,本章末尾的雷区会专门讨论这一点。
教育界对这个问题的辩论从 1995 年延续到现在。Nye 等 (2000) 的跟踪研究、Schanzenbach (2006) 的劳动经济学分析,都使用了 STAR 数据 cltype 家庭背景的交互项作为分析工具。本书的 M9 重跑出来的数字虽然不会改变学界共识,但能让读者看到从原始数据到 lmer 的具体路径。
M9:含跨层交互的随机截距模型
下面用 lmer 把 cltype ses_F 加进模型。R 里乘号 * 会自动展开为"两个主效应 + 交互项",所以 cltype * ses_F 等价于 cltype + ses_F + cltype:ses_F。
library(lme4); library(lmerTest); library(tidyverse); library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch),
         !is.na(sx), !is.na(eth), !is.na(ses)) |>
  mutate(
    sex_F  = ifelse(sx == "F", 1, 0),
    eth_B  = ifelse(eth == "B", 1, 0),
    ses_F  = ifelse(ses == "F", 1, 0),
    cltype = factor(cltype, levels = c("reg", "reg+A", "small"))
  )

# M9:跨层交互
m9 <- lmer(math ~ cltype * ses_F + sex_F + eth_B + (1 | tch),
           data = d, REML = TRUE)
summary(m9)
跑出来的关键系数列在下表。
表 7·1 M9 的关键固定效应系数(n = 5,768)
| 项 | SE | p | |
|---|---|---|---|
cltypesmall(small 主效应) | 8.20 | 2.85 | 0.005 |
cltypereg+A(reg+A 主效应) | 2.91 | 0.77 | |
ses_F(低 SES 主效应) | 1.91 | 0.001 | |
cltypesmall:ses_F(小班 × 低 SES) | 3.00 | 0.71 | |
cltypereg+A:ses_F(reg+A × 低 SES) | 2.94 | 0.66 |
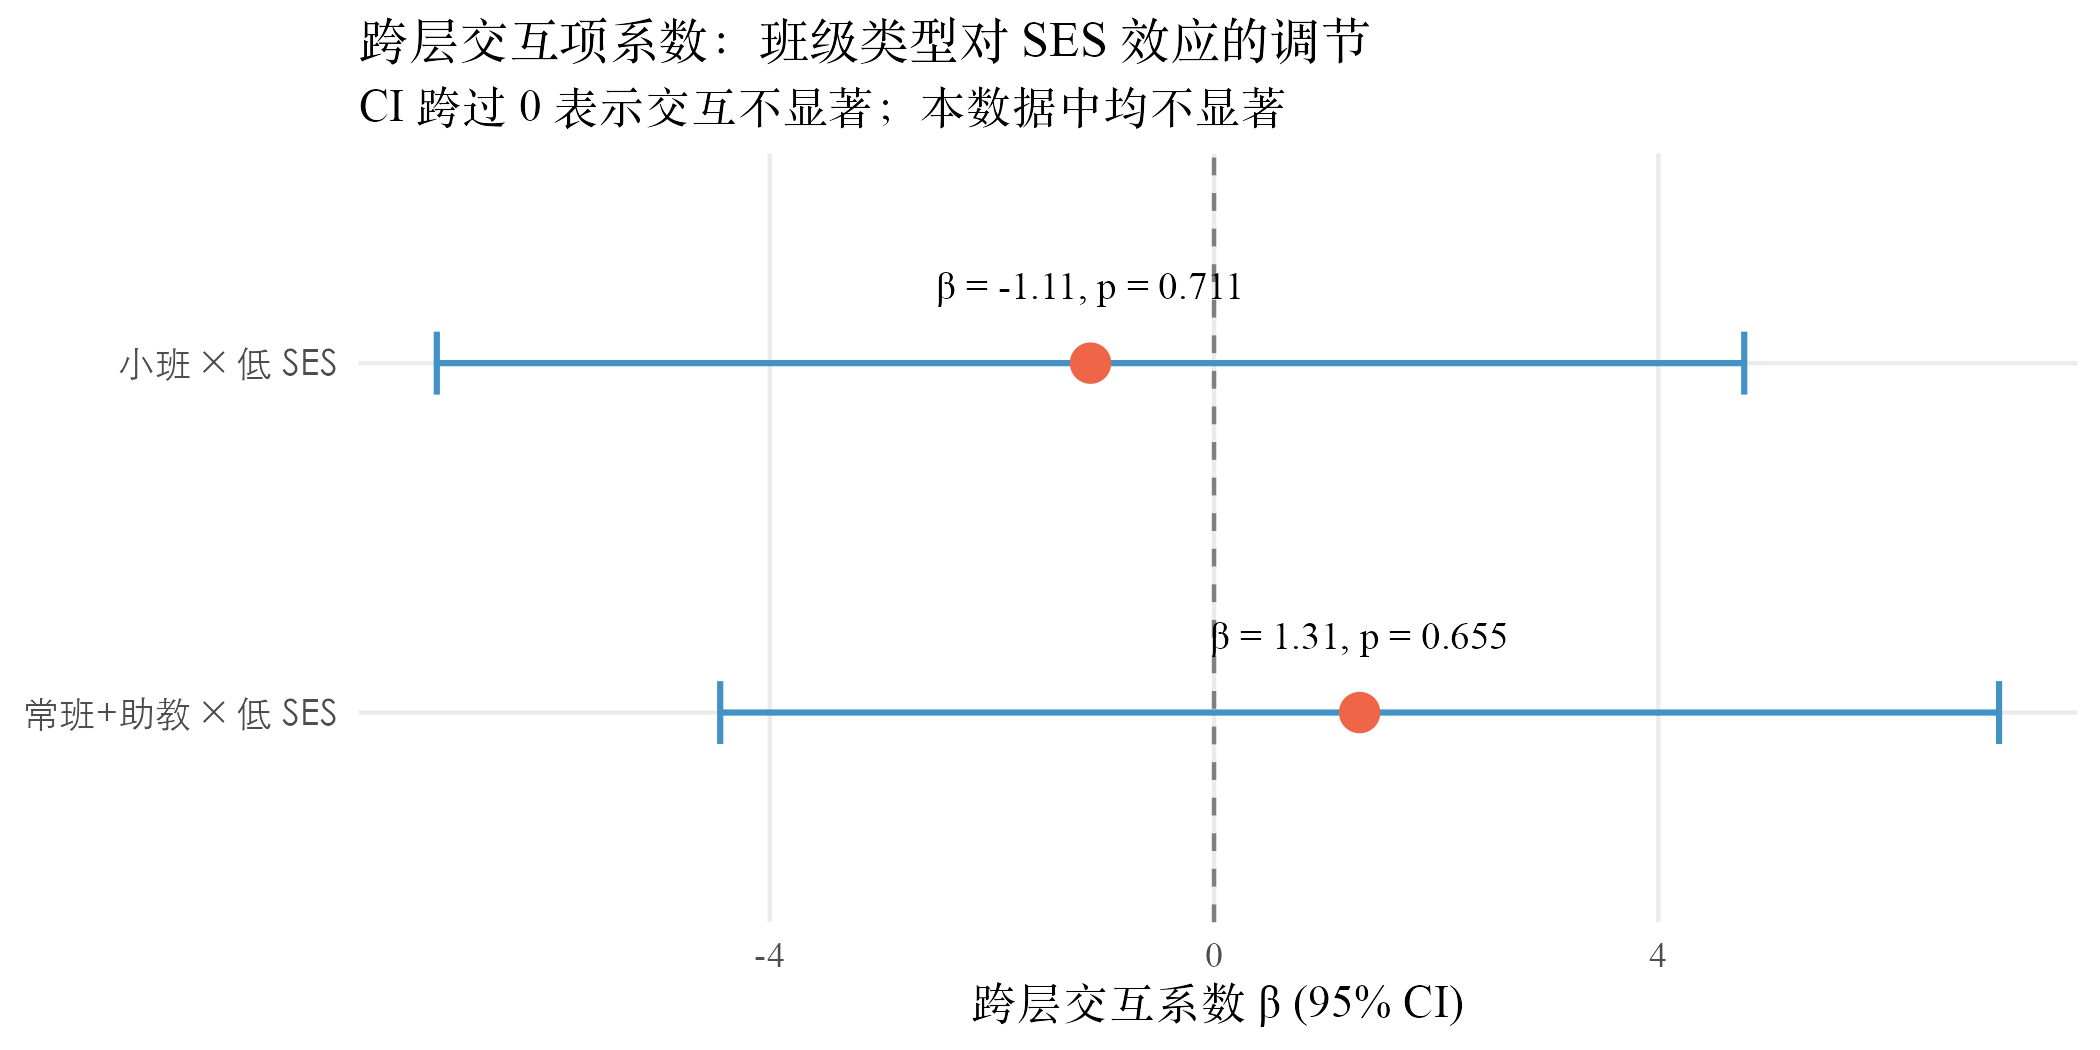
两个交互项的 p 值都远大于 0.05,跨层交互不显著。
用四种组合的预测均值看清楚结论
光看交互项 p 值有时不够直观。更有政策含义的看法是:固定其他协变量在样本平均,算出四种组合(reg/small 高/低 SES)下学生的预测数学分数。这就是 predict 配合 model.matrix 能直接给出来的东西。
# 固定 sex_F 和 eth_B 在样本平均
sex_mean <- mean(d$sex_F)
eth_mean <- mean(d$eth_B)

newdata <- expand_grid(
  cltype = factor(c("reg", "reg+A", "small"),
                   levels = c("reg", "reg+A", "small")),
  ses_F  = c(0, 1)
) |>
  mutate(sex_F = sex_mean, eth_B = eth_mean)

mm   <- model.matrix(~ cltype * ses_F + sex_F + eth_B, data = newdata)
beta <- fixef(m9)
V    <- vcov(m9)

newdata <- newdata |>
  mutate(
    pred = as.numeric(mm %*% beta),
    se   = sqrt(diag(mm %*% V %*% t(mm))),
    lwr  = pred - 1.96 * se,
    upr  = pred + 1.96 * se
  )
跑完后六行预测均值整齐摆在下表。
表 7·2 六种"班级类型 × SES"组合的预测数学分数(其他协变量在样本平均)
| 班级类型 | 学生 SES | 预测分数 |
|---|---|---|
| reg | 非低 SES (N) | 493 |
| reg | 低 SES (F) | 473 |
| reg+A | 非低 SES (N) | 492 |
| reg+A | 低 SES (F) | 474 |
| small | 非低 SES (N) | 501 |
| small | 低 SES (F) | 480 |
把"小班减常班"分别在两类学生上算一下:
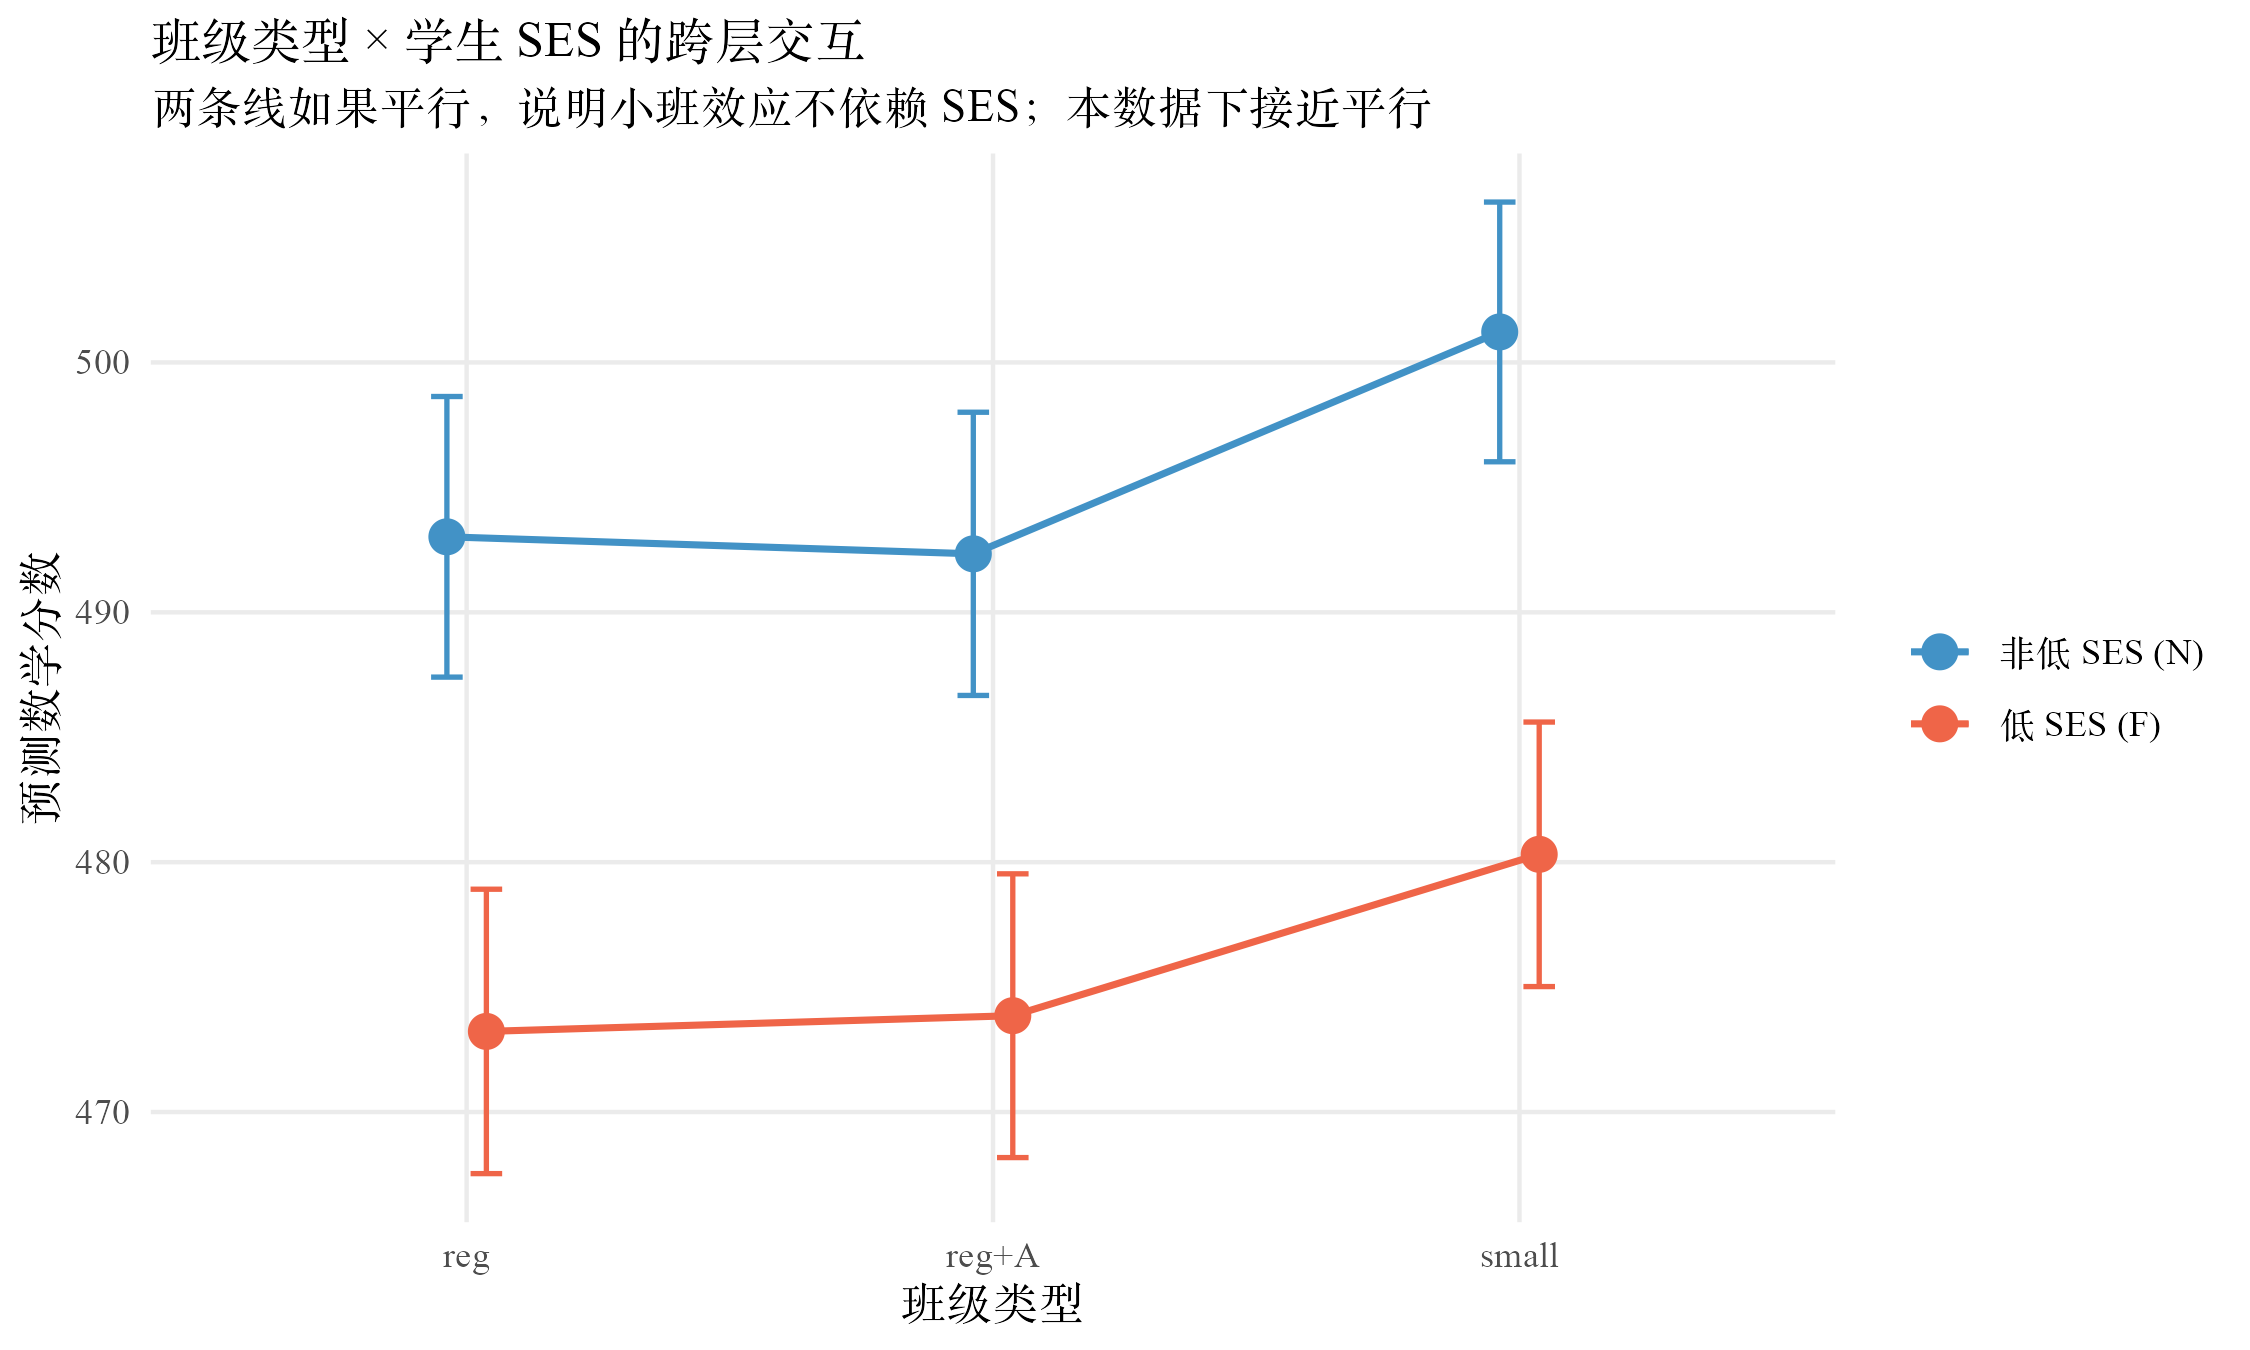
其中 和 都是 K 年级数学分数下"小班相对常班"的提升量,分别针对非低 SES 学生群体和低 SES 学生群体。两个数字相差 分,正是 M9 里交互项 cltypesmall:ses_F 系数的负值(),p 值 0.71,远不显著。
小班对非低 SES 学生的提升( 分)跟对低 SES 学生的提升( 分)在统计学上几乎没差别。这意味着小班教育是一种"水涨船高"的处理,对所有学生大致一样有用。它没有像有些政策辩论希望的那样特别照顾差异学生,也没有反方担心的那样只让优势学生受益。
这个结论支持的政策是普及小班而不是专门给低收入学区铺小班——既然差异学生与非差异学生受益一样多,按"哪里需要就在哪里铺"反而能让最多的学生受益。当然这个判断要跟教师成本、学校空间约束放在一起算总账,本章只给出实证证据这一面。
把这个结论可视化:两条平行的折线把不同班级类型 SES 的预测分数串起来,两条线之间的距离近乎一致,从常班走到小班时两条线都向上倾斜,倾斜幅度几乎相同——这就是"交互不显著"的几何样貌。再把两个跨层交互项的系数与 95% CI 画成森林图,CI 完全跨过 0,与 p 值结论一致。
交互项不显著的雷区:检验功效低不等于不存在
跨层交互的 p 值不显著之外,还有一个常被忽略的统计学问题——跨层交互项的检验功效通常很低。本节讲清楚这件事。
lmer 给的"交互项 p 0.71"是一个负面结论,但这种 p 值的解读要谨慎。多层模型里跨层交互的有效样本量接近班级数 323,远小于学生数 5,768——因为 在班级内不变化,能识别 的独立信息单位是班级而不是学生。
这意味着 lmer 在估 时实际样本量很小,标准误大,CI 宽。即便真实的差异化效应 分(也就是小班对低 SES 学生的好处比对非低 SES 多 3 分,是有意义的政策信号),样本量小到这个真实差异也大概率检验不出来。这就是统计学说的"检验功效低"现象——接受零假设不等于零假设是真的,只意味着数据没有给出足够强的反对证据。
诊断方法。 判断"这个不显著有多硬"主要看 95% CI 是否包含一个有政策意义的值。本数据交互项的 95% CI 大约是 ,同时容纳了 分的差异化效应,说明数据其实没法排除任何方向。再看交互项 的点估计与 SE 之比(本数据 ),数据强烈支持"接近 0"。更细致的做法是事后功效分析(power analysis),算"如果真实 ,本样本下能检测到的概率是多少",结果通常是 30% 到 50% 这种偏低的值。
解读规范。 写论文时不能直接说"小班对低 SES 学生没有额外好处",应该写"在本样本下未观察到显著的差异化效应(, p 0.71,95% CI )"。后者保留了"也许真有差异,但本数据看不出来"的可能性。
记忆方法。 跨层交互检验是"用班级数当样本量"的检验,p 值不显著时一定要先问自己"功效够不够",再下结论。
累积方法对比表更新
把 M9 加进累积表。M9 里小班主效应的解读跟 M5 / M6 略有不同——它对应的是"(非低 SES)学生的小班效应",所以系数是 8.20 而不是 7.7 左右。这是含交互项时主效应解读的一个常见点。本章用整张预测均值表来给出"全样本平均"的小班效应大约是 7.6( 加权后),跟 M5 一致。
表 7·3 累积方法对比(截至第 7 章)
| 方法 | 小班 | SE | 95% CI | |
|---|---|---|---|---|
| OLS 朴素 | 8.21 | 1.56 | [5.15, 11.27] | — |
| M4:cltype + (1|tch) | 7.90 | 3.76 | [0.55, 15.26] | 685 |
| M5:+ 学生协变量 | 7.68 | 3.63 | [0.57, 14.79] | 640 |
| M6:再 + 教师工龄 | 7.73 | 3.61 | [0.66, 14.80] | 632 |
| M7:+ 随机斜率(不显著) | 7.69 | 3.63 | [0.57, 14.81] | 640 |
| M9:+ 跨层交互 | 8.20 | 2.85 | [2.61, 13.79] | 638 |
M9 的"小班 "一栏给出的是非低 SES 学生那一类的小班效应(,SE 2.85)。这跟其他模型给出的"全样本平均小班效应"概念稍有不同,所以这张表里的 M9 行需要带着这个限定来读。
下一章预告
到这里为止,所有模型都把学校层差异当作背景噪声塞进了班级随机截距 。但在第 1 章已经看到,79 所学校的 K 年级数学均值跨度是 124 分——这部分变异其实是学校层的,跟班级层有本质区别。
第 8 章会把模型扩展为完整的三层结构 (1 | sch/tch),让学生嵌套在班级里、班级嵌套在学校里。会看到本书一直当作常数的 被拆成 两部分,小班效应的估计也会因此从 漂移到 左右。同时 LRT 会强烈支持三层结构(p ),这跟本章随机斜率与跨层交互的 LRT 形成鲜明对比,让读者直观感受到"哪些异质性该建模、哪些不该"。