第 4 章把性别、族裔、家境三类学生层协变量加进了 Level-1,让 5,768 名学生的分数在进入合并之前先被自身背景"解释"了一部分。剩下没解释的部分,最大的一块还是班级之间的差异—— 比残差 小,但仍然是一个不能忽视的方差源。这块班际差异从哪里来?它有没有结构、能不能被"小班 vs 常班"这个处理变量解释一部分?
本章把核心处理变量 cltype 加进 Level-2,给出本书所有讨论都绕回去的那个数字:小班相对常班,K 年级数学分数大约提高了 7.7 到 7.9 分。 更重要的是,这一章会让读者看到,把 OLS 的 (SE 1.56)改写成 HLM 的 (SE 3.76),点估计几乎没变,但对这个数字的把握度变了一大截。这就是本书第一次正式收获多层建模的"果实"。
班级层固定效应:把处理变量放在哪一层
把 cltype 加进模型,在写法上只是 lmer 公式右边加一个项。但它在统计学上属于一个完全不同的类别:班级层固定效应。这个名字背后藏着一个对模型解释力影响巨大的设计决策,本节先把它讲清楚。
先看一个生活类比:班里发助教就像班里多请一个家教
想象一所小学开学第一天,校长把入学的新生全部洗牌,按抽签的方式分进 4 个班里。4 个班的差别只有一个:1 班是小班、2 班是常班、3 班是常班加助教、4 班再补一种。校长这个动作叫班级层随机分配——分配的对象是班,不是单个学生。
这件事情决定了 cltype 在多层模型里只能放在 Level-2,不能放在 Level-1。同一个班里所有学生共享同一个 cltype 值,它的变异完全发生在班与班之间,而不是学生与学生之间。在一个 17 人的小班里,没人是"半个小班学生",全 17 人都同时享受这种处理。
班里发助教跟班里没助教的区别,就像一个班整体多请了一个家教,整班受益。家教不会只服务班里某一个学生,而是绕着全班转。这正是 cltype 在班级层而不是学生层的原因。
班级层固定效应的形式定义
设第 个班级的处理状态为 ,取值为 reg、reg+A 或 small(参照类是 reg)。把它放进多层模型的 Level-2,得到含班级层固定效应的随机截距模型:
其中 是第 个班里第 名学生的数学分数, 是指示函数, 表示平均而言把一名学生从常班调进小班分数提高了多少, 是常班加助教相对常班的差, 是班级随机截距, 是学生残差。
公式里 和 都没有学生下标 ,因为它们对班里所有学生都一样。这正是把它放在 Level-2 的统计含义:处理变量在班级层取一个值,整班共享。
为什么要这样写?因为如果错把 cltype 当作学生层变量,假设它能在班里的学生之间变化,模型会误以为有效样本量是 5,768 而不是班级数 323。这正是第 2 章讨论过的"独立性假设破坏标准误"的精确版本。
多层模型里识别处理效应的关键:随机分配在哪一层
当处理变量 在第 个班级层被完全随机地分配,即 ,则在含 的随机截距模型中, 的系数是因果意义上的平均处理效应。如果分配不是随机的, 的系数还会包含选择偏差。
STAR 数据的优势就在这一点。班级类型是 1985 年校长抽签决定的,跟班级随机截距 在分配那一刻独立。所以 这个估计可以直接读作"小班相对常班的平均处理效应",不需要再做倾向得分匹配、双重差分或者其他因果识别策略。
这点和一般观察性多层数据相当不同。 如果数据里"小班"是因为家长给孩子报名精英小班自己跑去报的,那么 cltype 跟 就不独立——精英小班的家庭背景本来就更优, 不再是因果效应。STAR 因为是随机分配的实验数据,绕开了这个问题。本章接下来给出的所有数字都建立在这个识别基础上。
学术背景:为什么 STAR 是教育统计的奠基样本
随机分配的小班实验在 1985 年之前几乎没人做过。教育界长期靠观察性数据推论小班效应,但低生师比的学校往往本身就有更好的资源、更优秀的师生,混杂得一塌糊涂。Mosteller (1995) 在 The Future of Children 上发表了 STAR 的早期分析,论文标题直接叫《幼儿园到三年级班额减小研究:作为美国教育史上最重要实验的田纳西研究》。从那以后,STAR 数据成了教育政策辩论的关键证据。
经济学界对 STAR 的引用更频繁。Krueger (1999) 在 Quarterly Journal of Economics 上用 STAR 数据估算了小班效应的劳动经济学含义,给出了"分到小班一年大约能拉高 0.2 个标准差测试分数"这个被广泛引用的数字。Krueger 与 Whitmore (2001) 又跟踪 STAR 学生的中学表现,提出小班效应不仅在小学存在,还能延续到 SAT 和大学入学率。
后来 lme4 的作者把 STAR 收进 mlmRev 包作为多层建模教学的标准样本,正是因为它同时具备几样珍贵的特性:处理是随机的(因果可识别)、嵌套结构清楚(学生—班级—学校)、样本足够大(5,768 名学生)。本章接下来用 lme4 对它跑出来的数字,与 30 年来教育统计文献里的数字会高度一致。
从 M3 到 M4:把 cltype 放进随机截距模型
第 4 章给出了 M3——含三个学生层协变量(性别、族裔、家境)的随机截距模型。它给出了 的班级方差。本章 M4 在它的基础上把 cltype 加进去,看看处理效应能不能在这个班级方差里"咬一块出来"。
为什么先单独跑 M4 再加学生层协变量
把 M4 设计成"只含 cltype",不含学生层协变量,是为了把"处理效应这一项的纯贡献"和"加了学生协变量后的稳定性"分开看。这是经济学和教育统计文献里常见的逐层加变量做法,目的是让读者看清每一步的边际效果。
library(lme4); library(lmerTest); library(tidyverse); library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch), !is.na(sch),
         !is.na(sx), !is.na(eth), !is.na(ses), !is.na(exp)) |>
  mutate(
    sex_F  = ifelse(sx == "F", 1, 0),
    eth_B  = ifelse(eth == "B", 1, 0),
    ses_F  = ifelse(ses == "F", 1, 0),
    cltype = factor(cltype, levels = c("reg", "reg+A", "small")),
    exp_c  = exp - mean(exp, na.rm = TRUE)   # 教师工龄中心化
  )

# M4:仅班级层处理变量
m4 <- lmer(math ~ cltype + (1 | tch), data = d, REML = TRUE)
summary(m4)

# M5:加学生层协变量
m5 <- lmer(math ~ cltype + sex_F + eth_B + ses_F + (1 | tch),
           data = d, REML = TRUE)

# M6:再加教师工龄
m6 <- lmer(math ~ cltype + sex_F + eth_B + ses_F + exp_c + (1 | tch),
           data = d, REML = TRUE)
把代码扔进 R 跑出来的 M4 关键数字在下表里。三个模型给出的小班系数在 到 之间晃,标准误在 到 之间晃,p 值都在 到 之间。
表 5·1 M4–M6 的关键系数(n = 5,768,323 班)
| 模型 | small | SE | p | reg+A |
|---|---|---|---|---|
| M4:cltype + (1|tch) | 7.90 | 3.76 | 0.036 | |
| M5:+ 学生协变量 | 7.68 | 3.63 | 0.035 | |
M6:再 + 教师工龄 exp_c | 7.73 | 3.61 | 0.033 |
三个模型的小班系数都落在 到 之间,差距远小于一个 SE()。这说明本章给出的核心数字对模型设定不敏感:哪怕加进或拿掉学生层协变量、教师工龄,结论几乎不变。这种稳定性是因果证据可信度的一种体现,因为如果小班效应只是某个混淆变量的伪相关,加进相关协变量后系数应该会大幅缩水。
常班+助教的系数始终在 0 附近(),p 值全部接近 1。这与第 1 章的朴素均值差 一致。结论是助教这个变量基本无效,至少在 K 年级数学分数上看不出差别。
对比朴素 OLS 与 HLM:点估计稳,标准误膨胀
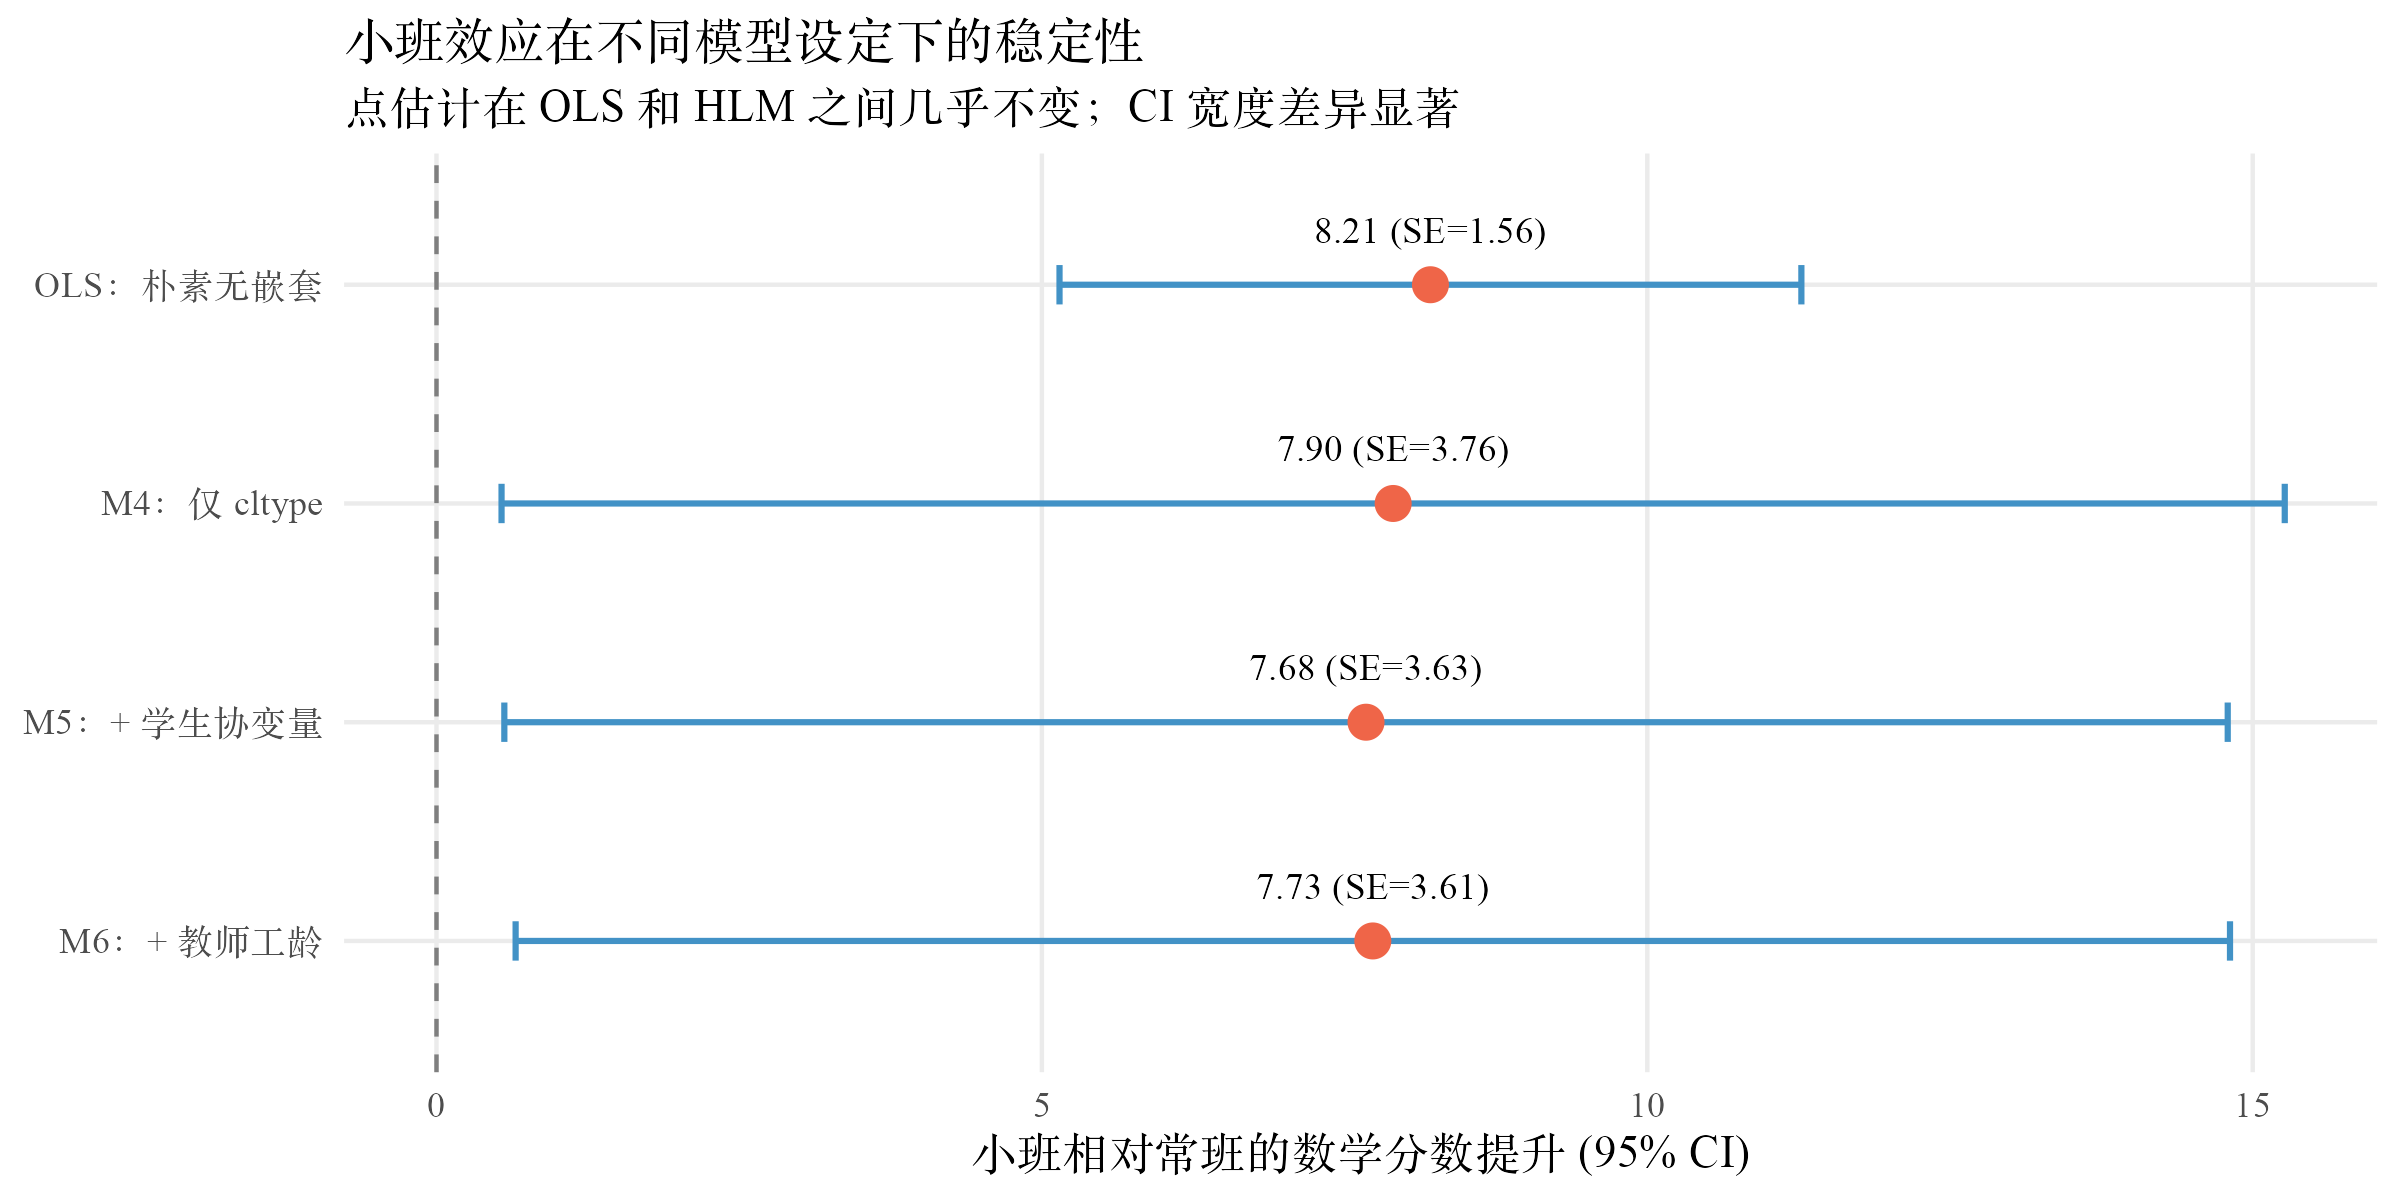
把朴素 OLS(, SE 1.56)摆到 M4 旁边,可以看到一个标志性的对比:点估计仅相差 0.31 分,标准误从 1.56 涨到 3.76,足足放大了 2.4 倍。
这跟第 2 章讨论的设计效应完全一致。 的有效样本量大约是 ,开根号正好把 SE 放大约 倍。OLS 之所以给出 SE 1.56,是因为它把 5,768 名学生当独立观测;HLM 给出的 SE 3.76 才是诚实地承认 17 名同班学生只值"约 4 个独立观测"之后的真实不确定度。
停下来想一想。 如果一个研究只报告 OLS 结果(, p 0.001),读者会觉得小班效应板上钉钉。换成多层模型后(, p = 0.036),仍然显著,但已经是"擦着 5% 显著线过去"的水平。这就是为什么严肃的教育政策评估都要求分析多层结构而不是用 OLS 凑数。
把这层意思放到森林图里:横轴是小班相对常班的分数提升,每一行是一个模型。OLS 的横线最短,HLM 系列的横线长 2.4 倍,但所有点估计都集中在 8 分附近。
班级层方差被 cltype 解释了多少
加完 cltype 之后还要做一件事——看看班级层方差有没有被它解释一部分。如果 cltype 真的把班际差异的一部分"咬掉了",那 应该比 M3 小。下表给出真实数字。
表 5·2 班级层方差在 M3–M6 之间的变化
| 模型 | 相对 M3 的"R" | ||
|---|---|---|---|
| M3:仅学生协变量 | 649 | 1516 | — |
| M4:cltype + (1|tch) | 685 | 1595 | |
| M5:cltype + 学生协变量 | 640 | 1516 | |
| M6:再 + 教师工龄 | 632 | 1515 |
M5 把班级层方差从 649 降到 640,cltype 解释了班级层方差的 1.4%。这个数字非常小,意味着班级之间的差异主要不是处理类型本身造成的,更多来自老师质量、班里学生组合的随机波动、班级氛围这些没能进入模型的因素。M6 加进教师工龄后再降 8 分,反映了"老师经验"也只能解释一小块班际差异。
小数字配上显著的处理系数,给出一个明确的结论:小班效应是真的,但它只占班际差异的一小块。绝大多数班际方差另有来源,需要更多信息(教师评估、教学风格、班级组成)才能进一步刻画。这也是后续章节要讨论的方向。
M4 的 比 M3 的 649 还大,相对 M3 的"R"是 。加了一个有意义的解释变量却让方差升高,需要单独解释。
这其实是多层模型里一个常见但被低估的现象。M3 的随机截距 在估计时,把所有班际差异(包括 cltype 造成的部分)都吸进了 ,并通过学生协变量稍微修正了一下。M4 把 cltype 拎出来作为固定效应,但同时也改变了模型里"班级随机截距对应的参考点"——M3 里 围着全样本均值波动,M4 里 围着常班均值波动(因为 reg 是参照类),两者的方差有可能不严格相等。更细致的原因是 cltype 不是连续协变量,REML 估计的方差成分对协变量编码方式不完全单调。
诊断方法。 不要把" 没下降"理解为"模型变差了",而要看固定效应的解释力。M4 给出的处理系数 与样本均值差 接近,处理效应被正确识别出来了;班级方差没缩反胀只是 REML 估计的副作用。M5(加了学生协变量后)的 才是更可靠的"班级方差剩多少"参照值。
记忆方法。 多层模型里"班级层 R"这个数字本来就不存在标准定义,最好的做法是给出所有模型的 表格,让读者自己看变化,不要把它强行套进 OLS 里"R"的解读框架。
班级 BLUP 的变化:班际差异在解释什么之后还剩多少
第 3 章解释过班级 BLUP 是什么——每个班的"被收缩过的"随机截距估计。一个有意思的对比是 M4 的 BLUP(仅 cltype)跟 M5 的 BLUP(加了学生协变量)之间有没有变化。
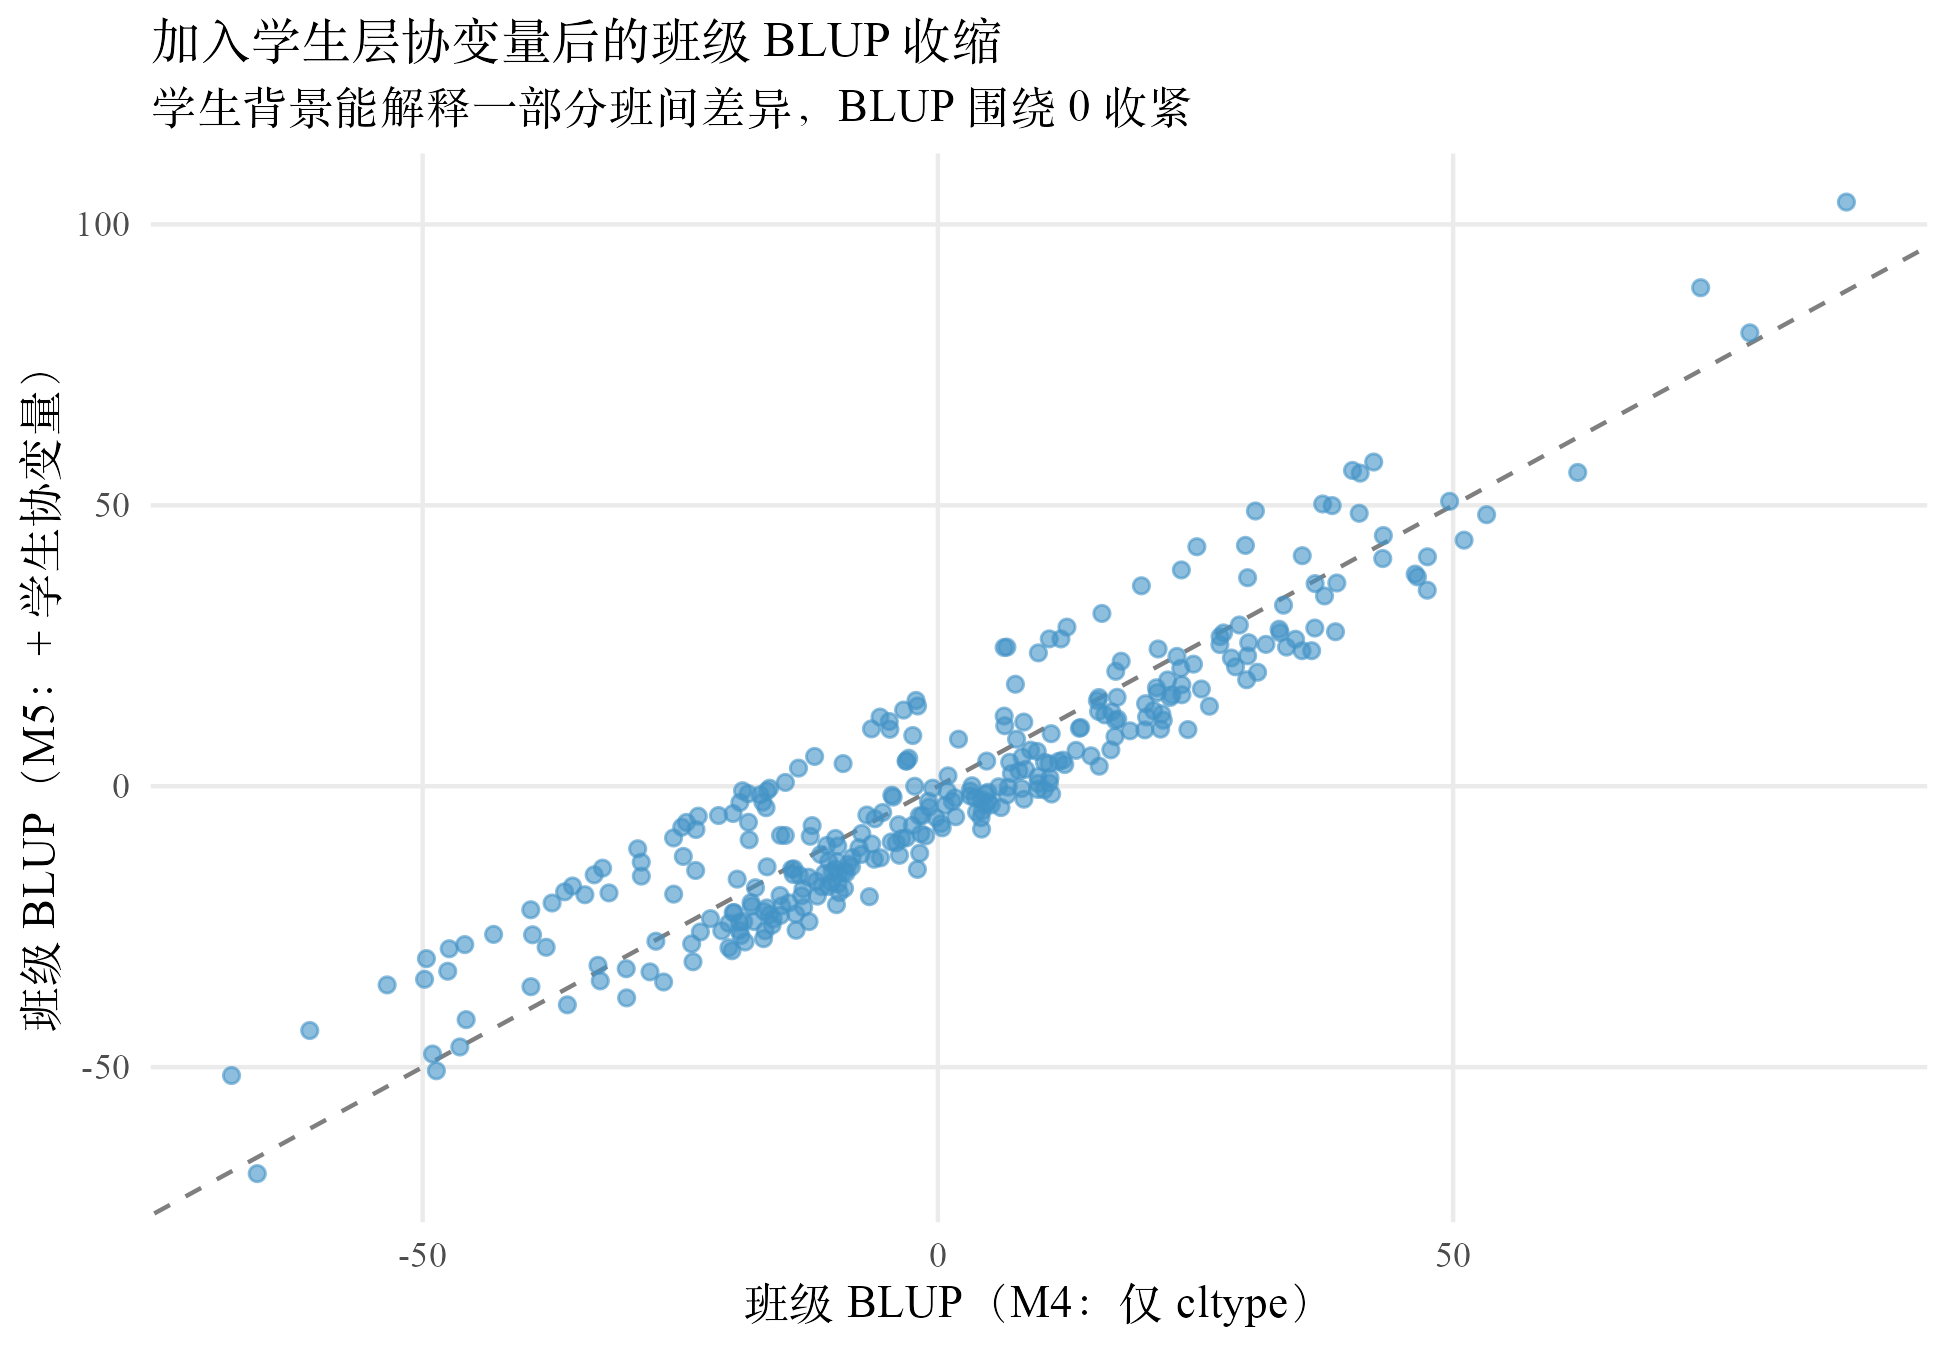
把 M4 与 M5 的班级 BLUP 画成散点图,两者高度相关,散点近似落在 直线上,但整体略向 0 方向收紧。解读是:M4 的 BLUP 包含了"学生组成不同造成的班级均值偏移",M5 把学生协变量纳入固定效应后,这部分偏移被剥离出去,剩下的 BLUP 更接近"老师本身的特质 + 班级氛围"那一块。
停下来想一想。 如果某个班 BLUP 在 M4 是 (看起来这班特别厉害),但 M5 里降到 ,这 5 分的差距就是被学生背景解释掉的部分。剩下的 才是除去学生组成之后这位老师真正让全班"超出平均"的那一份。这个洞见在评估教师效能(teacher value-added)的文献里被反复使用。
累积方法对比表(首次建立)
从本章开始,本书每章末尾都会更新一张累积对比表,把当章给出的小班效应、对应标准误、方差分量并列上去。到第 10 章会合并为终极版。本章是这张表的起点,前两行是对比基准(OLS 朴素和 HLM 仅 cltype),后两行是本章重点的 M5 和 M6。
表 5·3 累积方法对比(截至第 5 章)
| 方法 | 小班 | SE | 95% CI | |
|---|---|---|---|---|
| OLS 朴素 | 8.21 | 1.56 | [5.15, 11.27] | — |
| M4:cltype + (1|tch) | 7.90 | 3.76 | [0.55, 15.26] | 685 |
| M5:+ 学生协变量 | 7.68 | 3.63 | [0.57, 14.79] | 640 |
| M6:再 + 教师工龄 | 7.73 | 3.61 | [0.66, 14.80] | 632 |
第 8 章引入三层结构后,这张表会扩出 一列。第 10 章会再补 AIC/BIC 与终极结论。
下一章预告
到这里,本书第一个核心因果数字已经稳稳落在表上:小班相对常班,K 年级数学分数提高约 7.7 分,p 值约 0.035。但这个数字隐含一个假设——所有班级对低 SES 学生的"补偿效应"都一样。换句话说,M5 模型里 ses_F 的斜率被假定为固定值,每个班的"低 SES 学生比非低 SES 学生少多少分"都是同一个数。
这个假设合理吗?某些班级里的老师可能格外擅长照顾低 SES 学生,让差距收窄;另一些班可能差距更大。这种"斜率随班级变化"的现象,技术上叫随机斜率。第 6 章会让 ses_F 的斜率也成为随机效应,看看班际差距到底有没有显著的异质性,并用 LRT 给出明确的检验结果。