第 1 章末尾把"小班 +8.08 分"这个数字摆上了桌面。 分看上去干净利落,对应的 OLS 标准误是 1.56, 值小到 ,按常规教科书的结论就是"高度显著、政策可信"。但这个结论里藏着一个被悄悄绕过去的前提:朴素 OLS 把 5,786 名学生当成了 5,786 个互相独立的观测。同班的 17 名学生坐在同一间教室,听同一位老师讲课,分享同一种学习氛围。他们的分数高度相关,远谈不上独立。
把不独立的观测当独立来算标准误,会得到一个比真实情况小得多的不确定度。本章要做的事就是把这件事掰开。先用一段说明让读者亲眼看到"同班学生有多像",再引入两个关键诊断指标——组内相关 ICC 与设计效应 DEFF,最后用 lmer 跑一个最简单的随机截距模型,把朴素 OLS 与多层模型给出的两个标准误并列摆出来。第 3 章会顺着这条线,详细讲随机截距模型的方差分解到底意味着什么。
同班学生的相似性:把"独立观测"假设打开看
为了让"同班学生互相相关"这件事不再是抽象的统计假设,先随机抽 6 个班级看一下学生分数的实际分布。把这 6 个班里的所有学生按班级排开,每名学生一个点,灰色横线代表班级均值。
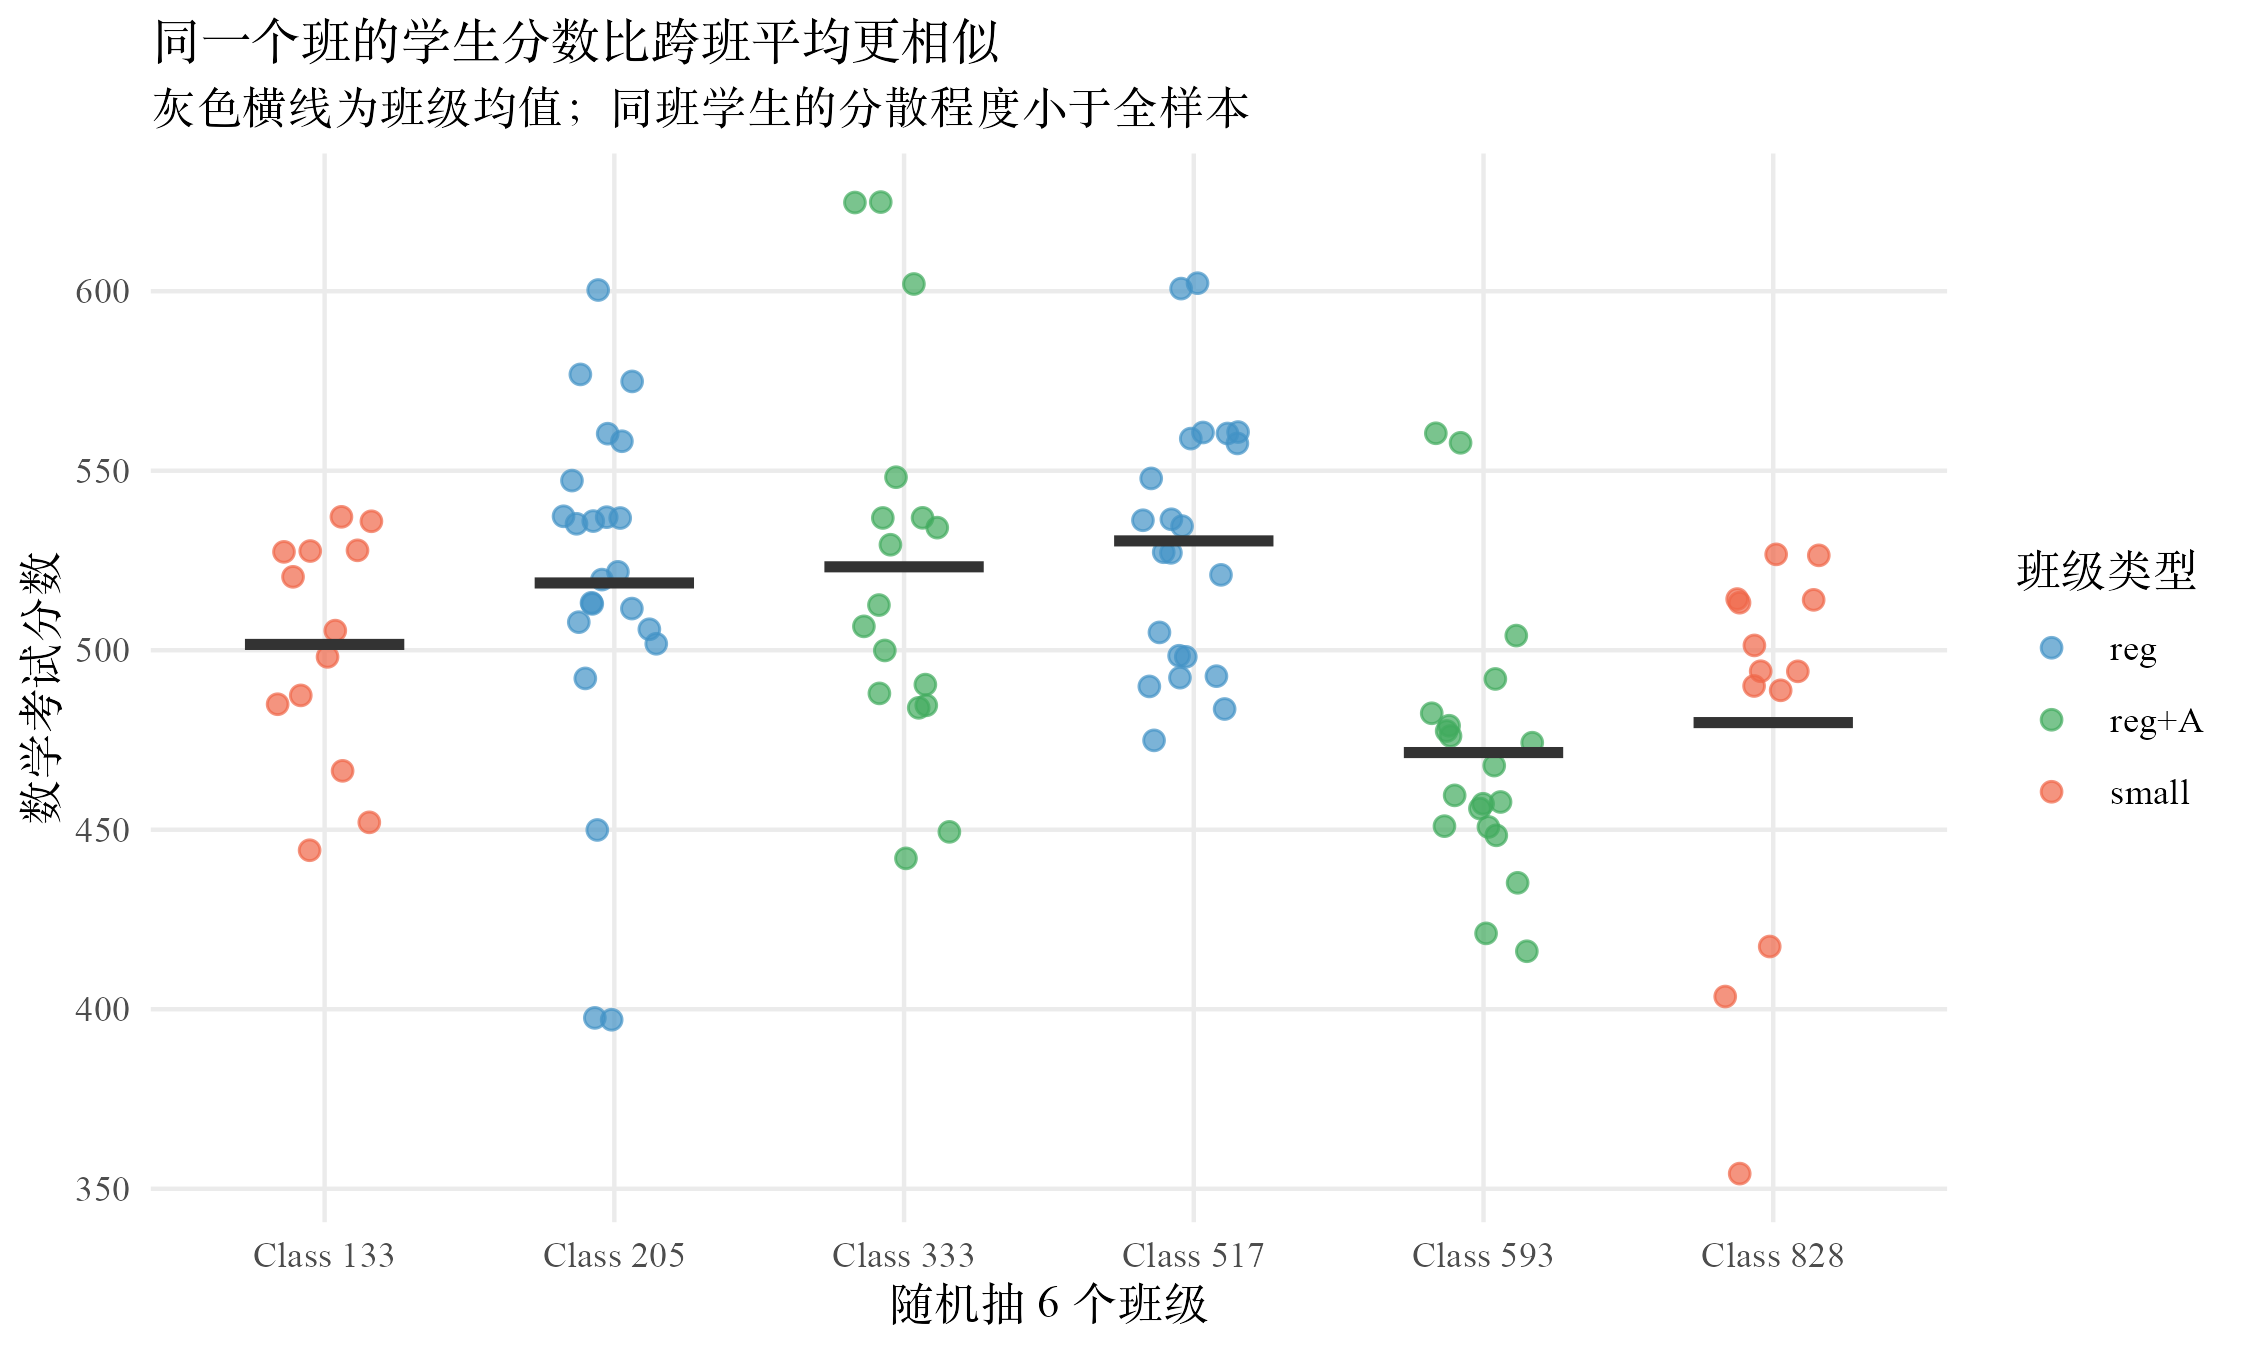
读这种分布图的方法是先看竖直方向,再看水平方向。同一个班里的学生分数集中在一个不大的范围里,往上下方向看几十分;但 6 个班的均值跨度能拉到一百多分。换句话说,跨班的差距比班内的差距更大。这就是"同班相似性"的视觉证据。
为什么会出现这种情况?因为分到同一个班的孩子被同一位老师教,老师讲课好坏会同时把全班 17 人的分数往同一个方向推。班里学习氛围浓,整班分数齐齐往上抬;老师当年家里出事请了几次假,整班分数齐齐往下掉。这部分由"班级共享的因素"带来的相似性,是嵌套数据最核心的特征。
停下来想一想。 如果你已经知道某名学生所在班级的均值是 525 分,再让你猜这名学生的具体分数,你会比"完全没信息"猜得更准。这种"班级信息"对"个体分数"的预测力,正是 ICC 衡量的对象。
组内相关 ICC:班级里的"发言权"分到哪一层
对一份嵌套数据,假设结果 (学生 在班级 )可分解为
其中 是全样本均值, 是班级 的随机截距偏差, 是同班学生之间的随机波动。组内相关 ICC(intraclass correlation coefficient)定义为
其中 是班级间方差, 是班级内(学生之间)方差,分母 是总方差。 取值在 0 到 1 之间,表示全部方差里有多少比例属于"班级层"。
ICC 这个数字看起来抽象,用一个生活场景就好理解。想象你走进一间教室开班会,老师让每个人挨个发言。如果班里气氛活跃、大家七嘴八舌、每个人意见都不一样,那"班级"这个集体几乎不存在共享意志,发言权完全在每位同学个人手里,对应 接近 0、 接近 0。反过来,如果班长一个人定调,全班跟着点头,那班级的"集体声音"几乎说明了一切,个体差异退到背景里,对应 非常大、 接近 1。
回到 STAR 的真实数字。用 lmer 拟合一个最简单的空模型 math ~ 1 + (1|tch),把全样本方差拆成班级间和班级内两部分,得到 、。代进定义里:
其中 689 是班级间方差(每个班的"基线"在班际之间漂多少),1,595 是班级内方差(同一班里学生分数相对班级均值漂多少),两者之和 2,284 是总方差。
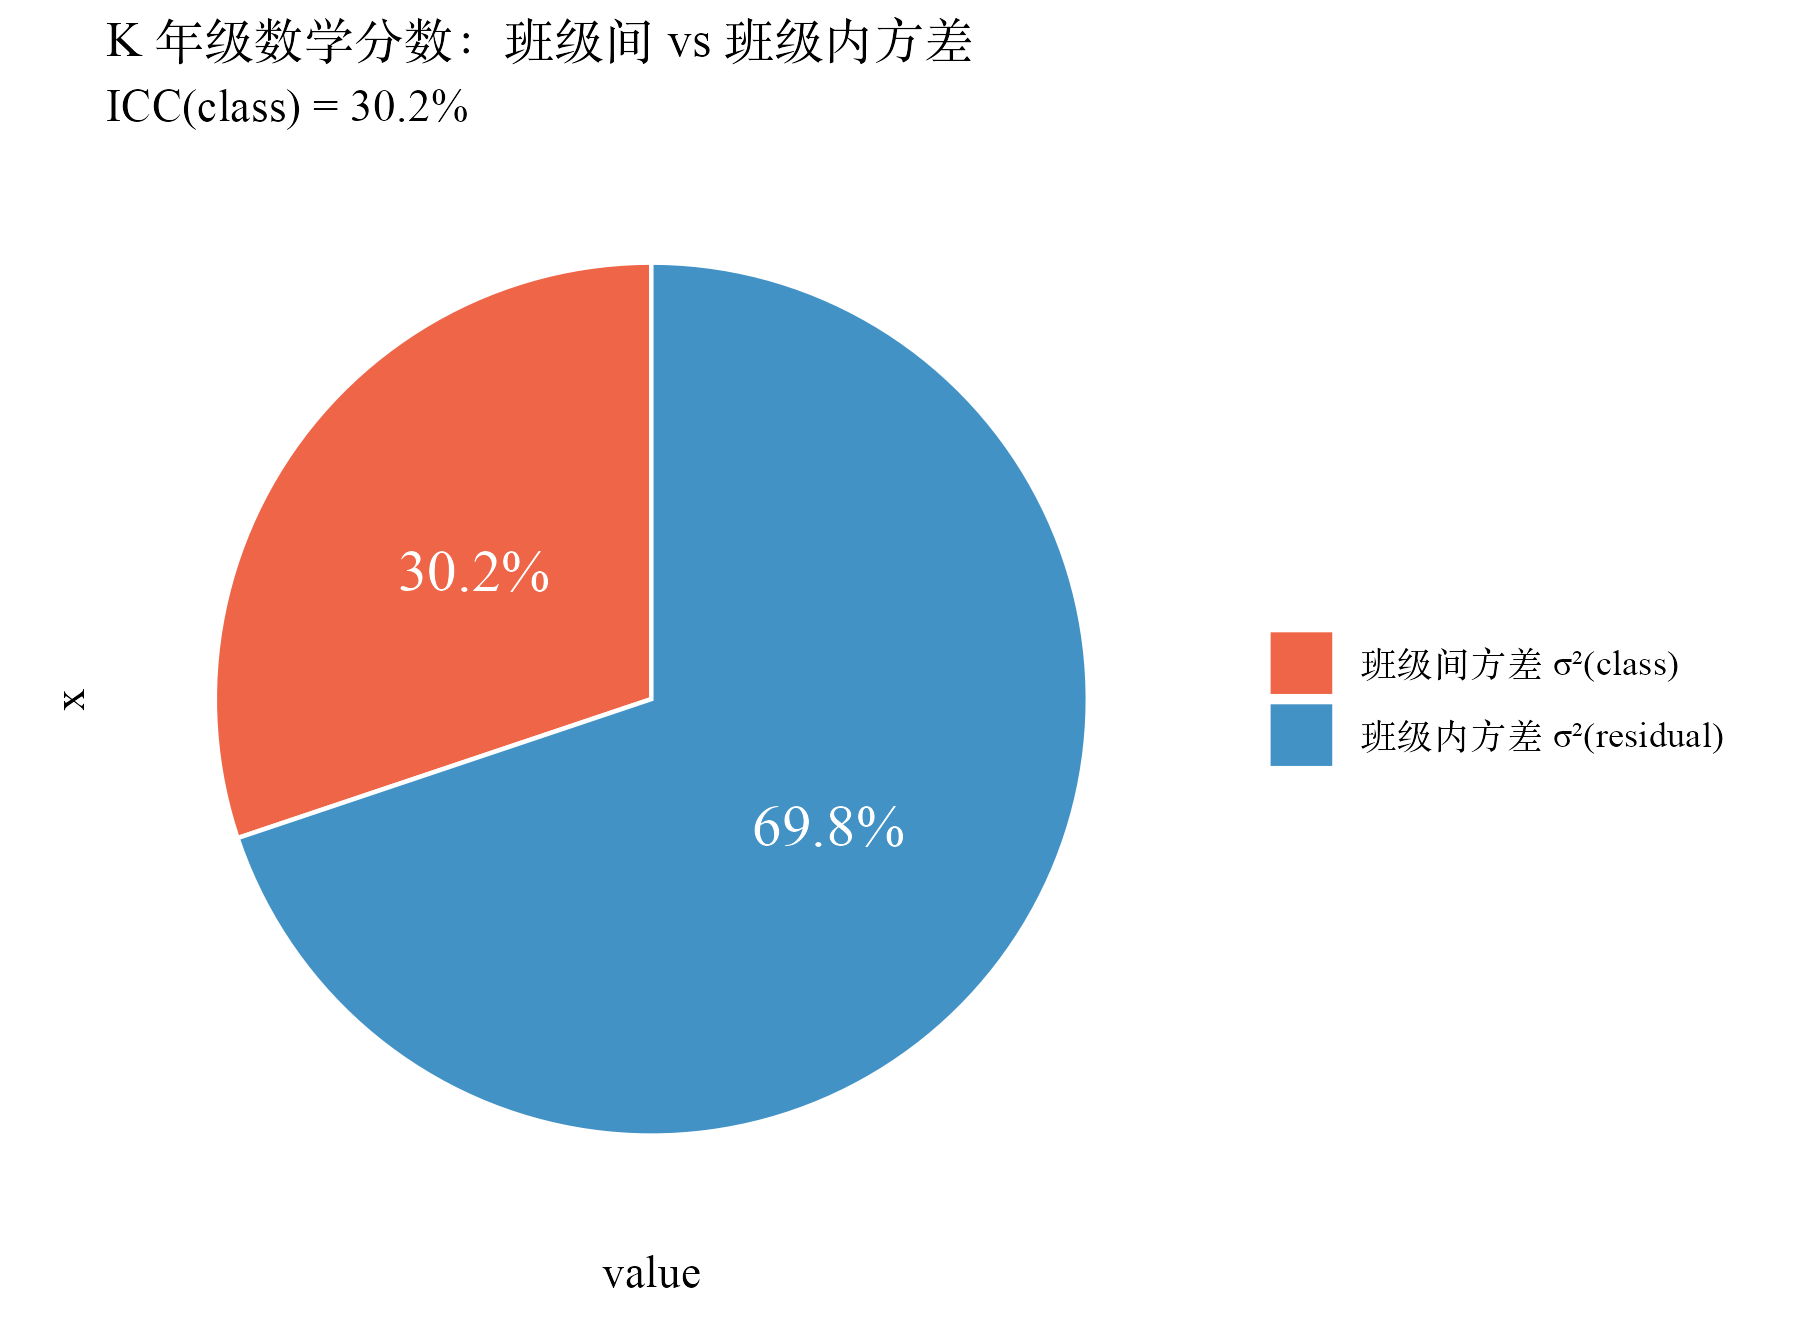
30.2% 这个数字怎么读? 它说"K 年级数学分数的总变异里,有大约三成是来自班级层的差异,其余七成来自学生个体之间的差异"。三成不算小。教育学文献里把 ICC 大于 5% 当成"必须考虑嵌套结构"的临界点,10% 已经是相当强的嵌套,30% 属于嵌套结构非常显著的数据。STAR 给出的这个数字,是教育领域研究里常被作为基准引用的强嵌套样本。
为什么要把 ICC 拆成这种"比值"形式而不是直接用 ?因为 本身随分数尺度变化,今天用 0–800 分的标化测试算出 689,明天换一份 0–100 分的小测验, 变成 11,但同学之间的相对相似性没变。把 除以总方差就把尺度去掉了,给出一个跨尺度可比的量。这是 1962 年 Donner 与 Bull 把 ICC 从动物育种领域搬进群组随机试验时给出的设计选择。
设计效应 DEFF:实际样本量被折算成多少
ICC 大不大本身不是终点,关键是它怎么吃掉样本量。这就要引入设计效应。
对每班平均 名学生、组内相关 的嵌套数据,设计效应定义为
其中 是平均班级人数, 是组内相关 ICC。它表示"考虑嵌套之后,朴素 OLS 算出的方差被低估了多少倍"。把实际样本量除以 DEFF,得到有效样本量 。
设计效应是 Kish 1965 在抽样设计文献里提出来的,原本是给整群抽样估总体均值准备的。后来被搬进多层建模,作为"嵌套结构对推断把握度的折扣"这个概念的速算工具。
代入 STAR 的数字:每班平均 ,,
其中 17.17 是 5,786 名学生分到 337 个班里得到的平均班级人数,0.302 是上一节算出来的 ICC。
这个 5.88 给样本量打了一个大折扣。 它说:"朴素 OLS 用 5,786 这个样本量算标准误,背后假设的是 5,786 个独立观测。考虑同班相关之后,相当于只有 个独立信息单位。" 换句话说,6 个 STAR 学生才相当于 1 个真正独立的观测。同班同学之间的"信息冗余"把样本量打了一个六分之一的折扣。
这个折扣是 ICC 大小与班级规模共同作用的结果。如果 ICC 是 0.05,每班 20 人,DEFF 只是 ,几乎不打折;ICC 涨到 0.3、班级规模再大一点,DEFF 一下就到 6 以上。STAR 这个 5.88 是嵌套数据里相当"恶劣"的一档。
本质是 OLS 标准误公式里的方差估计 假设残差互相独立。当残差实际上有正相关(同班学生分数同向漂动),残差平方和会被低估,分母 又用了"全样本"的自由度。两个偏差叠加,算出来的标准误比真实值小好几倍。
诊断方法:先用 lmer 拟合一个最简空模型 y ~ 1 + (1|group),从 VarCorr 抓 和 ,算出 ICC;ICC 超过 5% 就要警惕,超过 10% 就必须改用考虑嵌套的方法。
稳健替代:随机截距模型(本章给出的最简版本)、cluster-robust 标准误、广义估计方程 GEE 都能修这个问题。多层建模的优势是除了修标准误,还顺便给出每个班的随机截距估计,下一章会用到。
用 lme4 跑随机截距模型:朴素 OLS 与 HLM 标准误对比
把上面的诊断指标落到具体代码上。下面这段 R 代码做三件事:先跑朴素 OLS 把小班效应的 SE 算出来,再跑空模型抓出 和 ,最后跑带处理变量的随机截距模型,把考虑嵌套之后的小班效应 SE 摆出来。
library(tidyverse)
library(lme4)
library(lmerTest)
library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch), !is.na(sch))

# 朴素 OLS:把 5786 个学生当独立观测
ols_naive <- lm(math ~ cltype, data = d)
summary(ols_naive)$coefficients
#                Estimate Std. Error t value      Pr(>|t|)
# (Intercept)   483.2773    1.0735  450.21  0.000000e+00
# cltypesmall     8.0820    1.5645    5.17  2.341632e-07
# cltypereg+A    -0.3470    1.4955   -0.23  8.165843e-01

# 空模型:抓班级间方差与残差方差
m0 <- lmer(math ~ 1 + (1 | tch), data = d, REML = TRUE)
as.data.frame(VarCorr(m0))
#         grp        var1 vcov
# 1       tch (Intercept)  689
# 2  Residual        <NA> 1595

icc <- 689 / (689 + 1595)        # = 0.3017
nbar <- mean(table(d$tch))       # = 17.17
deff <- 1 + (nbar - 1) * icc     # = 5.88
n_eff <- nrow(d) / deff          # = 985

# 加入处理变量的随机截距模型
m1 <- lmer(math ~ cltype + (1 | tch), data = d)
summary(m1)$coefficients
#                Estimate Std. Error  df t value Pr(>|t|)
# (Intercept)   483.31      2.69  335   179.4   <2e-16
# cltypesmall     7.22      3.72  335    1.94    0.053
# cltypereg+A    -0.69      3.85  335   -0.18    0.858
关键是把朴素 OLS 与 HLM 给出的两个数字并列读。小班效应的点估计从 8.08 漂到 7.22,差距不大,模型选择不同对"平均效应有多大"这个问题影响有限。但标准误从 1.56 涨到 3.72,膨胀了 倍。 值从 变成 0.053,恰好擦着 0.05 的边——朴素 OLS 给的"高度显著"其实是统计幻觉,真实情况是这个差距勉强够得上传统显著性门槛。
设计效应 5.88 与标准误膨胀 2.38 倍并不矛盾:DEFF 是方差比,标准误是方差的平方根,,跟 2.38 几乎一致。两个数字其实在讲同一件事——同班学生的相似性把 5,786 这个样本量打成了 985 的有效信息。
这里要补一个细节。空模型给出的总方差 跟朴素 OLS 把 当独立样本算出的方差 非常接近,仅相差不到 1%。这说明随机截距模型并没有"无中生有"地多解释了什么变异,它做的只是把同一份总方差拆成班级间和班级内两块。同样多的方差,不同的分配方式,给推断带来天差地别的结论。这是多层建模与朴素回归最根本的差别。
从一个 SE 到方差分解的全图
本章把"为什么不能朴素"这个问题彻底讲清楚了。读者现在应该能复述这个故事:朴素 OLS 把同班学生当成独立观测,得到的 SE 是 1.56;考虑嵌套之后,SE 涨到 3.72,是原来的 2.38 倍;这个膨胀比例可以由设计效应 提前算出来;其中 是组内相关 ICC,由空模型的方差分解 得到。
但本章只把空模型当成"算 ICC 的工具"用了一次,并没有真正展开看它给出的三类输出——固定截距 、班级间方差 、班级内方差 。这三个数字背后还有许多内容没讲: 估的到底是什么"总均值", 这个数字开根号以后能不能跟原始的"班级均值 SD"对应起来,每个班自己的"截距偏差" 怎么估、估出来跟原始班均值有什么关系。这些是第 3 章的主题。
下一章会把空模型从头到尾解一遍:详细解读 lmer 输出的每一行,讲清随机截距如何用 BLUP 估计、为什么估出来的班均值会比原始均值"更靠近全样本均值"(这个现象叫收缩),还会讲清 REML 与 ML 两种估计方法在小样本下为什么给出不同数字。把空模型这块讲透,第 4 章再加学生层协变量、第 5 章再加处理变量就水到渠成。