第 3 章把空模型解释清楚了,但模型右边只有截距加随机效应。STAR 数据里的 sx、eth、ses 三个学生层变量根本还没动过。教育研究的常识告诉我们这三个变量都跟学习成绩相关——女生在小学阶段普遍数学略好、不同族裔学生在标化测试上有系统差异、低社会经济状况的孩子家里学习资源少。这一章的任务是把它们正式加进模型,看它们会怎么影响方差分量与小班效应估计。
加之前先要把样本量重新对齐。前两章用的是 5,786 名学生,因为只要 math、cltype、tch、sch 不缺即可。本章再加 sex、eth、ses 三个协变量做非空过滤,剩下 5,768 名学生分散在 323 个班里。差掉的 18 名学生跟 14 个班对全局结论没影响,但本章及之后的所有数字都基于这个新样本。
本章先一步步加变量观察方差分量怎么变,再讲组均值中心化怎么把同一个变量的"组内"与"组间"两块效应分开。最后用一个雷区警告:直接放原变量会把组内组间效应压成单一系数,而这个单一系数没有清晰的因果含义。第 5 章会把处理变量 cltype 加进来,正式给出本书第一个"考虑学生层协变量之后"的小班效应估计。
逐步加入学生层协变量:方差分量的变化
先把基线锚清楚。本章样本(n = 5,768,323 班)下重新拟合空模型,得到 、。班级间方差比第 3 章的 689 略低,是因为去掉的几个班里有方差较大的;班级内方差几乎没变。这两个数字是本节所有"协变量解释了多少方差"的参照基线。
接下来三轮加变量。第一轮加性别 sex_F(女生 = 1,男生 = 0),第二轮再加族裔 eth_B(黑人 = 1,其他 = 0),第三轮再加 SES ses_F(享受免费午餐 = 1,自费 = 0)。
library(tidyverse)
library(lme4)
library(lmerTest)
library(here)

d <- read_csv(here::here("data", "star_k.csv"), show_col_types = FALSE) |>
  filter(!is.na(math), !is.na(cltype), !is.na(tch), !is.na(sch),
         !is.na(sx), !is.na(eth), !is.na(ses)) |>
  mutate(sex_F = ifelse(sx  == "F", 1, 0),
         eth_B = ifelse(eth == "B", 1, 0),
         ses_F = ifelse(ses == "F", 1, 0))   # F = free lunch

m0 <- lmer(math ~ 1 + (1 | tch), data = d, REML = TRUE)
m1 <- lmer(math ~ sex_F + (1 | tch), data = d, REML = TRUE)
m2 <- lmer(math ~ sex_F + eth_B + (1 | tch), data = d, REML = TRUE)
m3 <- lmer(math ~ sex_F + eth_B + ses_F + (1 | tch), data = d, REML = TRUE)

summary(m3)$coefficients
#             Estimate Std. Error      df t value Pr(>|t|)
# (Intercept)  500.36     2.71   353.7  184.8  <2e-16
# sex_F          6.13     1.04  5479.9    5.9  4.0e-09
# eth_B        -14.34     1.95   358.8   -7.4  1.0e-12
# ses_F        -19.71     1.25  5650.2  -15.7  <2e-16
三个固定效应的方向跟教育研究的既有发现完全一致。女生平均比男生数学多 6.13 分(),尺度上对应约 0.13 个分数标准差。黑人学生平均比其他族裔少 14.34 分(),约 0.30 个标准差,是这三个变量里效应最大的之一。享受免费午餐的学生(低 SES 标志)平均比自费学生少 19.71 分(),约 0.42 个标准差,效应规模最大。
这些效应不是因果效应,是描述性的差距。族裔与 SES 都不能随机分配,估出来的系数把"族裔本身的影响"和"族裔关联的所有其他社区、家庭、学校因素"混在一起。但这些数字仍然有用:它们告诉我们 K 年级数学分数在人群中是怎么分布的,作为后续因果分析的描述性背景。
更值得读的是方差分量怎么变。下表把四个模型并列:
表 4·1 加入学生层协变量后的方差分量变化
| 模型 | (班级间) | (班级内) | 解释 within | 解释 between |
|---|---|---|---|---|
| M0:空模型 | 649 | 1,595 | 0 | 0 |
| M1:+ sex_F | 648 | 1,575 | 1% | 0 |
| M2:+ eth_B | 643 | 1,548 | 3% | 1% |
| M3:+ ses_F | 641 | 1,516 | 5% | 1% |
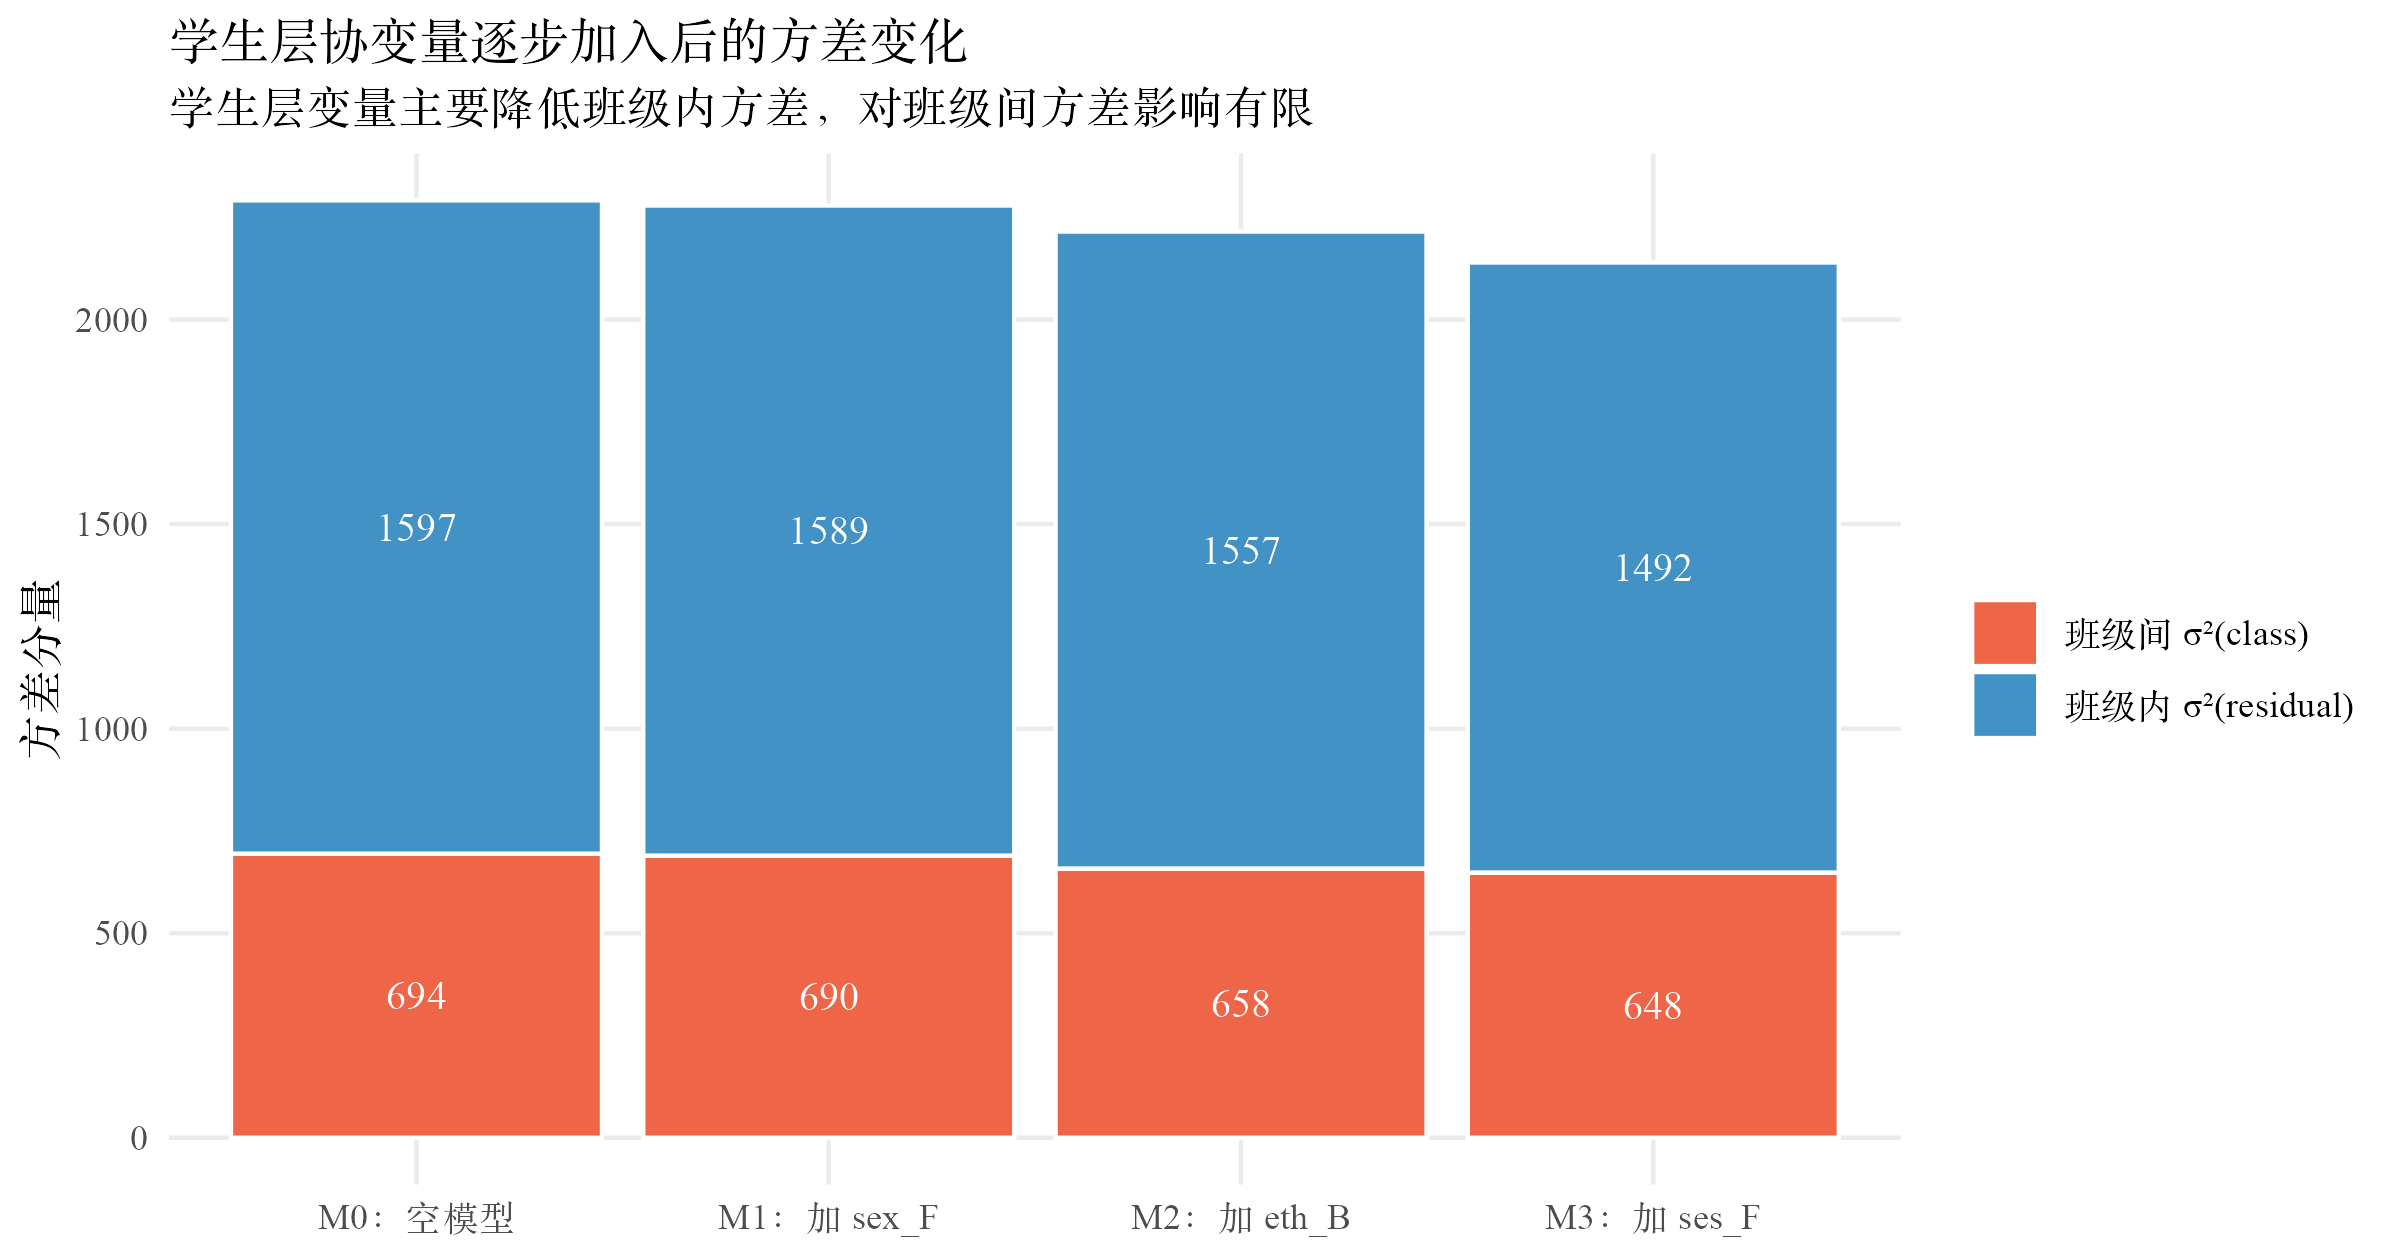
读这张表的关键是看两列方差的对比变化。学生层协变量从 M0 加到 M3,班级内方差 从 1,595 降到 1,516,压了 79 分约 5%;班级间方差 从 649 降到 641,几乎没动。这个对比给出一条重要的经验规律:学生层协变量主要解释学生层方差。
为什么会这样?想一个班里 17 名学生的分数构成。这 17 个分数差距来自两类因素:一类是这 17 人有男有女、有不同族裔、有不同 SES,这些差异让班里学生的分数高低不同;另一类是这一班整体跟其他班相比有不同基线(老师、教室、班级氛围)。学生层变量解释第一类差异,所以压 ;但对班际基线没什么帮助,所以 几乎不动。要解释 ,得靠班级层或学校层变量,这是第 5 章的事。
组均值中心化:把"班内效应"与"班间效应"分开
学生层协变量里有一个特殊的家伙:SES。它跟性别、族裔不太一样。性别在班里比例大概 50/50,族裔比例由学校所在社区决定但跟班际差异关系不大;SES 不同,低 SES 学生在 STAR 里集中分布在某些学校与班级里,班际 SES 比例从接近 0 到接近 100% 都有。
这种集中分布带来一个值得分开看的现象——同一个 SES 变量在两个层面起作用。一个层面是学生层:"这名孩子家里享受免费午餐,相对班里同学,他自己的分数会怎样?" 另一个层面是班级层:"这个班里享受免费午餐的学生比例高,整个班级的基线会怎样?" 两个问题在数据上对应同一个变量,但在因果上是两件事。
对学生层变量 ,组均值中心化(centering within cluster,CMC)把它分解为两部分:
其中 是班级 的均值(class-mean,反映班级层信息), 是该学生相对班级均值的偏差(within-cluster,反映学生层信息)。把这两个量分别作为两个变量加进多层模型,可以让"班间效应"和"班内效应"被两个独立的系数分别估计。
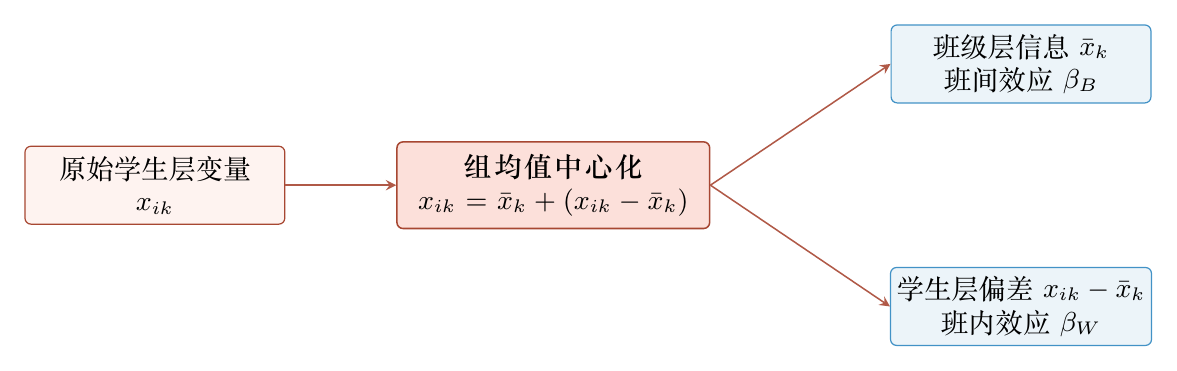
用 SES 把这个分解走一遍。ses_F 取值 0 或 1。班级 里享受免费午餐的学生比例 就是这个班的"低 SES 浓度"。某名学生的 是他相对班里 SES 平均水平的偏差——如果他享受免费午餐而班里只有 30% 的同学享受,他的组内偏差是 。
把这两个变量都加进随机截距模型:
d_cent <- d |>
  group_by(tch) |>
  mutate(ses_class = mean(ses_F)) |>
  ungroup() |>
  mutate(ses_within = ses_F - ses_class)

m_cmc <- lmer(math ~ ses_within + ses_class + (1 | tch),
              data = d_cent, REML = TRUE)
summary(m_cmc)$coefficients
#             Estimate Std. Error      df t value Pr(>|t|)
# (Intercept)  500.6      2.16   332.0  231.5  <2e-16
# ses_within   -21.60     1.27  5430.5  -16.9  <2e-16
# ses_class    -26.92     5.31   349.6   -5.1  6.1e-07

# 不分解的对照模型
m_plain <- lmer(math ~ ses_F + (1 | tch), data = d_cent, REML = TRUE)
summary(m_plain)$coefficients["ses_F", "Estimate"]
# [1] -21.89
关键看三个数字。组内 SES 效应 = :在同一个班里,享受免费午餐的孩子比同班自费同学平均低 21.6 分。组间 SES 效应 = :把整班的免费午餐比例从 0 拉到 100%,整班基线下移 26.9 分。不分解的混合系数 = ,几乎完全等于组内效应。
组间效应()比组内效应()大 5 分多。这说明"低 SES 学生集中的班级"对班里所有学生都不利——不光是低 SES 学生自己分数低,连同班的自费学生也会因为班级整体氛围、师资分配、课程难度调整等等被拉下来一截。这是教育不平等研究里反复出现的"组合效应"现象。
为什么不分解的混合系数 离组内效应 这么近,而离组间效应 远?因为加权方式偏向组内。混合系数本质上是组内效应跟组间效应的某种加权平均,权重由协变量的组内方差跟组间方差的比例决定。SES 在 STAR 里的组内方差远大于组间方差(每个班里 SES 比例不是 0 就是 1 两种极端),加权平均自然偏向组内那一边。这种"系数被组内吃掉"的现象在不分解的模型里很难诊断,往往导致研究者错把组内效应当成"个体 SES 的普遍效应"。
停下来想一想。 如果一所学校的政策制定者看到 ses_F 系数是 ,他会得到什么结论?大概是"享受免费午餐的孩子需要更多帮助"。这条结论本身没错,但漏了一半信息——把整班 SES 比例降下来(比如混合社区招生)会带来一个独立的、更大的提升。组均值中心化的价值就是把这两条政策建议分开来给。
为什么不分解会出问题:组内组间被压成单一系数
对 SES 这种"在个体和班级两个层面都有效应"的变量,模型 math ~ ses_F + (1|tch) 估出来的 是组内效应与组间效应的加权混合,权重由变量本身的组内方差与组间方差比例决定,因此这个系数在因果上没有清晰含义。
诊断方法:怀疑某个学生层变量在班级或学校层有"集中分布"现象时,先算 在班际之间的方差,再跟个体 在班内的方差比。如果班际方差占总方差超过 5%(也就是变量本身的 ICC 0.05),就应该用 CMC 拆开来跑。
记忆方法:教育与组织研究里,凡是"个体特征"跟"组成员构成"相关的变量都要警惕——SES、学习成绩、专业兴趣、年龄、工作经验。性别跟族裔在班级随机分配的情况下班际方差小,可以不拆,但严格起见也建议做一次诊断。Curran 与 Bauer 2011 年在 Annual Review of Psychology 上有一篇综述专门讲这件事的危害与处理。
CMC 这个方法在多层建模文献里有几个不同名字,含义都一样:组均值中心化、group-mean centering、within-between 分解。Raudenbush 与 Bryk 1992 年的 Hierarchical Linear Models 把它写进教科书;Snijders 与 Bosker 2012 年的 Multilevel Analysis 给了更细的指南,尤其是讨论"班级均值"作为协变量时班级人数大小对估计稳定性的影响。班级人数 太小(少于 5 人)的话班级均值估计本身就很噪声,不建议直接拿来当协变量;STAR 里每班平均 17 人,这个问题不严重。
学生层之上还有班级层与学校层
本章把学生层协变量这块讲完了。读者现在应该能复述:性别、族裔、SES 三个变量加进随机截距模型后,班级内方差 从 1,595 降到 1,516,压了 5%;班级间方差 几乎没动,因为学生层变量解释不了班际基线差异。SES 这种"在班级里集中分布"的变量值得用组均值中心化拆开,让组内效应()跟组间效应()各自有清晰系数;不拆的话两者会被压成一个 的混合数字,因果含义模糊。
但本章一直绕开了"小班 vs 常班"这件事。处理变量 cltype 是班级层变量——同一个班里所有学生共享同一个班级类型。它要进入模型,跟学生层的性别、族裔、SES 不在同一层。下一章正式把 cltype 加进来,给出本书第一个"考虑了所有学生层与班级层协变量之后"的小班效应估计。读者会看到点估计从纯朴素 OLS 的 漂到带学生协变量的 ,标准误从 1.50 涨到 3.63,跟第 2 章给出的"嵌套结构会膨胀 SE"的逻辑完全一致。第 5 章也是本书第一次更新累积对比表的章节——往后每章都会把当前模型的小班效应数字加进去,到第 10 章合并成一张终极对比。